USDC Yield With Cover Built In Quicknode Earn now runs USDC yield with cover for protocol risk built in, underwritten by OpenCover. Six covered vaults on Base.
阅读公告 区块链中的高可用性:可靠的节点与RPC |Quicknode
我们的通讯中包含丰富的免费资源、Quicknode 、Web3 洞见等内容。
CLI、Admin API 、MCP、SDK ,以及支持 80 多个区块链的原生 AI 工具。由开发者打造,专为开发者服务。
涵盖 Python、Ruby 和 JavaScript 的最新代码示例。关于智能合约、NFT 和去中心化应用(dApp)的深入指南。
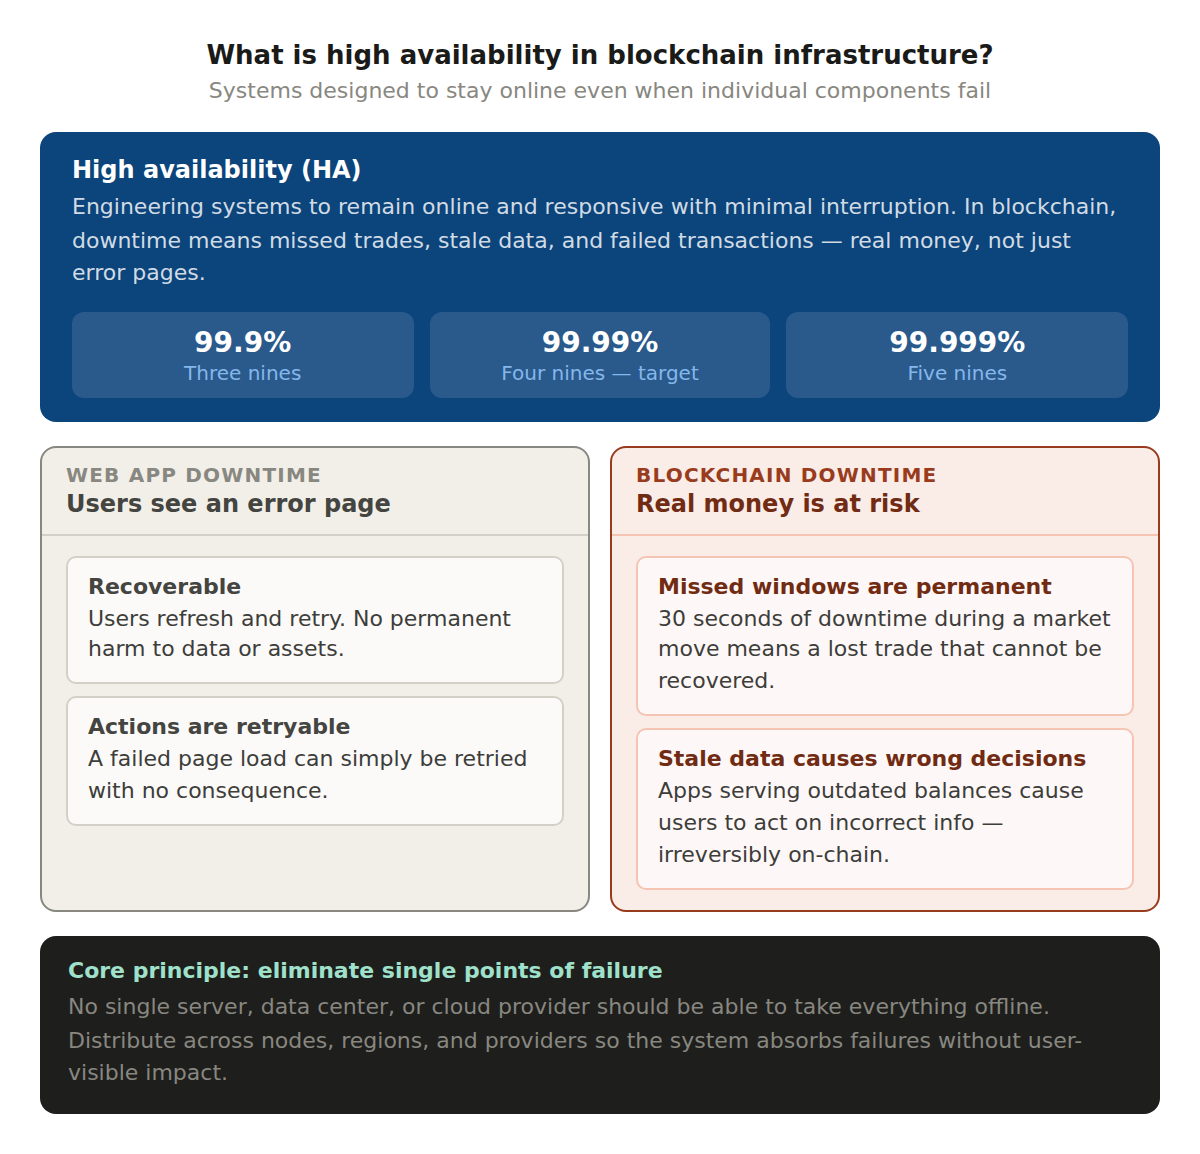
答案 > 了解可靠性与正常运行时间 > 区块链基础设施中的高可用性指什么? 简而言之: 高可用性(HA)指的是即使个别组件发生故障,系统仍能保持在线并响应请求,且停机时间降至最低的设计。 在区块链基础设施中,高可用性意味着您的 RPC 端点、节点和数据管道能够持续可靠地处理请求,通常以 99.9% 或更高的正常运行时间为目标。
当传统的网络应用出现故障时,用户会看到一个错误页面。而当区块链基础设施出现故障时,其后果可能要严重得多。交易丢失、数据过时、交易失败以及事件未处理,这些情况不仅会让用户感到沮丧,还会造成实际的经济损失。
假设有一个依赖 RPC(endpoint )提交交易的 DeFi 交易机器人。如果在市场剧烈波动期间,该endpoint 即使仅断线 30 秒,该机器人也将完全错失交易时机。再想想一款因节点提供商发生故障而无法查询余额的钱包应用。用户无从得知自己的资金是否安全,而你的客服咨询量也会激增。
高可用性是一门旨在防止此类情况发生的工程学科。它意味着设计出即使发生单一故障,也不会导致整个系统离线的系统。
区块链中的高可用性是什么? 区块链中的高可用性是指即使个别组件发生故障,也能确保节点、RPC 端点和数据管道保持在线并能正常响应。高可用性架构不会依赖单个节点或单一区域,而是将工作负载分布到冗余组件上,从而确保单个故障绝不会导致整个服务瘫痪。这在很大程度上依赖于状态良好且已同步的节点,因此节点的可靠性和 自动故障转移 是其核心组成部分。
通过 SOC 2 II 类认证 · ISO 27001
高可用性是如何实现的
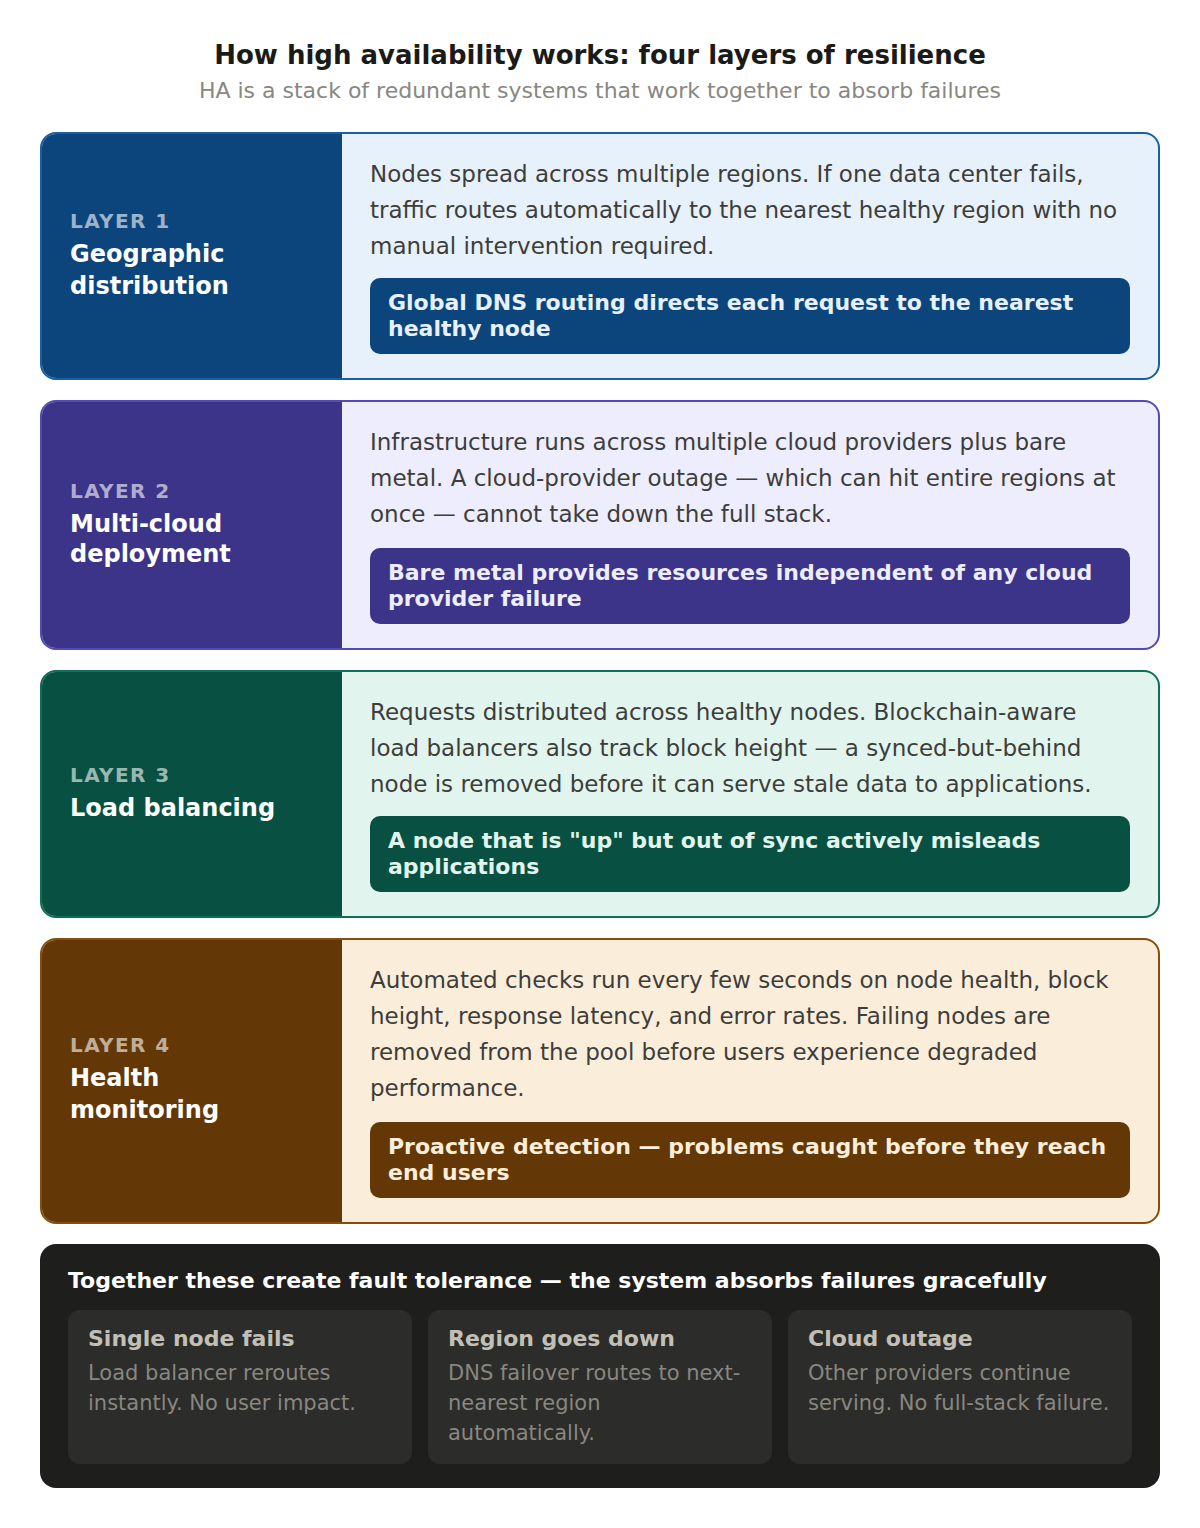
从本质上讲,高可用性(HA)旨在消除单点故障。高可用性系统不会依赖于单台服务器、单个数据中心或单一云服务提供商,而是将工作负载分布到多个冗余组件上。
在区块链基础设施中,这通常涉及多个层次。第一层是地理分布,即节点分布在多个区域,这样如果某个数据中心出现问题,流量会自动路由到最近的正常运行的备用节点。第二层是多云部署。 在多个云服务提供商(有时还包括裸金属服务器)上运行,可确保因某个云服务提供商发生故障而不会导致整个技术栈瘫痪。第三层是负载均衡,它将传入的 RPC 请求分配到一组正常运行的节点中,并自动绕过任何运行缓慢或无响应的节点。第四层是健康监测,自动化系统会持续检查节点状态、区块高度和响应时间,在问题影响用户之前就予以标记。
这些组件协同工作,形成了工程师所说的容错能力。该系统能够从容地应对故障,而非直接崩溃。
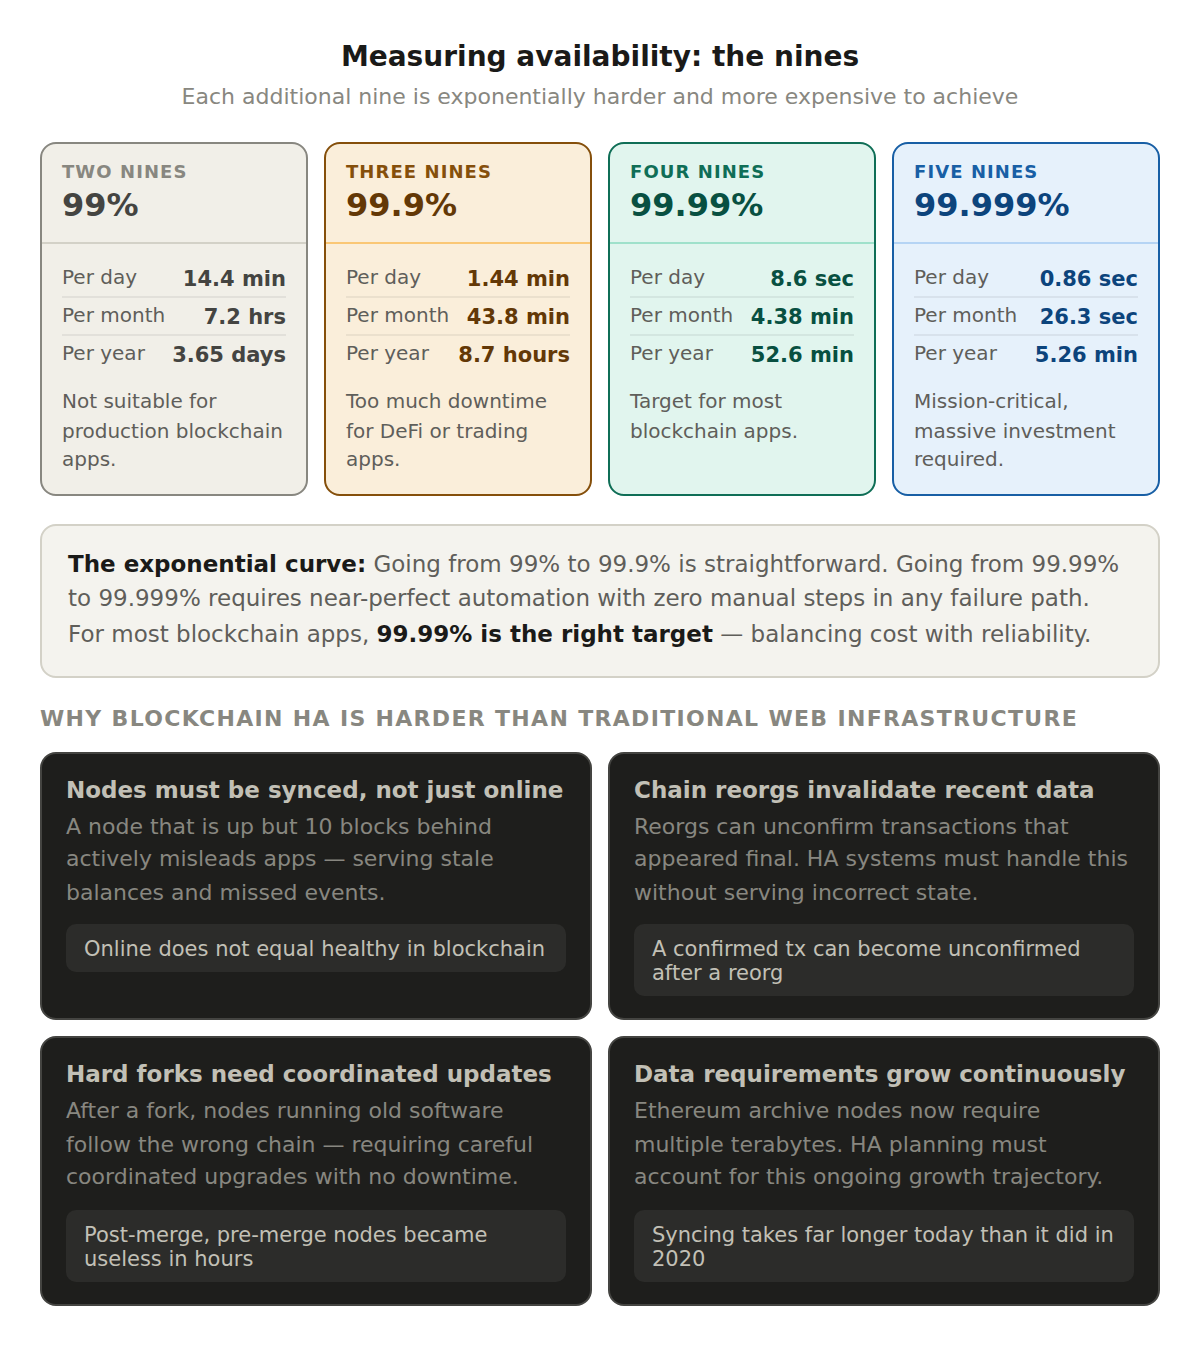
可用性的衡量 可用性通常以特定时间段内正常运行时间的百分比来表示。你经常会听到“三个九”(99.9%)或“四个九”(99.99%)这样的说法。
以下是这些数字在实际应用中的具体含义。当可用性达到99.9%时,每年大约有8.7小时的停机时间;当可用性达到99.99%时,这一数字降至每年约52分钟;而当可用性达到99.999%(五九)时,全年停机时间仅略超过5分钟。
每增加9个百分点,实现难度都会呈指数级增长,并且需要在冗余、监控和自动化方面投入更多资源。对于大多数区块链应用而言,99.99%是兼顾成本与可靠性的理想目标。
您应该将系统正常运行时间的目标设定为多少百分比? 正常运行时间目标通常以“九”为单位来描述。每增加一个“九”,允许的停机时间就会大幅减少,但实现起来所需的成本也会相应增加。下表展示了每个级别在全年实际运行中的具体含义。
正常运行时间
姓名
每年停机时间
99.9%
三个九
约8.7小时
99.99%
四九
大约52分钟
99.999%
五九
刚好5分钟多一点
高可用性与容错性有什么区别? 人们常将这两个术语混用,但它们并非同一概念。高可用性旨在将停机时间降至最低,同时允许在故障转移期间出现短暂的中断。容错性则通过并行运行完全冗余的组件,力求实现零停机。大多数区块链团队追求高可用性,因为它能在合理的成本下提供出色的运行时间。
方面
高可用性
容错性
目标
停机时间极短
零停机时间
方法
冗余加快速故障转移
并行冗余组件
成本
中等
高
典型目标
99.9% 至 99.99% 的运行时间
连续运行
区块链为何如此困难 传统的网络服务只需在负载均衡器后方启动更多服务器即可。而区块链基础设施则更为复杂,因为节点需要与网络保持同步。如果某个节点在区块高度上落后,那么即使从技术上讲它仍处于“在线”状态,实际上也毫无用处。
区块链还引入了一些传统基础设施中不存在的独特故障模式。链重组可能会暂时使近期数据失效。网络升级或硬分叉需要协调各节点的更新。不同的客户端实现方案在负载下可能会表现出不同的行为。而且数据本身在不断增长,这意味着存储和同步需求会随着时间推移而增加。
所有这些因素使得区块链的高可用性(HA)比单纯在服务器集群前部署一个负载均衡器要复杂得多。它需要对协议有深入的了解,并需要持续的运维投入。
如何设计一个高可用性的 RPC 架构? 一个具备高可用性的架构结合了多种技术:将节点分布在不同区域和提供商之间,在健康节点池前部署负载均衡器,监控区块高度和延迟以便自动移除未同步的节点,并准备好备用提供商以备故障转移。从应用程序角度来看,这仍然是一个单一的RPCendpoint ,但在其背后却有着确保系统持续在线的冗余机制。对区块链基础设施的 持续监控 ,正是实现自动路由决策的关键。
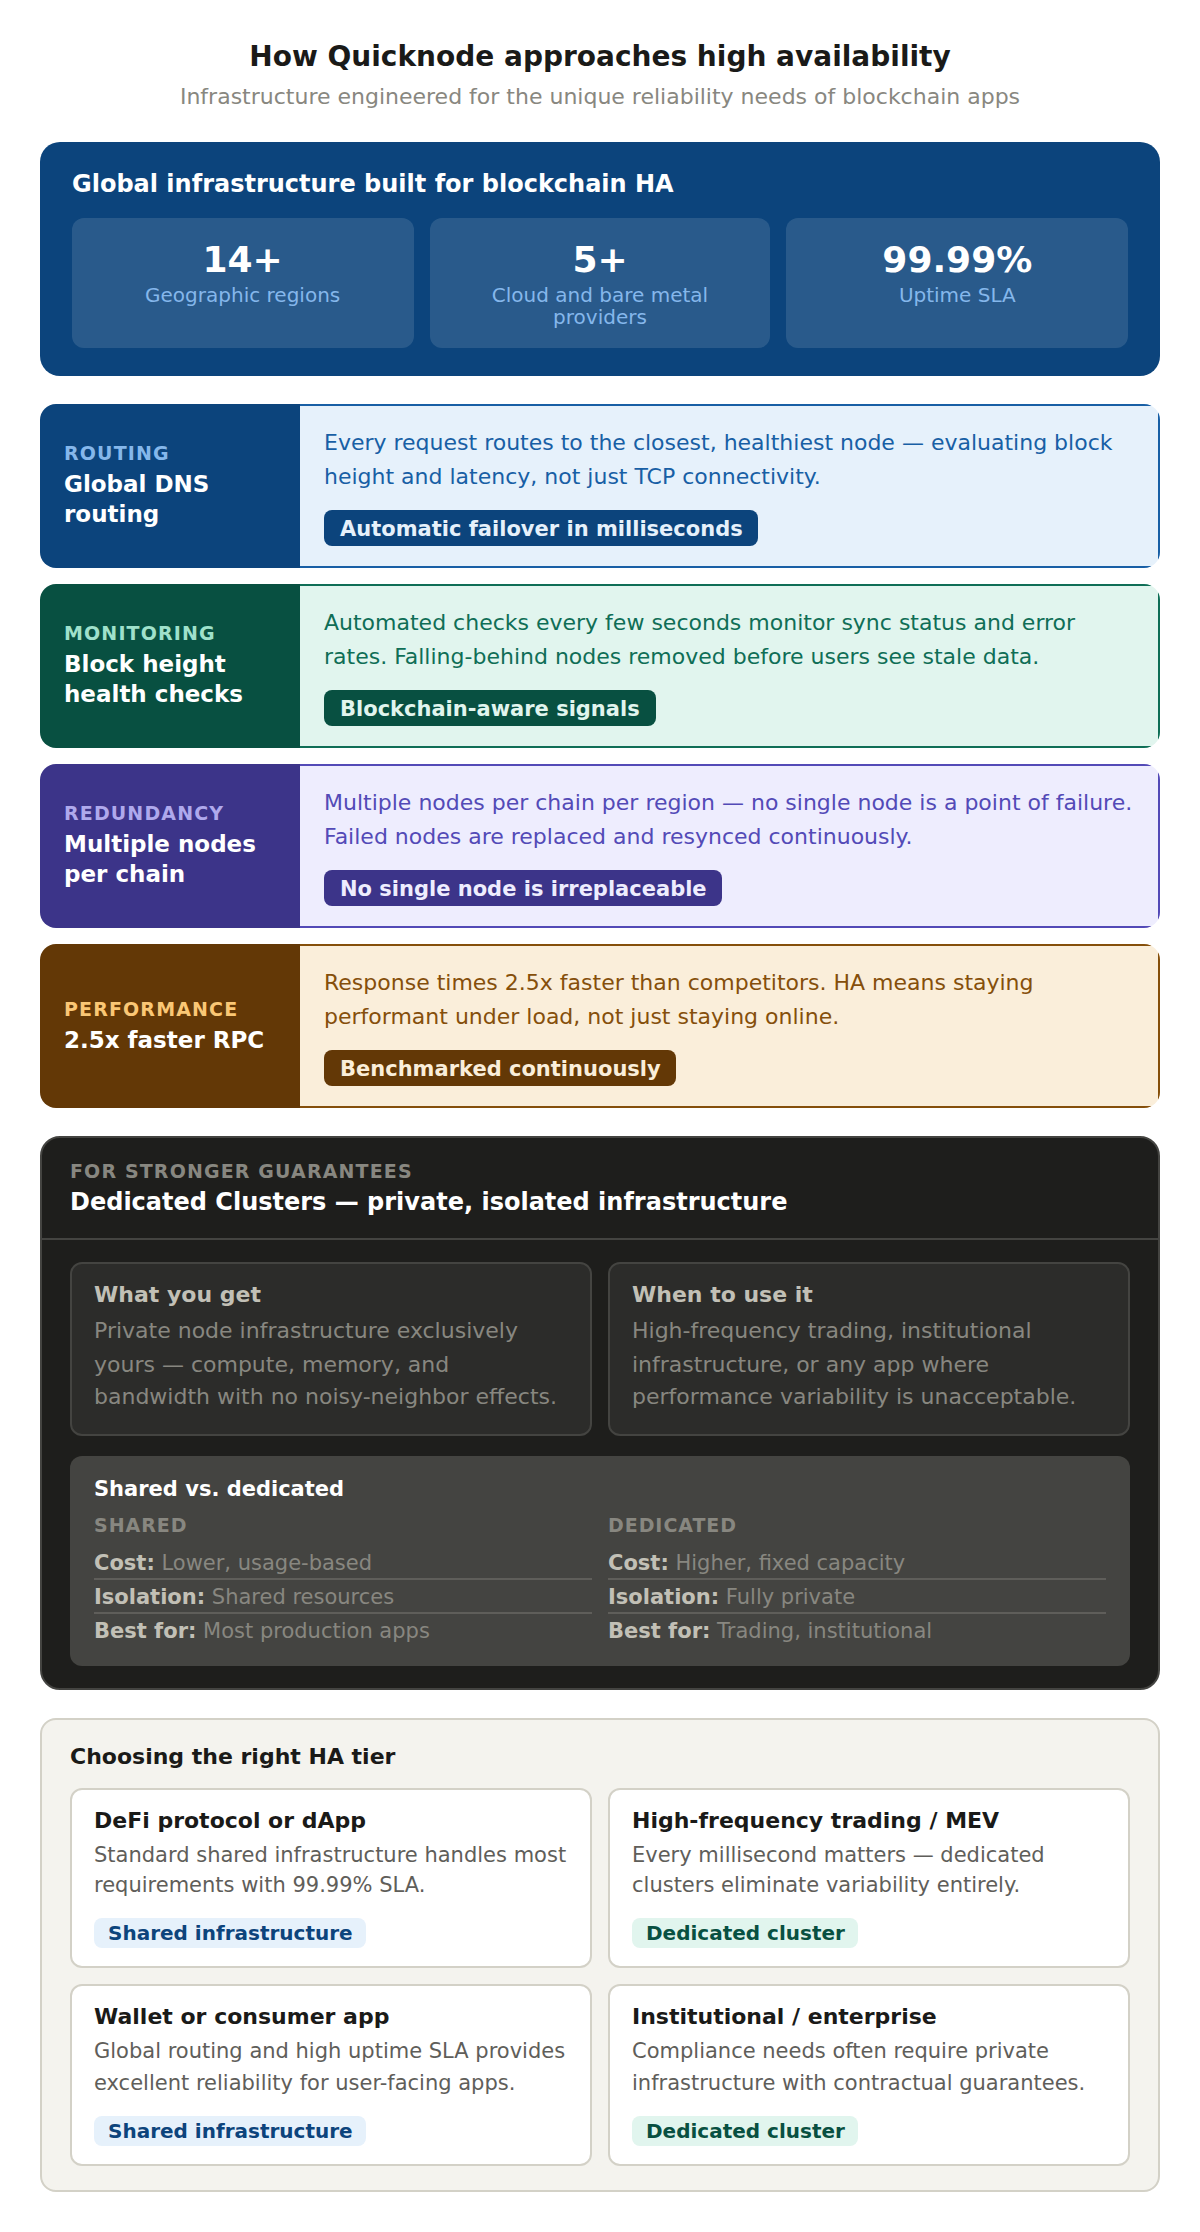
Quicknode 如何实现高可用性 Quicknode 在多个云服务和裸金属服务提供商的14个以上区域中运行基础设施。每个RPC请求都会通过基于全球DNS的路由机制被路由到最近的正常节点,且系统会持续监控区块高度、延迟和错误率,以确保请求始终落入既在线又完全同步的节点上。
对于需要更强保障的团队,Quicknode 提供了专用的clusters ,其具备私有、隔离的基础设施,并提供有保障的正常运行时间 SLA。
延伸阅读
常见问题解答
对于 RPCendpoint 而言,高可用性意味着什么? 这意味着,即使个别节点、区域或提供商发生故障,endpoint 仍能持续响应请求。流量会自动路由到状态正常且已同步的节点,因此您的应用程序将保持稳定的运行时间,而不会出现错误。
对于区块链基础设施而言,什么样的正常运行时间算好? 大多数生产应用程序的目标是实现99.99%的正常运行时间,这意味着每年允许约52分钟的停机时间。虽然达到99.999%是可行的,但这需要在冗余和自动化方面投入显著更多的成本。
为什么对区块链而言,实现高可用性比对网络应用更难? 节点必须与网络保持同步,因此,即使某个节点处于在线状态,但如果其区块高度落后于网络,仍然无法使用。区块链特有的事件也会使情况变得复杂,我们将在“常见的区块链故障模式 ”中对此进行探讨。
链重组会对可用性产生什么影响? 重组可能会暂时使最近的数据失效,因此高可用性系统会等待确认,或显式处理重组。有关详细信息,请参阅“什么是区块链重组” 。
高可用性是否意味着不再需要备份服务提供商? 不。虽然单一服务提供商的高可用性可以降低风险,但保留一家独立的备份服务提供商能帮助您防范涉及整个服务提供商的故障,这也是弹性设计中常见的组成部分。
// Publisher
Quicknode
更新于2026年6月2日
2026年3月17日 — 阅读时间6分钟