区块链基础设施监控:RPC 与节点指标 |Quicknode 🤖 新推出:《Quicknode 》AI 烹饪指南 10个经过验证的AI编程教程agents 。
查看食谱
我们的通讯中包含丰富的免费资源、Quicknode 动态、Web3行业洞察等内容。
CLI、Admin API 、MCP、SDK ,以及支持 75 多个区块链的原生 AI 工具。由开发者打造,专为开发者服务。
涵盖 Python、Ruby 和 JavaScript 的最新代码示例。关于智能合约、NFT 和去中心化应用(dApp)的深入指南。
简而言之: 监控区块链基础设施意味着要持续追踪应用程序所依赖的节点、RPC 端点和数据管道的健康状况、性能及准确性。与监控传统 Web 服务器不同,区块链监控必须考虑链特有的行为,例如区块生成速率、同步状态、最终性检查点、内存池拥塞以及 gas 价格动态。 需要跟踪的核心指标包括区块高度(节点是否处于最新状态?)、RPC 延迟(请求速度是否快?)、错误率(请求是否成功?)以及数据时效性(应用程序是否能看到最新状态?)。有效的监控应将针对即时问题的自动化告警与用于趋势分析和容量规划的仪表盘相结合。
简明解释 如果您的应用程序依赖于区块链,那么该应用程序的运行状况完全取决于将其与该区块链连接的基础设施。如果负责提供数据的 RPCendpoint 出现故障、响应滞后或开始返回错误,那么即使智能合约编写得再完美、前端设计得再精美,也毫无价值。通过监控,您才能在用户察觉之前发现问题。
传统的Web应用程序监控主要关注服务器的CPU、内存、磁盘和网络。 区块链基础设施监控不仅涵盖上述所有内容,还包含一系列传统系统中不存在的、特定于区块链的指标。节点是否已同步到最新区块?节点是在标准链上,还是卡在分叉上?RPC 响应返回的数据是否来自正确的区块高度?内存池是否拥堵到足以影响交易确认时间?正是这些区块链特有的信号,区分了稳健的监控方案与那些会遗漏关键故障模式的监控方案。
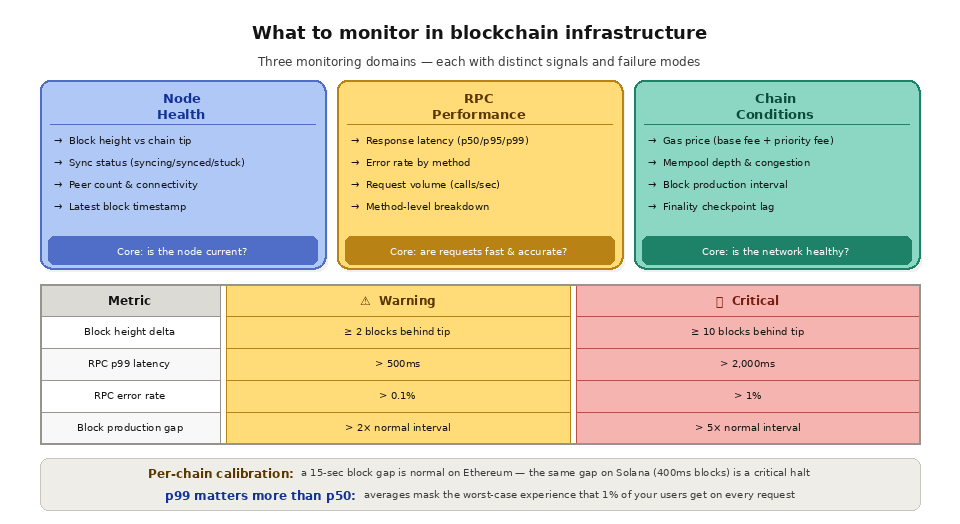
需要监控的内容 节点状态 最基本的指标是区块高度:你的节点处理的最新区块是什么,它与区块链的实际末端相比处于什么位置?如果节点落后于区块链末端(即使只落后几个区块),它提供的就是过时数据。你的应用程序可能会显示过时的余额、遗漏最近的交易,或者无法检测到已确认的事件。在像Solana (区块生成时间400毫秒)这样速度快的区块链上,即使只有轻微的同步延迟,也意味着你的应用程序比实际状况落后了多个区块。
通过 SOC 2 II 类认证 · ISO 27001
请监控您节点区块高度与区块链末端之间的差异。一个健康的节点应始终与区块链末端保持在0至1个区块的范围内。差异达到2个区块及以上即为警告信号。差异达到10个区块及以上则表明您的节点存在同步问题,需要立即排查。
同步状态表明您的节点当前是正在同步、已完全同步,还是卡住了。处于“同步中”状态且同步进度稳定良好的节点属于正常状态。如果节点显示“同步中”,但数分钟内区块高度未增加,则说明该节点已卡住,需要进行处理。
对等节点数用于统计您的节点与多少个其他节点建立了连接。一个运行正常的节点会与多个对等节点保持连接,以便进行数据传播和参与共识。对等节点数的减少可能表明存在网络连接问题或配置问题。
RPC 性能 响应延迟是指从发送 RPC 请求到收到响应之间所花费的时间。 应以百分位数(p50、p95、p99)而非平均值来追踪该指标,因为平均值会掩盖用户实际遭遇的最坏情况性能表现。若p50延迟为50毫秒,p99延迟为2,000毫秒,则意味着大多数请求响应迅速,但每100个请求中就有1个需要整整2秒。正是这些缓慢的请求会让用户感到沮丧。
错误率是指返回错误(非200的HTTP状态码、JSON-RPC错误响应或超时)的RPC请求所占的百分比。 一个运行正常的endpoint 其错误率应低于0.1%。超过1%的错误率表明存在问题,需要立即调查。常见的错误类型包括429(速率限制)、502/503(节点不可用),以及诸如“missing trie node”(存档数据不可用)或“nonce too low”(交易提交冲突)之类的JSON-RPC错误。
方法级细分会按 RPC 方法(如 eth_call、eth_getBalance、eth_sendRawTransaction 等)对指标进行分类,因为不同方法的性能特征和故障模式各不相同。eth_getLogs 的延迟骤增可能表明节点在日志过滤方面遇到困难,而 eth_sendRawTransaction 错误的骤增则可能表明内存池(mempool)出现拥塞。
链条件 对于任何提交交易的应用程序而言,跟踪Gas价格都至关重要。监控基础手续费和优先级手续费的走势,有助于您的应用程序估算合适的Gas价格,避免在网络不拥堵时支付过高费用,并在网络拥堵导致交易成本上升时向用户发出提醒。
内存池深度反映了有多少笔待处理交易正在等待被纳入区块。内存池深度的增加预示着网络拥堵加剧,这意味着手续费会上涨,确认时间也会变长。需要可预测交易确认时间的应用程序应监控内存池深度,并据此调整其行为。
区块生成速率因链而异,且在网络出现问题时可能会波动。监控区块生成间隔有助于在链速变慢或停滞影响应用程序功能之前及时发现问题。
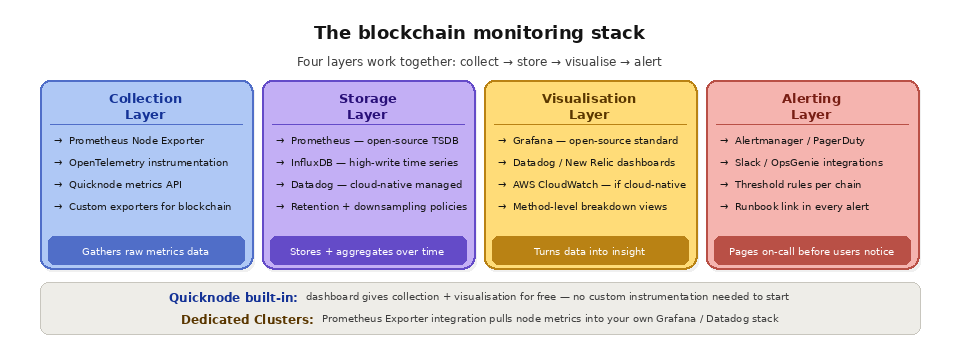
设置监控 一个标准的区块链基础设施监控架构由采集层、存储层、可视化层和告警层组成。
采集层负责从您的基础设施中收集指标。对于自托管的节点,Prometheus Node Exporter 和自定义指标导出器等工具会收集系统指标和区块链特定指标。对于托管端点,大多数服务商都提供基于 API 或 webhook 的指标访问方式。应用层指标可通过 OpenTelemetry、StatsD 或服务商专有的 SDK 进行采集。
存储层是一种针对指标数据进行优化的时间序列数据库。Prometheus、InfluxDB 和 Datadog 是最常见的选择。时间序列数据库专为指标数据的高写入量和时间顺序特性而设计,并内置了对聚合、降采样和保留策略的支持。
可视化层将原始指标转化为可操作的仪表盘。Grafana 是开源监控可视化领域的行业标准,原生支持 Prometheus、InfluxDB 以及其他数十种数据源。Datadog、New Relic 和 AWS CloudWatch 则将其集成可视化功能作为监控平台的一部分提供。
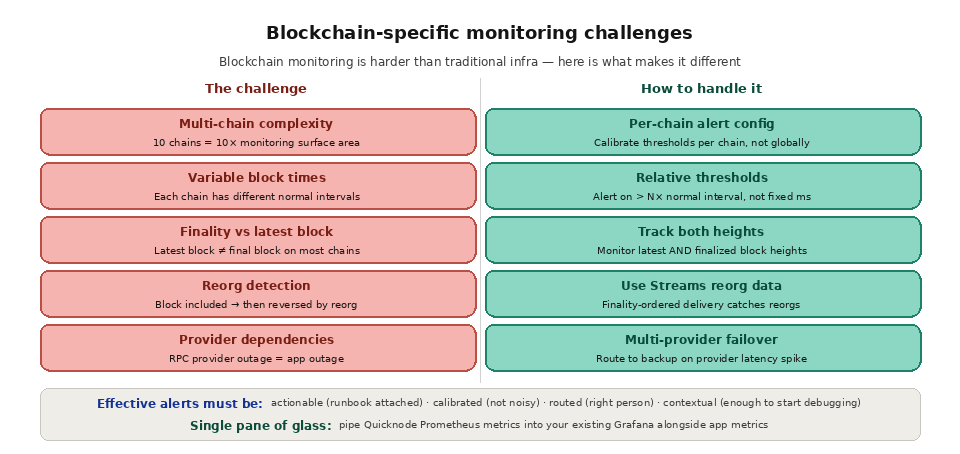
告警层会根据阈值评估指标,并在需要关注时通知相关人员。 有效的警报应具备可操作性(每条警报都应配有相应的操作手册)、经过精细调优(既不能过于敏感导致频繁触发,也不能过于宽松以致漏报真实问题)、具备路由功能(通过 PagerDuty、Slack 或类似工具发送给值班人员),并具有情境相关性(包含足够的信息,以便无需打开仪表盘即可开始排查问题)。
区块链特有的监控挑战 多链环境会成倍增加监控的复杂性。如果您的应用程序支持 10 条链,您就需要分别跟踪每条链的节点健康状况、RPC 性能以及链状态。每条链的区块生成时间、最终性模型和故障模式各不相同。一套在Ethereum 上运行完美的监控方案,可能会遗漏Solana 上的关键信号,反之亦然。
区块生成时间的不确定性使得设置静态警报阈值变得更加困难。Ethereum 区块之间出现15秒的间隔属于正常现象。而在Solana (该链上区块应每400毫秒生成一次)上出现15秒的间隔则是一个严重问题。警报需要针对每条链分别校准,而非统一设置。
对数据管道的监控而言,最终性意识至关重要。监控不仅应追踪节点所看到的最新区块,还应追踪最新的最终确认区块。尚未达到最终性的区块中的数据可能会因重组而被逆转,因此,依赖最终确认数据的应用程序需要能够区分最新区块高度与最终确认区块高度的监控机制。
需要跟踪的最重要的区块链监控指标有哪些? 少数几个高信号指标就能发现绝大多数区块链基础设施问题。下表总结了每个指标所反映的信息、表明系统运行正常的数值范围,以及何时应联系值班工程师。
公制
测量内容
健康范围
何时发出警报
区块高度差
距链条末端的距离
0 至 1 个街区范围内
落后10个街区或更多
RPC 延迟(p99)
响应速度最慢的1%
小于 500 毫秒
超过2秒
错误率
请求失败的比例
低于0.1%
高于1%
对等节点数
已连接的网络对等方
稳定,高于客户最低要求
突然或持续的下降
Mempool深度
待处理交易正在等待中
链条保持稳定
快速、持续的增长
数据时效性
最新返回状态的生存时间
才几秒钟
开球前几分钟
请将这些指标作为时间序列而非单次读数进行追踪,以便在故障发生前及时发现趋势。特别是延迟,应以百分位数的形式进行测量:了解更多关于RPC延迟的 成因,以及它如何融入更广泛的区块链可观测性体系 。
区块链监控与传统基础设施监控有何不同? 标准的服务器监控只能告诉你一台机器是否在线,但区块链节点即使通过了所有基础设施检查,也可能在暗中提供过时或已被重组 的数据。区块链监控是在常规主机指标的基础上,叠加了具有链意识的信号。
方面
传统的基础设施监控
区块链基础设施监控
主要健康指标
CPU、内存、磁盘、网络
区块高度、同步状态、最终性
常见故障mode
服务器宕机或负载过高
节点在线,但提供过时或已重组的数据
正确性风险
服务器响应后,值变为低
有效数据可能会因重组而发生逆转
延迟基准值
按服务收取固定费用
因区块链和 RPC 方法而异
范围
一摞
跨多个链,每条链仅需一次配置
最大的区别在于随时间推移的正确性。一个响应在返回时可能是准确的,但几秒钟后就可能失效,因此监控应区分最新区块和已最终确定的区块。关于这一区别为何对数据管道至关重要,请参阅“区块链最终性” 。
不运行自己的节点,能否监控区块链基础设施? 是的。托管型 RPC 提供商无需您进行任何监控配置,即可提供有关请求量、延迟和错误率的仪表盘及指标,从而消除了自建监控系统带来的大部分运维负担。这通常是实现高可用性的 最快途径,因为提供商会为您处理节点健康状态、扩展和冗余等事宜。Quicknode 的Core API 开箱即用,自带基于endpoint 的分析功能,因此您从第一个请求开始就能全面掌握基础设施的运行状况。
如何监控多链区块链基础设施? 多链监控意味着需要针对每条链分别校准阈值,因为在Ethereum 上属于正常范围的延迟,在亚秒级链上可能构成严重事件。将每条链的指标集中到一个仪表盘中,并根据每条链的基准值触发警报。对于数据管道, Quicknode Streams 会按链报告交付成功率及处理延迟,让您在某条链出现延迟时立即知晓。
常见问题解答
应该多久对区块链基础设施进行一次监控? 持续进行。每隔几秒收集区块高度和延迟数据,并在near 中实时评估告警规则。高速链每秒会产生多个区块,因此一分钟的轮询间隔可能会掩盖一个已经严重滞后的节点。将较短的采集间隔与指标、日志和追踪 这三大支柱相结合, 以实现全面覆盖。
什么样的RPC错误率算好? 一个健康的endpoint 其错误率应低于 0.1%。如果错误率超过 1%,则表明存在实际问题,例如速率限制、节点不可用或存档数据缺失。请务必按方法对错误进行分类,以便您能够查明哪些调用失败以及失败的原因。
“最新区块监控”和“最终区块监控”有什么区别? 最新区块是指你的节点所观察到的最新区块,而已确认区块则已达到不会被回滚的状态。依赖已结算数据的应用程序应在区块高度达到已确认状态时发出警报,因为未确认区块中的数据在重组过程中可能会消失。
如何监控区块链节点的停机情况? 同时跟踪块高度变化、对等节点数量和错误率,并将警报转发至值班渠道。将监控与强有力的节点可靠性 措施及自动故障转移相结合,可确保一旦某个节点性能下降,流量立即切换至状态良好的节点。
使用哪些工具来监控区块链基础设施? 常见的开源技术栈包括:Prometheus 用于数据采集和存储,Grafana 用于仪表盘,Alertmanager 用于警报路由。托管服务商提供了内置的分析功能,而专用Clusters 则可将节点级指标直接导出到现有的 Prometheus 或 Datadog 环境中。
Quicknode 如何提供监控功能 Quicknode 为每个endpoint 提供了内置的监控和分析功能。Quicknode 仪表盘会显示实时和历史指标,包括请求量、响应延迟、错误率以及按方法细分的统计数据。这些指标无需任何自定义监控代码即可获取,使开发人员能够立即了解其区块链基础设施的运行状况。
对于已具备监控基础设施的团队,Quicknode 的专用Clusters 支持与Prometheus Exporter集成。这使您能够将节点级和endpoint 级指标直接导入Prometheus实例、Grafana仪表盘或Datadog,从而在单一平台上实现应用程序堆栈与区块链基础设施的统一监控。专用Clusters 还提供14天的日志保留功能,以便进行详细的请求级分析。
Quicknode Streams 提供数据管道健康状况监控,包括交付成功率、处理延迟和错误日志。对于运行多链数据管道的团队,Streams 监控可确保您在数据缺失影响应用程序之前,及时发现管道出现延迟或交付问题的情况。
延伸阅读 // Publisher
Quicknode
更新于2026年6月2日
2026年3月20日 — 阅读时间11分钟