🤖 新推出:《Quicknode 》AI 烹饪指南 10个经过验证的AI编程教程agents 。
查看食谱 通过 SOC 2 II 类认证 · ISO 27001
简而言之:指标、日志和追踪是可观测性的三种基本数据类型,在理解系统行为方面各司其职。指标是随时间推移跟踪的聚合数值测量结果,非常适合用于仪表盘、告警和趋势分析。日志是带有时间戳的单个事件记录,最适合用于调试特定事件和维护审计轨迹。 追踪则追踪单个请求在分布式系统中的完整路径,揭示时间消耗的具体位置以及瓶颈的所在。实际上,这三者是相互配合的:指标触发告警,日志提供错误详情,而追踪则展示失败请求路径的完整上下文。要实现区块链应用的有效可观测性,必须具备这三大支柱,因为区块链基础设施的分布式特性会产生某些故障模式,仅凭单一数据类型无法单独诊断。
简明解释
试想一下诊断某种疾病的情景。你的生命体征(心率、血压、体温)是指标:它们告诉你某些指标出现了异常。你的病历和检查结果是记录:它们提供了具体情况的详细信息。磁共振成像(MRI)或计算机断层扫描(CT)则是影像:它呈现出完整的内部图像,使医生能够精确定位问题所在。
在区块链基础设施中,您也会面临同样的诊断挑战。您的应用程序分布在前端、后端、RPC 端点、区块链节点以及区块链本身之中。每一层都可能独立发生故障或性能下降。指标会告诉您出了问题(延迟骤升)。 日志会告诉你出了什么问题(某个特定的 RPC 方法返回了错误)。追踪信息会告诉你问题源于请求路径的哪个位置(节点处理针对复杂合约的 eth_call 耗时 3 秒)。
监控与可观测性有什么区别?
监控与可观测性虽有关联,但有所区别。监控是监视已知的信号,并在超过预定义阈值时发出提示。可观测性则是一种更广泛的能力,它允许您利用系统生成的数据对系统提出新的问题,甚至针对那些您未曾预料到的问题。指标、日志和追踪是可观测性的基础:它们共同帮助您从“出了问题”这一认知,深入到“具体原因就在这里”的理解。如需更深入的入门指南,请参阅我们的概述:
.
指标、日志和跟踪有何区别?
每个支柱都针对不同的问题,且成本各不相同。下表总结了何时应采用每个支柱。
维度 | 指标 | 日志 | 痕迹 |
|---|
数据类型 | 汇总数据 | 带时间戳的事件 | 关联请求跨度 |
最佳问题 | 有什么问题吗? | 哪里出错了? | 问题出在哪里? |
仓储成本 | 低 | 高 | 中等,通常为抽样 |
最适合 | 仪表盘和警报 | 根本原因排查 | 延迟与瓶颈分析 |
工具示例 | Prometheus、Grafana | ELK、Loki、Splunk | OpenTelemetry、Jaeger |
对于区块链系统而言,这些支柱建立在更广泛的基础设施监控之上,该监控负责监测节点的健康状况、同步状态以及 RPC 行为。
指标详解
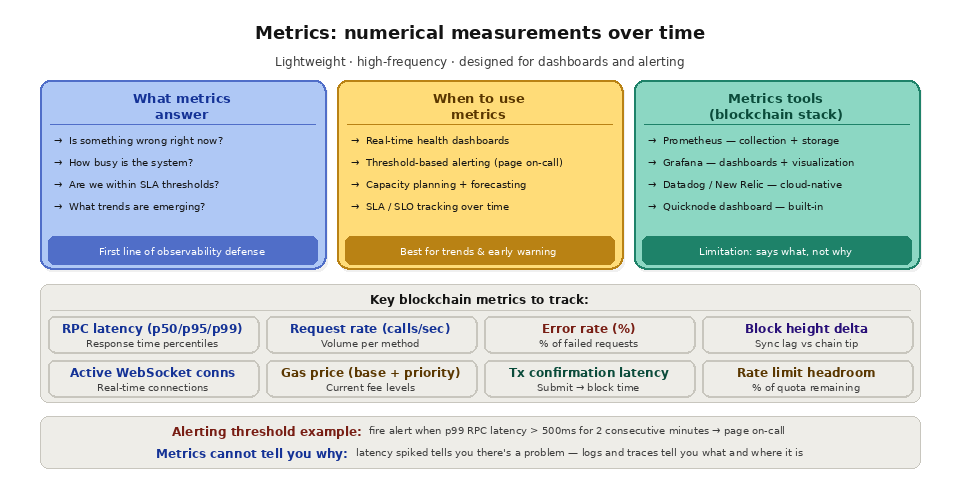
指标是定期采集并随时间聚合的数值。它们体积小、存储效率高,且专为高频采集而设计。典型的区块链应用会跟踪以下指标:RPC请求率(按方法计算的每秒请求数)、响应延迟(p50、p95、 p99分位数)、错误率(返回非200状态码的请求占比)、区块高度差(节点最新区块与链尖之间的差异)、活跃的WebSocket连接、Gas价格(当前基础费率和优先费率水平)以及交易确认延迟。
指标是可观测性的第一道防线。它们为实时仪表盘提供数据支持,让您能够一目了然地了解系统是否运行正常。当某项指标超出阈值时,它们会触发告警规则,通知值班工程师。此外,通过展示资源使用情况和流量模式的长期趋势,它们还能为容量规划提供依据。
区块链生态系统中的标准指标堆栈通常包括用于数据采集和存储的Prometheus、用于可视化和仪表盘展示的Grafana,以及用于告警路由的Alertmanager或PagerDuty。云原生替代方案包括Datadog、New Relic和AWS CloudWatch。所有这些工具都旨在处理指标数据的大数据量和时间序列特性。
指标的局限性在于其汇总性质。一个指标只能告诉你 p99 RPC 延迟超过了 500 毫秒,但无法告诉你具体是哪些请求变慢了、这些请求的参数是什么,以及在变慢时节点正在执行什么操作。若要获取这一级别的详细信息,你需要日志和追踪数据。
日志详情
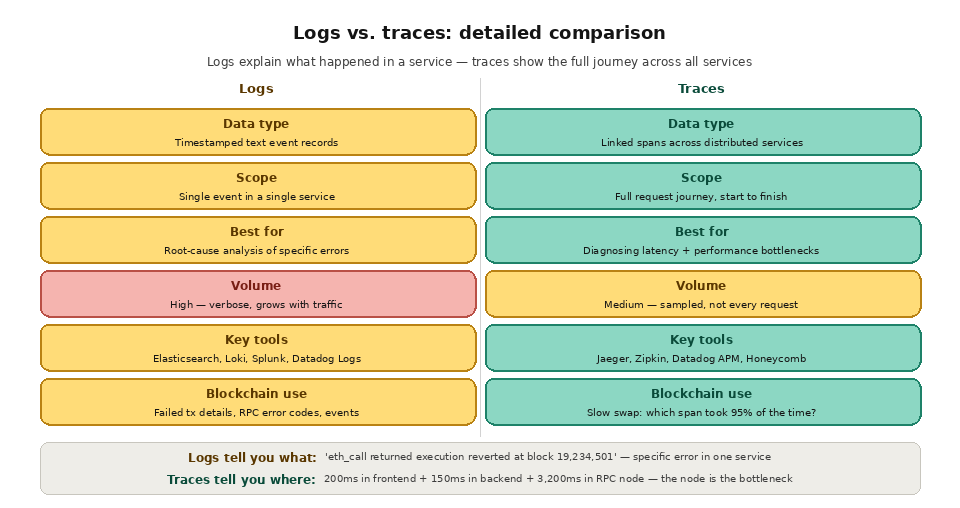
日志是带有时间戳的、记录单个事件的文本记录。每当您的应用程序发起 RPC 调用、处理事务、遇到错误或处理用户操作时,日志条目都会记录相关细节。与指标(即按时间间隔聚合的数值)不同,日志是包含丰富上下文信息的独立记录:完整的请求参数、精确的错误信息、堆栈跟踪、用户 ID 以及事务哈希。
在区块链应用中,关键日志类别包括 RPC 请求日志(方法、参数、响应代码、每次请求的延迟)、交易生命周期日志(哈希值、状态从“待处理”到“已确认”再到“已最终确定”的转换), 智能合约事件日志(来自智能合约的解码事件及完整的参数数据)、错误日志(RPC 错误、超时异常、随机数冲突、Gas 估算失败)以及应用程序日志(用户身份验证事件、业务逻辑决策、状态变化)。
日志是进行根本原因分析的主要工具。当指标提示错误率上升时,你可以查询日志中的近期错误条目,按错误类型进行筛选,并找出其中的规律。也许某个特定的 RPC 方法开始返回“缺失 trie 节点”错误,是因为该节点修剪了状态数据;也许事务提交失败,是因为并发处理漏洞导致的随机数冲突。日志中包含了指标无法提供的具体细节。
日志管理工具包括 Elasticsearch 搭配 Kibana(即“ELK 堆栈”)、Grafana Loki、Splunk、Datadog Logs 以及 AWS CloudWatch Logs。这些工具能够大规模地存储、索引和搜索日志条目,支持全文搜索、结构化查询以及跨服务关联分析。
日志记录的权衡在于存储量和成本。对于高流量应用程序,对每个 RPC 请求进行日志记录会每天产生数千兆字节的数据。与非结构化文本日志相比,结构化日志(即日志条目以 JSON 格式呈现且字段名称保持一致)能够实现更高效的索引和查询;而日志采样(仅记录部分常规事件)则可在不影响对错误和异常的可见性的前提下,有效减少日志量。
《细细追踪》
追踪记录了单个请求在分布式系统中的端到端流程。一个追踪由多个跨度组成,每个跨度代表特定服务中的一个工作单元。跨度呈分层嵌套结构(父跨度代表整个请求,子跨度代表每个子操作),并通过共享的追踪 ID 相互关联。
对于一个区块链应用程序,单个追踪可能捕获以下跨度:用户在浏览器中点击“交换”(swap)(前端跨度,50毫秒),前端向后端发送API请求(网络跨度,20毫秒),后端调用RPCendpoint 进行gas估算 (RPC 跨度,150 毫秒),后端调用 RPC 接口endpoint 进行交易提交(RPC 跨度,200 毫秒),后端轮询交易确认(多个 RPC 跨度,总计 12,000 毫秒),后端向前端发送确认(网络跨度,15 毫秒),以及前端更新 UI(前端跨度,30 毫秒)。 该跟踪记录显示,总时间的95%都耗费在等待链上确认上,而非应用程序自身的任何代码中。
分布式追踪的实现方式是:在请求流经系统时,将追踪上下文(包括追踪 ID 和跨度 ID)注入到每个请求中。每个服务都会为其自身的工作创建跨度,并将追踪上下文传递给下游服务。OpenTelemetry 等追踪库为大多数编程语言和框架提供了标准化的instrumentation。Jaeger、Zipkin 和 Datadog APM 等可视化工具会以瀑布图的形式展示追踪信息,显示每个跨度的耗时和嵌套关系。
在分布式架构中,跟踪信息对于诊断延迟问题最为宝贵。当用户反映某笔交易耗时 30 秒才得到确认时,跟踪信息会准确显示这 30 秒的具体去向:25 秒用于等待区块纳入,3 秒用于 RPC 调用,1.5 秒用于后端处理,500 毫秒用于前端渲染。 您可以立即判断出优化后端代码无济于事;瓶颈在于区块链层级的确认时间。
三者结合使用
这三个支柱是相辅相成的,而非相互竞争的。典型的事件响应工作流会同时运用这三个支柱。
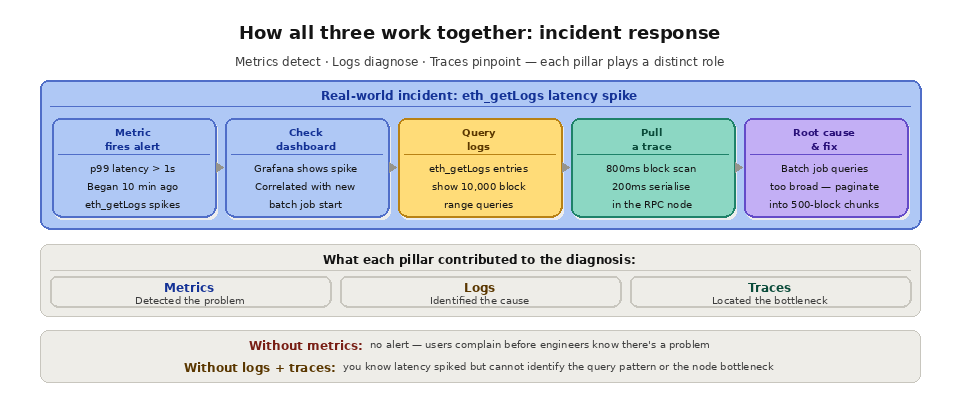
一个指标警报触发:p99 RPC 延迟已超过 1 秒。您打开 Grafana 仪表盘,发现延迟飙升始于 10 分钟前,且与 eth_getLogs 调用的激增存在关联。您查询日志以查找最近的 eth_getLogs 请求,发现此时有一个新的批处理作业启动,该作业执行了范围广泛的日志查询,每次查询覆盖 10,000 个区块。 你提取了其中一个请求的跟踪信息,发现 RPC 节点花费了 800 毫秒扫描区块,并花费了 200 毫秒序列化响应。根本原因很明确:批处理任务中过于宽泛的日志查询占用了不成比例的节点资源。解决方法是将查询分页,划分为更小的区块范围。
如果没有指标,你直到用户投诉才会发现问题。如果没有日志,你虽然能知道延迟增加了,却无法确定是哪条请求导致的。如果没有追踪信息,你虽然能知道 eth_getLogs 运行缓慢,却无法判断瓶颈是在应用程序、网络还是节点的区块扫描过程中。
应该从哪一支柱开始?
如果你正在从零开始构建可观测性,建议先从指标入手,因为指标的采集成本低,且能通过仪表盘和告警功能立即揭示问题。接下来添加结构化日志,以便对指标揭示的问题进行排查。当你的系统涉及多个服务,且需要精确定位延迟累积的位置时,再引入分布式追踪。就区块链而言,将分布式追踪与RPC延迟跟踪相结合,可以覆盖生产环境中最可能给你带来意外的层级。
Quicknode 如何支持这三大支柱
Quicknode该仪表盘为每个endpoint 提供了内置指标:请求量、响应延迟、错误率以及按方法细分的统计数据。这些指标使开发人员无需进行自定义监控,即可立即对区块链基础设施层进行可观测性分析。
对于将区块链指标集成到现有可观测性架构中的团队,Quicknode 的专用Clusters 支持 Prometheus Exporter,可将节点级指标直接导入 Prometheus、Grafana、Datadog 或任何兼容系统。这使得应用程序指标与区块链基础设施指标能够实现统一的仪表盘展示。
Quicknode Streams 为数据管道的健康状况提供可观测性,包括传输指标、处理状态和错误报告。结合 RPC 分析以及您自己的应用层日志和追踪功能,Quicknode 为开发人员提供了全面的可观测性视图,有助于诊断和解决区块链技术栈各层的问题。
常见问题解答
指标、日志和跟踪与监控是一回事吗?
不。它们是底层数据类型。监控是指观察预定义的信号并据此触发警报,而可观测性则是利用这三种数据类型来排查那些事先无法预见的问题。
这三样中,哪一样存储成本最高?
日志通常成本最高,因为它们会以最详细的方式记录每个单独的事件。指标由于采用了聚合处理,因此成本最低;而跟踪则介于两者之间,因为它们通常是通过对请求进行采样获得的,而不是对每个请求都进行完整捕获。
对于一个小型应用程序,我需要这三样吗?
起初并非如此。大多数团队最初只关注指标和基本日志。当请求涉及多个服务,且难以将延迟归因于某个特定组件时,分布式追踪才显得有价值。
什么是 OpenTelemetry?
OpenTelemetry 是一项开放标准,也是一组库,用于以供应商中立的方式生成指标、日志和追踪信息。它允许您只需进行一次instrumentation,即可将数据导出到 Prometheus、Jaeger 或 Datadog 等多种后端系统。
这具体如何应用于区块链 RPC 呢?
RPC 调用是导致延迟和错误的常见原因,因此通过将请求速率、延迟百分位数和错误代码作为指标进行跟踪,在日志中记录失败的调用,并对低效请求进行端到端追踪,可以让你全面掌握情况。如我们在《Node.js 可靠性指南》中所述,可靠的 Node.js 基础设施可以从源头上减少你需要诊断的故障。
延伸阅读