En resumen: Para acceder a los datos históricos de la cadena de bloques se necesita un nodo de archivo (que almacena todas las instantáneas del estado desde el génesis) o una herramienta de rellenado de datos que recupere y almacene bloques anteriores en una base de datos consultable. Los nodos completos estándar solo conservan los 128 bloques más recientes de datos de estado y eliminan todo lo anterior, por lo que consultar el saldo de un monedero de hace seis meses en un nodo completo no funcionará. Los dos enfoques principales son el acceso RPC a un nodo de archivo para consultas de estado en un momento determinado y el rellenado en tiempo real para crear bases de datos históricas exhaustivas.
La explicación sencilla
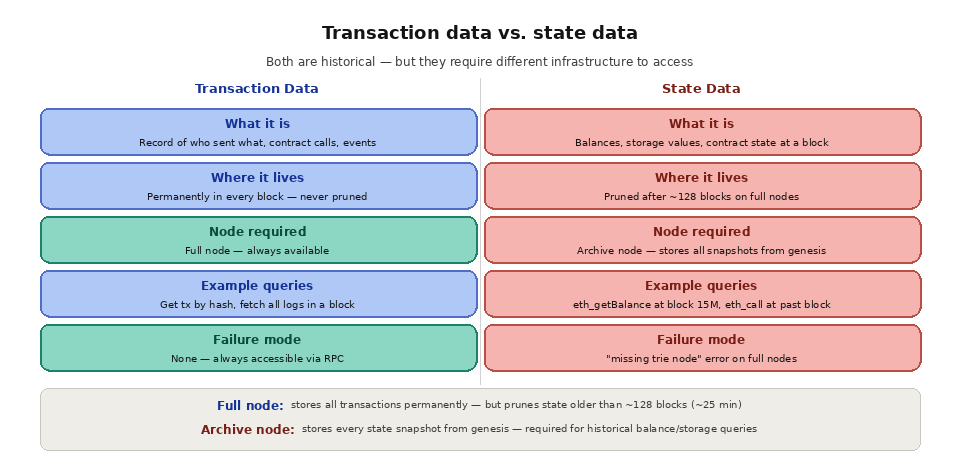
Las cadenas de bloques registran todas las transacciones que se han producido hasta la fecha, pero eso no significa que se pueda acceder fácilmente a todos los datos históricos. La distinción radica entre los datos de transacción y los datos de estado. Los datos de transacción (el registro de quién envió qué a quién, qué contratos se ejecutaron, qué eventos se emitieron) son permanentes y están disponibles en cada bloque. Los datos de estado (los saldos, los valores almacenados y los estados de los contratos en un momento dado) constituyen una « story » diferente.
Los nodos completos, que son los nodos estándar con los que operan la mayoría de los proveedores de RPC, almacenan el historial completo de bloques y transacciones, pero solo mantienen el estado actual y una ventana móvil de instantáneas recientes del estado (normalmente los últimos 128 bloques en Ethereum, aproximadamente 25 minutos). Eliminan los datos de estado más antiguos para ahorrar espacio de almacenamiento. Esto significa que un nodo completo puede indicarte qué transacciones tuvieron lugar en el bloque 15 000 000, pero no puede indicarte cuál era el saldo de un monedero en el bloque 15 000 000, a menos que dicho bloque se encuentre dentro de la ventana de retención reciente.
Cuando tu aplicación envía una llamada RPC como «eth_getBalance» con un número de bloque histórico a un nodo completo, el nodo devuelve un error de «nodo trie ausente» porque los datos de estado de ese bloque se han podado. Esta es la sorpresa más habitual con la que se encuentran los desarrolladores cuando empiezan a trabajar con datos históricos. La cadena de bloques «recuerda» todo, en el sentido de que se registran todas las transacciones, pero recuperar el estado en un momento arbitrario del historial requiere una infraestructura especial.
¿Cuál es la diferencia entre un nodo completo y un nodo de archivo?
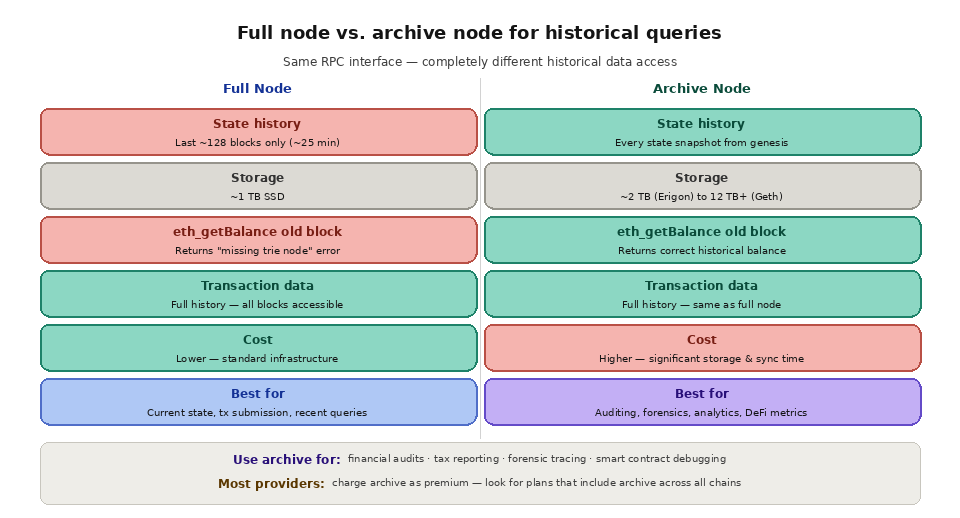
La forma más rápida de entender el acceso a los datos históricos es comparar los dos tipos de nodos que utilizan la mayoría de los proveedores. Un nodo completo conserva el historial completo de bloques y transacciones, pero elimina los estados antiguos, mientras que un nodo de archivo conserva todas las instantáneas del estado histórico. Si solo necesitas datos recientes, un nodo completo es más barato y rápido, pero las consultas sobre el estado histórico en un momento determinado requieren un nodo de archivo. Para obtener un análisis más detallado, consulta nuestra guía sobre la diferencia entre un nodo completo y un nodo de archivo, así como la descripción general de qué es un nodo de cadena de bloques.
Capacidad | Nodo completo | Nodo de archivo |
|---|---|---|
Retención estatal | Últimos ~128 bloques (unos 25 minutos en Ethereum) | Todos los estados, desde el origen hasta el más reciente |
Espacio de almacenamiento | Aproximadamente 1 TB en Ethereum | 12 TB o más en Ethereum |
Consultas sobre el historial del estado | Da error por falta de un nodo en el árbol trie | Devuelve el estado en cualquier altura de bloque |
Nodos de archivo para consultas de un momento concreto
Los nodos de archivo resuelven el problema de la poda de estados conservando todas las instantáneas de estado desde el bloque génesis en adelante. Un nodo de archivo Ethereum almacena más de 12 TB de datos, frente a los aproximadamente 1 TB de un nodo completo, lo que hace que su funcionamiento y mantenimiento resulten considerablemente más costosos. Sin embargo, ofrece una capacidad fundamental: consultar el estado exacto de cualquier cuenta, contrato o espacio de almacenamiento en cualquier altura de bloque histórica.
Esto resulta esencial para una amplia variedad de casos de uso. La auditoría financiera requiere reconstruir los saldos de las cuentas en fechas concretas. La declaración de impuestos debe determinar el valor de las participaciones al cierre del ejercicio. El análisis forense rastrea el « flow » de los fondos a través de las transiciones de estado históricas. La depuración de contratos inteligentes utiliza el estado histórico para reproducir y analizar errores o vulnerabilidades pasadas. El análisis de protocolos DeFi calcula el TVL, el APY y otras métricas históricas consultando los estados de los pools en alturas de bloque pasadas.
Gestionar tu propio nodo de archivo consume muchos recursos. La sincronización inicial lleva semanas, los costes de almacenamiento son elevados y el nodo requiere un mantenimiento continuo, actualizaciones de los clientes y supervisión. La mayoría de los equipos acceden a los datos de archivo a través de proveedores de infraestructura, en lugar de gestionar sus propios nodos. A la hora de evaluar a los proveedores, lo más importante es tener en cuenta si el acceso al archivo está incluido en tu plan o se cobra como un complemento premium, y si el proveedor admite datos de archivo en todas las cadenas que necesita tu aplicación.
¿Hasta cuándo se pueden consultar los datos históricos de la cadena de bloques?
Con un nodo de archivo puedes consultar el estado de cualquier cuenta, contrato o espacio de almacenamiento desde el bloque génesis. Los datos de transacciones y eventos están disponibles en todos los bloques, incluso en un nodo completo estándar, pero los saldos históricos y el almacenamiento de contratos solo se pueden recuperar desde un nodo de archivo. Esta distinción es importante a la hora de decidir si necesitas el estado en un momento concreto o un registro completo de la actividad pasada, una disyuntiva que tratamos en el artículo «Datos de la cadena de bloques en tiempo real frente a datos históricos». Si tus consultas siguen fallando, suele deberse a que la solicitud ha llegado a un nodo completo, por lo que comprender cómo funcionan las solicitudes RPC te ayuda a enrutarlas correctamente.
Relleno en tiempo real de bases de datos históricas
Los nodos de archivo responden a consultas sobre el estado en un momento determinado, pero muchos casos de uso de datos históricos requieren algo diferente: una base de datos completa y consultable de bloques, transacciones, registros de eventos y trazas del pasado. Para crear un panel de análisis de la cadena de bloques, una API de historial de transferencias de tokens o un explorador de bloques completo, es necesario procesar y almacenar los datos históricos de los bloques en una base de datos estructurada, y no limitarse a consultar un nodo de archivo cuando sea necesario.
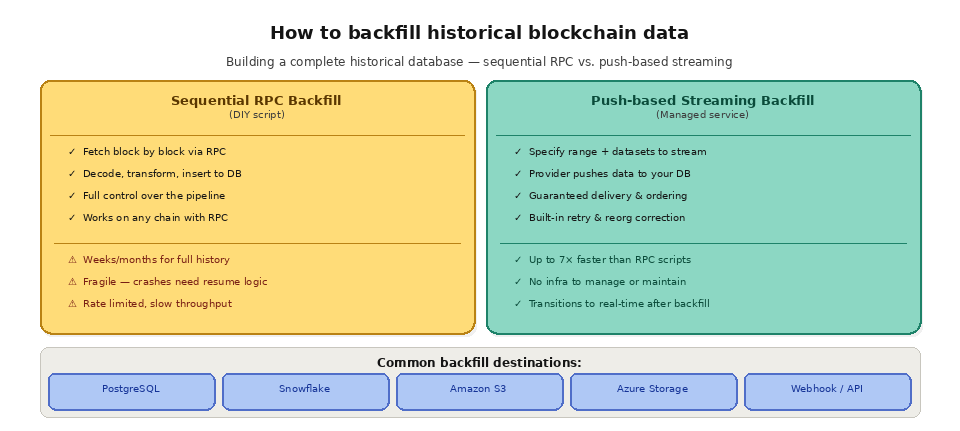
El enfoque tradicional para crear esta base de datos consiste en escribir un script que recorra los bloques uno por uno, recupere los datos de cada bloque mediante RPC, descodifique las transacciones y los registros, e inserte los resultados en la base de datos. Esto funciona, pero es extremadamente lento y frágil a gran escala. Rellenar el historial completo de Ethereum(más de 20 millones de bloques) mediante llamadas RPC secuenciales puede llevar semanas o meses. El script debe gestionar la limitación de velocidad, los fallos de conexión, los tiempos de espera de los nodos, los reintentos y el orden de los bloques. Si el script se cuelga a mitad del proceso, se necesita una lógica que permita reanudarlo desde donde se quedó sin crear huecos ni duplicados en los datos.
Las herramientas de rellenado basadas en «push» resuelven estos problemas operativos al gestionar la complejidad de la infraestructura por parte del proveedor. Solo tienes que especificar un rango de bloques, seleccionar los conjuntos de datos que necesitas (bloques, transacciones, recibos, trazas, registros), aplicar filtros si lo deseas, y el sistema envía los datos a tu destino con entrega garantizada, orden correcta y reintento automático en caso de fallo. Una vez completado el rellenado histórico, el mismo canal puede pasar a la transmisión en tiempo real para mantener tu base de datos actualizada a medida que se generan nuevos bloques.
¿Cuánto tiempo se tarda en completar los datos históricos?
El tiempo de rellenado depende de la cadena, el rango de bloques y los conjuntos de datos que solicites. Un script secuencial que recupere bloques de uno en uno a través de RPC estándar puede tardar semanas o meses en cubrir 20 millones de bloques, y tiene que gestionar por sí mismo los reintentos, el orden y la reanudación. Los rellenados gestionados basados en «push» paralelizan el trabajo y pueden completarse hasta siete veces más rápido, mostrando estimaciones de coste y tiempo de finalización antes de empezar. El rendimiento de tu infraestructura RPC subyacente es el principal factor limitante para cualquier enfoque «hazlo tú mismo».
Otros métodos para datos históricos
The Graph y otros protocolos de indexación proporcionan datos históricos preindexados de contratos inteligentes específicos a través de subgrafos. Si alguien ya ha implementado un subgrafo para el protocolo del que necesitas datos (como Uniswap, Aave o Lido), puedes consultar los datos históricos a través de su API de GraphQL sin necesidad de crear tu propio proceso de integración de datos. La limitación es que los subgrafos son específicos de cada contrato y de cada esquema, por lo que solo puedes consultar lo que el autor del subgrafo haya decidido indexar.
Los proveedores de datos externos, como Dune Analytics, Flipside Crypto y Nansen, mantienen bases de datos históricas exhaustivas de las principales cadenas y las ponen a disposición a través de interfaces SQL o API. Estas son muy útiles para el análisis y la investigación, pero implican una dependencia respecto a la actualidad, la precisión y la disponibilidad de los datos de terceros. Para las aplicaciones de producción que necesitan controlar su propio flujo de datos, basarse en datos brutos de la cadena de bloques (a través de nodos de archivo o de rellenado streams) ofrece un mayor control y fiabilidad.
Los exploradores y las API específicos de cada cadena (como la API de Etherscan) ofrecen otra vía de acceso a los datos históricos, pero suelen aplicar límites de frecuencia estrictos en los planes gratuitos y es posible que no ofrezcan el nivel de detalle o la exhaustividad que requieren las aplicaciones de producción.
¿Qué método deberías utilizar para acceder a los datos históricos de la cadena de bloques?
No existe un único método ideal: la elección adecuada depende de si necesitas un estado en un momento determinado, una base de datos completa en la que se puedan realizar consultas o análisis preagregados. La tabla siguiente resume las principales opciones. Si tu objetivo es un acceso repetido eficiente en lugar de consultas puntuales, compara el RPC con la indexación y revisa en qué consiste la indexación de la cadena de bloques antes de tomar una decisión, ya que consultar datos de la cadena de bloques a gran escala es más complicado de lo que parece a primera vista.
Método | Ideal para | Limitación principal |
|---|---|---|
Nodo de archivo RPC | Estado en un momento determinado de cualquier bloque | No es una base de datos masiva |
Relleno por streaming | Creación de una base de datos completa en la que se puedan realizar consultas | Requiere un destino donde almacenar los datos |
Protocolos de indexación y subgrafos | Datos históricos específicos de cada contrato | Limitado a lo que se ha indexado |
Cómo permite « Quicknode » el acceso a datos históricos
Quicknode Incluye acceso a los nodos de archivo en todos los planes, lo que elimina la necesidad de gestionar o pagar por separado la infraestructura de archivo. Cada Quicknode RPC endpoint puede atender consultas sobre el estado histórico en cualquier altura de bloque, desde el bloque génesis hasta el más reciente. La tecnología QRoute de Quicknode redirige automáticamente las solicitudes de estado histórico a los nodos de archivo y las solicitudes de estado actual a los nodos completos, proporcionando ambas a través de una única URL endpoint sin necesidad de configuración.
Para crear bases de datos históricas, Quicknode Streams ofrece plantillas de rellenado con un solo clic que te permiten alimentar tu base de datos con el historial completo de la cadena en más de 20 redes. Solo tienes que seleccionar la cadena, el tipo de conjunto de datos (bloques, transacciones, recibos, trazas o combinaciones «todo en uno») y el destino (PostgreSQL, Snowflake, Amazon S3, Azure Storage, webhooks), y Streams envía los datos con entrega garantizada, orden correcto de los bloques y lógica de reintento integrada. Las estimaciones de coste y tiempo de finalización se muestran antes de comenzar, lo que te ofrece total transparencia. Las sincronizaciones retrospectivas son hasta siete veces más rápidas que los scripts tradicionales basados en RPC y, una vez completadas, el mismo Stream puede continuar en tiempo real mode para mantener tu base de datos actualizada.
Lecturas recomendadas
Acceso a nodos de archivo frente a nodos completos - Blog de Quicknode
Relleno de datos de la cadena de bloques - Documentaciónde Quicknode
Plantillas de relleno con un solo clic - Quicknode
Introducción a Streams - Documentación de Quicknode
Preguntas frecuentes
¿Qué son los datos históricos de la cadena de bloques?
Los datos históricos de la cadena de bloques son cualquier registro de la actividad pasada en la cadena, incluidos los bloques, las transacciones, los registros de eventos, los rastros y el estado (saldos y almacenamiento de contratos) en una altura de bloque determinada. Los datos de las transacciones son permanentes en todos los nodos, pero el estado histórico requiere un nodo de archivo o un relleno almacenado.
¿Por qué falla la función eth_getBalance con bloques antiguos?
Un nodo completo estándar elimina los estados anteriores a, aproximadamente, las últimas 128 bloques, por lo que una llamada histórica a `eth_getBalance` devuelve un error de nodo trie ausente. Al consultar un nodo de archivo, que conserva todas las instantáneas del estado, se resuelve el error.
¿Necesito un nodo de archivo para acceder a los datos históricos?
Necesitas acceso al archivo para realizar consultas sobre el estado en un momento determinado a alturas de bloque arbitrarias. Si solo necesitas transacciones históricas y registros de eventos, puedes consultarlos en nodos completos o almacenarlos en tu propia base de datos mediante un «backfill».
¿Qué es el relleno de datos en una cadena de bloques?
Una operación de rellenado recupera un intervalo de bloques anteriores y sus conjuntos de datos, y los carga en una base de datos o en un destino de almacenamiento. Las operaciones de rellenado basadas en «push» gestionan el orden, los reintentos y la entrega garantizada, y pueden pasar a la transmisión en tiempo real una vez que se han puesto al día.
¿Qué capacidad de almacenamiento tiene un nodo de archivo de Ethereum ?
Un nodo de archivo de Ethereum almacena aproximadamente 12 TB o más, frente a los aproximadamente 1 TB de un nodo completo. El almacenamiento adicional contiene todas las instantáneas de estados históricos, por lo que el funcionamiento de la infraestructura de archivo resulta más costoso.