Respuestas>Más información sobre la indexación y los datos de blockchain>Por qué resulta complicado consultar datos de la cadena de bloques
Por qué resulta complicado consultar los datos de la cadena de bloques
// Tags
Retos relacionados con los datos de la cadena de bloques
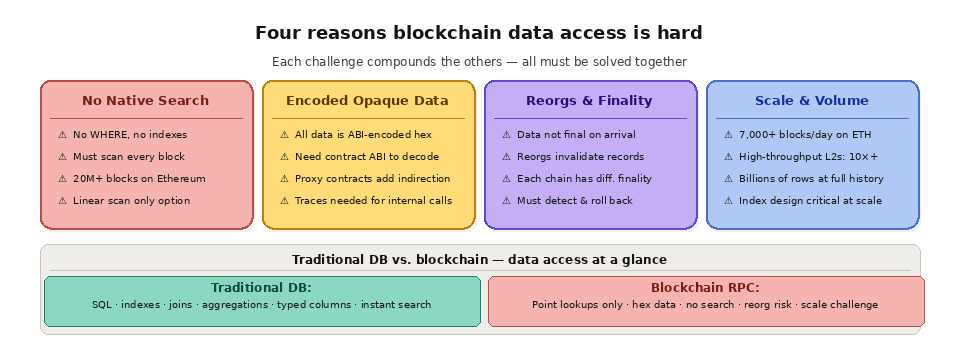
En resumen: Las cadenas de bloques están optimizadas para la seguridad y la inmutabilidad, no para la recuperación de datos. No hay funciones de búsqueda integradas, ni consultas SQL, ni índices, ni forma de filtrar o agregar datos entre bloques utilizando métodos RPC estándar. Incluso realizar consultas sencillas como «mostrar todas las transferencias de este monedero» requiere escanear millones de bloques de forma secuencial. Si a esto le sumamos las reorganizaciones de la cadena, los distintos modelos de finalidad, los formatos de datos codificados y los enormes volúmenes de datos, queda claro por qué el acceso a los datos de una cadena de bloques supone un importante reto de ingeniería.
La explicación sencilla
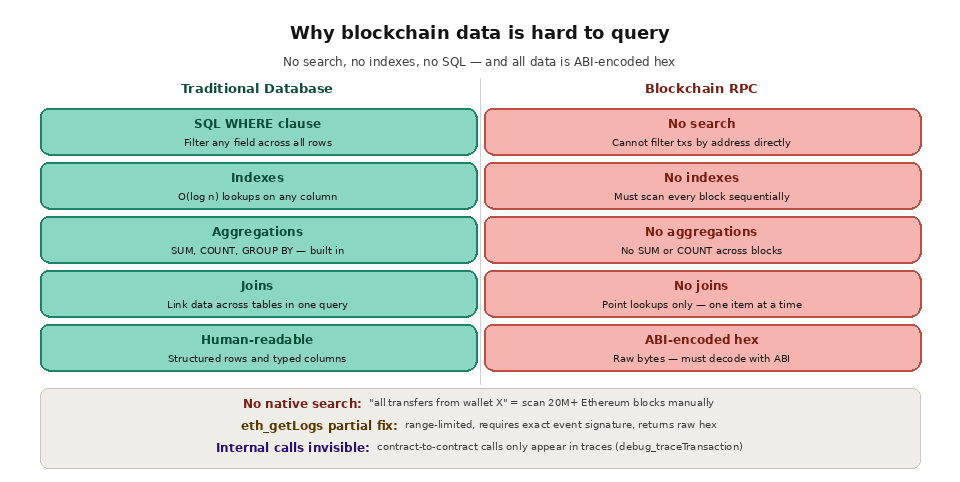
Si alguna vez has utilizado una base de datos tradicional, sabes lo fácil que es realizar consultas sobre tus datos. Una sola consulta SQL puede mostrar todos los pedidos de los últimos 30 días, agrupados por cliente, ordenados por valor total y filtrados para incluir únicamente los importes superiores a 100 dólares. El motor de la base de datos se encarga del trabajo pesado, ya que las bases de datos relacionales están diseñadas desde el principio para realizar consultas de forma flexible y eficiente. Mantienen índices, admiten uniones, permiten agregaciones y optimizan automáticamente los planes de ejecución de las consultas.
Las cadenas de bloques están diseñadas con un propósito totalmente opuesto. Su función principal es registrar transacciones en un libro mayor descentralizado e inviolable que miles de nodos independientes pueden verificar y sobre el que pueden ponerse de acuerdo. Cada decisión de diseño en la arquitectura de una cadena de bloques da prioridad al consenso, la seguridad y la inmutabilidad. La recuperación de datos es, en el mejor de los casos, una cuestión secundaria. El resultado es una estructura de datos increíblemente potente para el fin al que está destinada, pero frustrante a la hora de realizar consultas que vayan más allá de simples búsquedas puntuales.
No hay funciones nativas de búsqueda ni de filtrado
El principal reto es que las cadenas de bloques carecen de capacidad de búsqueda. No existe un comando «buscar». No hay ningún equivalente a la cláusula WHERE de SQL. La interfaz RPC ofrece unos pocos métodos de bajo nivel: recuperar un bloque por número, recuperar una transacción por hash, recuperar el saldo de una cuenta en un bloque específico. Todas ellas son búsquedas puntuales en las que ya hay que saber exactamente qué se está buscando.
Si quieres encontrar todas las transacciones de una dirección de monedero concreta, no puedes plantearle esta pregunta directamente a la cadena de bloques. Tienes que empezar por el bloque génesis, recuperar todos los bloques en orden, extraer todas las transacciones de cada bloque, comprobar los campos «de» y «a» de cada transacción y recopilar las coincidencias. En Ethereum, esto supone recorrer más de 20 millones de bloques, cada uno de los cuales contiene entre cero y varios cientos de transacciones. En Solana, las cifras son aún más abrumadoras, con miles de millones de entradas y transacciones en el historial de la cadena. Sin un índice predefinido, este escaneo lineal es la única forma de responder a la pregunta.
El método «eth_getLogs» ofrece una solución parcial, ya que permite consultar los registros de eventos dentro de un rango de bloques filtrado por dirección de contrato y tema. Sin embargo, tiene límites estrictos en cuanto al rango de bloques (normalmente unos pocos miles de bloques por solicitud), requiere que se conozca la firma exacta del evento que se busca y devuelve datos sin procesar codificados en ABI que tu aplicación debe descodificar. Para obtener una visión completa de la actividad en múltiples contratos, tipos de eventos y largos intervalos de tiempo, se necesitan cientos o miles de consultas de registros paginadas que deben integrarse en el código de tu aplicación.
Formatos de datos codificados y opacos
Los datos de la cadena de bloques no son legibles para el ser humano de forma predeterminada. Los datos de entrada de las transacciones, los parámetros del registro de eventos y los valores almacenados en el contrato se codifican según la ABI en cadenas de bytes hexadecimales. Para poder interpretar una transacción, tu aplicación necesita la ABI del contrato para descodificar la llamada a la función y sus parámetros. Para interpretar un registro de eventos, necesitas la ABI para asociar los hash de los temas a los nombres de los eventos y descodificar los campos de datos en valores tipados.
Para complicar aún más las cosas, no todos los contratos publican su ABI. Los contratos no verificados en los exploradores de bloques no proporcionan información de decodificación, lo que hace que sus transacciones y eventos resulten opacos para los observadores externos. Incluso con una ABI verificada, los contratos proxy (que delegan las llamadas a contratos de implementación) requieren que tu aplicación resuelva la relación de proxy antes de poder decodificar las llamadas a funciones subyacentes. Estas capas de indirección hacen que el procesamiento automatizado y de amplio espectro de datos de la cadena de bloques resulte significativamente más complejo que trabajar con una API REST bien documentada.
Las transacciones internas añaden otra capa de opacidad. Cuando un contrato inteligente llama a otro, esa llamada interna no aparece en la lista de transacciones del bloque. Solo aparece en los rastros de ejecución (a los que se accede mediante los métodos `debug_traceTransaction` o `trace_block`), cuya generación requiere un gran esfuerzo computacional y no están disponibles en todos los tipos de nodos. Un simple intercambio de tokens en un DEX puede implicar una docena de llamadas internas a contratos, cada una de las cuales transfiere tokens, actualiza el estado y emite eventos. Para obtener una visión completa de lo que ha ocurrido se necesitan datos de rastreo, lo que aumenta drásticamente el volumen de datos y la complejidad del procesamiento.
Reorganizaciones de la cadena y finalidad
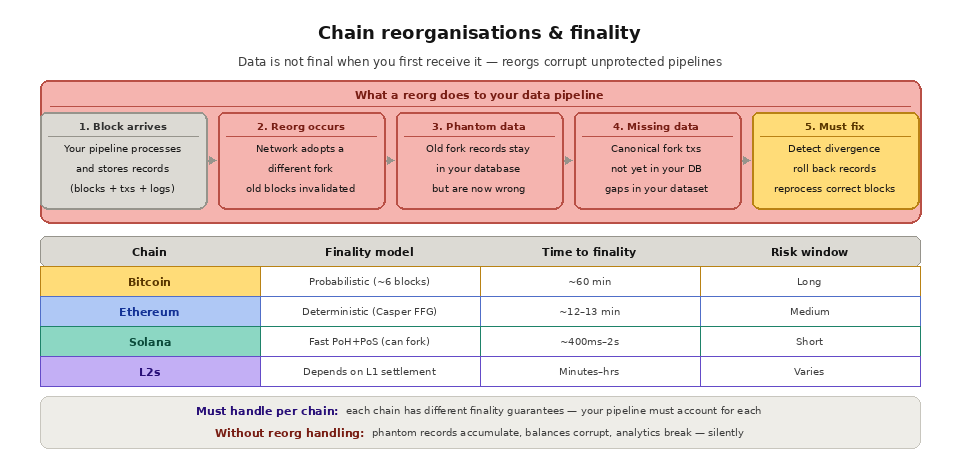
Los datos de la cadena de bloques no siempre son definitivos cuando se reciben por primera vez. Las reorganizaciones de la cadena (reorgs) se producen cuando la red sigue temporalmente una bifurcación de la cadena y, a continuación, cambia a otra bifurcación que pasa a ser la canónica. Cuando se produce una reorganización, los bloques que tu aplicación ya había procesado dejan de ser válidos. Las transacciones que parecían confirmadas pueden haber dejado de existir en la cadena canónica, o pueden aparecer en un bloque diferente y en una posición distinta.
Para los flujos de datos y los indexadores, las reorganizaciones son una pesadilla. Cualquier registro derivado de bloques reorganizados debe detectarse, revertirse y sustituirse por los datos de los bloques correctos. Si tu sistema no gestiona las reorganizaciones, tu base de datos acumulará registros fantasma (datos de ramificaciones abandonadas) y omitirá registros legítimos (datos de la ramificación canónica), lo que dará lugar a saldos incorrectos, transferencias duplicadas y análisis corruptos.
Las diferentes cadenas presentan características de finalidad distintas, lo que agrava el problema. Bitcoin Las transacciones adquieren finalidad probabilística tras aproximadamente seis confirmaciones (unos 60 minutos). Ethereum Alcanza la finalidad tras dos épocas (aproximadamente 12-13 minutos). Las cadenas L2, como Arbitrum y Base , cuentan con sus propios mecanismos de finalidad que dependen del momento en que los datos se publican en Ethereum L1. Solana Alcanza una finalidad rápida, pero aún así puede sufrir saltos de slot y resolución de bifurcaciones. Tu canalización de datos debe tener en cuenta el modelo de finalidad específico de cada cadena que procese.
Escala y rendimiento
El volumen de datos de las cadenas de bloques es abrumador y crece rápidamente. Ethereum genera aproximadamente 7.000 bloques al día, cada uno de los cuales contiene cientos de transacciones y miles de registros de eventos. Las cadenas de alto rendimiento, como Solana, Base y Arbitrum , generan datos en una escala mucho mayor. La captación, decodificación y almacenamiento de todos estos datos en tiempo real, al tiempo que se mantiene un índice histórico completo, requiere importantes recursos computacionales y de almacenamiento.
El rendimiento se ve afectado de forma sutil a medida que aumenta la escala. Las tablas de bases de datos con miles de millones de filas requieren un diseño cuidadoso de los índices, estrategias de partición y optimización de consultas para mantener tiempos de respuesta aceptables. Las escrituras simultáneas procedentes de la ingesta en tiempo real compiten con las lecturas de las consultas de los usuarios. Los costes de almacenamiento se multiplican a medida que se añaden más cadenas, más conjuntos de datos (trazas, registros, diferencias de estado) y más profundidad histórica. Lo que comienza como un flujo de datos manejable de 100 bloques al día se convierte en un reto de infraestructura cuando se alcanzan los 100 000 bloques al día repartidos en 10 cadenas.
¿Cuáles son las principales formas de consultar datos de la cadena de bloques?
No existe una única herramienta para leer datos de la cadena de bloques. Los equipos eligen entre varios enfoques en función de si necesitan una consulta rápida de un dato concreto, un flujo de datos en tiempo real o análisis históricos detallados. La tabla siguiente resume los métodos más habituales.
Enfoque
Cómo funciona
Ideal para
Llamadas RPC directas
Recuperar un bloque, una transacción o un saldo por clave
Búsquedas puntuales y estado en tiempo real
Registros de eventos (eth_getLogs)
Filtrar registros por dirección y tema en un rango de bloques
Seguimiento de eventos específicos del contrato
Indexadores
Descifrar y almacenar los datos de la cadena de bloques en una base de datos consultable
Búsquedas, uniones y agregaciones
Canales de transmisión
Envía datos nuevos e históricos a tu propia tienda
Ingestión continua a gran escala
SQL y plataformas de análisis
Realizar consultas en tablas preindexadas con SQL estándar
Cuadros de mando y análisis ad hoc
La mayoría de los sistemas de gestión de datos de producción stacks combinan varias de estas opciones. Utilizan solicitudes RPC para las lecturas en tiempo real y una capa independiente de indexación o streaming para todo lo que requiera búsqueda e historial. Para comprender la capa más baja, consulta qué hace realmente un RPC endpoint.
¿Por qué no se puede utilizar SQL directamente en una cadena de bloques?
Una cadena de bloques almacena los datos como una secuencia de bloques vinculados criptográficamente, no como tablas indexadas, por lo que no hay planificador de consultas, ni cláusula WHERE, ni forma de solicitar «todos los intercambios superiores a 1.000 dólares de la semana pasada» en una sola llamada. Para alcanzar ese nivel de acceso, primero hay que extraer y descodificar los datos sin procesar y, a continuación, cargarlos en un sistema que admita consultas estructuradas. Ese proceso de extracción, descodificación y carga es precisamente lo que realiza la indexación de la cadena de bloques.
¿Es mejor utilizar un nodo RPC o un indexador para consultar datos?
Los nodos RPC y los indexadores resuelven problemas distintos. Un nodo RPC es ideal para consultas directas y para enviar transacciones, mientras que un indexador está diseñado para la búsqueda, el filtrado y la agregación, tareas que los nodos básicos no pueden realizar. La comparación que figura a continuación muestra para qué sirve cada uno.
Factor
Nodo RPC
Indexador
Estilo de consulta
Búsquedas de puntos por clave
Búsqueda y filtros flexibles
Agregación
No compatible
Integrado en
Profundidad histórica
Se necesita un nodo de archivo
Se almacena una sola vez, se consulta rápidamente
Esfuerzo de configuración
Low, llama a un endpoint
Higher: construir o adquirir un gasoducto
Uso recomendado
Estado en tiempo real y transacciones
Análisis y consultas complejas
Para obtener un análisis más detallado de cuándo sale ganando cada una, consulta «RPC frente a la indexación».
¿Cómo se consultan los datos históricos de la cadena de bloques?
El estado actual se puede consultar en cualquier nodo completo, pero para acceder a estados anteriores y al historial completo de transacciones suele ser necesario un nodo de archivo o un canal de retroalimentación. La distinción entre datos actuales y datos históricos determina toda la arquitectura, tal y como se explica en los apartados «Datos de la cadena de bloques en tiempo real frente a datos históricos » y «Nodo completo frente a nodo de archivo». Para búsquedas puntuales en profundidad, basta con un nodo de archivo endpoint ; para análisis repetidos, resulta mucho más eficiente indexar el historial una sola vez.
Preguntas frecuentes
¿Se puede consultar una cadena de bloques como si fuera una base de datos normal?
No directamente. Los métodos RPC estándar solo admiten búsquedas puntuales por número de bloque, hash de transacción o dirección. Para ejecutar consultas tipo base de datos con filtrado y agregación, primero hay que indexar los datos en un sistema que las admita.
¿Cuál es la forma más rápida de obtener todas las transacciones de un monedero?
Utiliza un indexador o una API de datos ya preparada. Escanear la cadena bloque a bloque con RPC sin procesar resulta demasiado lento para esto, mientras que un conjunto de datos indexado puede devolver el historial completo de una cartera en una sola consulta.
¿Por qué los datos descodificados de la cadena de bloques requieren una ABI?
Las entradas de las transacciones y los registros de eventos se almacenan en formato hexadecimal codificado según la ABI. La ABI del contrato es el esquema que asocia esos bytes a nombres de funciones, nombres de eventos y valores tipificados, por lo que, sin ella, los datos siguen siendo opacos.
¿Cómo afectan las reorganizaciones a las consultas en la cadena de bloques?
Una reorganización puede invalidar los datos que ya se han leído, por lo que los resultados de las consultas near más allá de la punta de la cadena no son definitivos. Los flujos de trabajo robustos esperan a que se alcance la finalidad o envían actualizaciones correctivas cuando cambia la cadena canónica.
¿Es necesario ejecutar tu propio nodo para consultar los datos de la cadena de bloques?
No. Los proveedores de RPC gestionados, los servicios de streaming y las plataformas de análisis te permiten leer y consultar datos de la cadena de bloques sin necesidad de gestionar tú mismo ningún nodo ni indexador.
Cómo « Quicknode » simplifica el acceso a los datos de la cadena de bloques
QuicknodeLa suite de productos de [nombre] está diseñada para abordar directamente cada uno de estos retos. La API Core ofrece un acceso RPC rápido y fiable para la búsqueda de puntos y el envío de transacciones, con métodos de API mejorados que agrupan consultas comunes de varios pasos en una sola llamada. El acceso al archivo está incluido en todos los planes, por lo que las consultas de estado histórico funcionan sin necesidad de una infraestructura independiente ni costes adicionales.
Quicknode Streams Elimina por completo el reto que supone la ingesta de datos. En lugar de crear y mantener scripts personalizados que consultan puntos finales RPC, gestionan la paginación, controlan los reintentos y detectan reorganizaciones, basta con configurar un Stream que envíe directamente a tu base de datos o almacén de datos exactamente los datos de la cadena de bloques que necesitas. « Streams » entrega los datos en orden de finalidad con garantías de «exactamente una vez», gestiona automáticamente las reorganizaciones de la cadena enviando cargas útiles de corrección y admite tanto la transmisión en tiempo real como el relleno histórico a través del mismo canal. Los filtros basados en JavaScript se ejecutan en la infraestructura de Quicknode para decodificar, transformar y dar forma a los datos antes de su entrega, de modo que tu destino reciba registros limpios y estructurados, listos para su consulta.
Para los equipos que deseen disponer de datos de blockchain indexados sin tener que crear ningún proceso de integración, el Marketplace de Quicknode incluye integraciones con socios que ofrecen protocolos de indexación y servicios de datos, los cuales proporcionan conjuntos de datos ya preparados y consultables para casos de uso habituales.