En resumen: Los datos de la cadena de bloques en tiempo real son la información procedente de la punta de la cadena, los bloques generados más recientemente y las transacciones que se están produciendo en este mismo momento. Los datos históricos de la cadena de bloques son todo lo anterior, desde el bloque génesis hasta el pasado reciente. Las aplicaciones necesitan ambos: los datos en tiempo real alimentan los paneles de control en directo, la supervisión de transacciones y las notificaciones instantáneas, mientras que los datos históricos sirven de base para el análisis, la auditoría, el rellenado de bases de datos y el entrenamiento de modelos. El reto de la infraestructura radica en que, para acceder a cada tipo de forma eficiente, se necesitan herramientas diferentes, y las mejores arquitecturas unifican ambos en un único flujo de trabajo.
La explicación sencilla
Piensa en una cadena de bloques como un libro mayor que crece continuamente. En cualquier momento dado, la entrada más reciente se está registrando en la punta. Todo lo que hay detrás ya forma parte del historial. La distinción entre datos en tiempo real y datos históricos no tiene que ver con los datos en sí mismos (los bloques son bloques, las transacciones son transacciones), sino con cuándo y cómo tu aplicación necesita acceder a ellos.
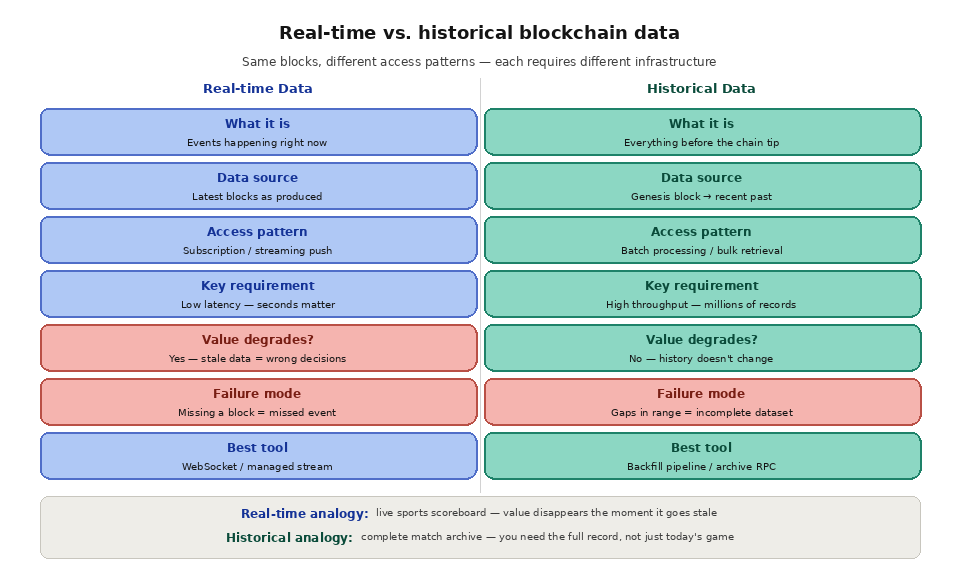
Los datos en tiempo real son lo que está ocurriendo ahora mismo. Acaba de generarse un nuevo bloque. Acaba de completarse una transferencia de tokens. Acaba de activarse un evento de contrato inteligente. Tu aplicación necesita conocer estos eventos lo antes posible, idealmente en cuestión de segundos tras la finalización del bloque. El acceso a los datos en tiempo real es sensible a la latencia. El valor de la información se degrada con cada segundo de retraso. Un bot de trading que se entera de un cambio de precio 30 segundos después de que se produzca se encuentra en una grave desventaja en comparación con uno que se entera de ello en 2 segundos.
Los datos históricos son lo que ya ha ocurrido. Un usuario quiere ver su historial completo de transacciones del último año. Una plataforma de análisis necesita calcular el volumen total negociado en un DEX desde su lanzamiento. Un equipe a de cumplimiento normativo necesita rastrear los flujos de fondos a lo largo de seis meses de actividad. El acceso a los datos históricos depende del rendimiento. El reto no es la rapidez con la que se obtiene un único registro, sino la eficiencia con la que se pueden recuperar, procesar y almacenar millones o miles de millones de registros que abarcan miles o millones de bloques.
Diferentes patrones de acceso
Los patrones de acceso a los datos en tiempo real y a los datos históricos son fundamentalmente diferentes, por lo que suelen requerir enfoques de infraestructura distintos.
El acceso a los datos en tiempo real sigue un modelo de suscripción. Tu aplicación indica: «avísame cada vez que se genere un nuevo bloque» o «avísame cada vez que este contrato emita un evento de transferencia». Los datos llegan como un flujo continuo, un bloque cada vez, en el orden en que la cadena los genera. Tu aplicación procesa cada bloque a medida que llega y actualiza su estado en consecuencia. Los requisitos clave son la baja latencia (retardo mínimo entre la generación del bloque y su entrega), la fiabilidad (que nunca se pierda ningún bloque) y el orden (los bloques llegan en la secuencia correcta, sin saltos).
El acceso a los datos históricos sigue un modelo de procesamiento por lotes. Tu aplicación solicita «dame todos los bloques del número 10 000 000 al 20 000 000» o «recupera todos los eventos de transferencia ERC-20 del contrato USDC desde su implementación». Los datos llegan en grandes cantidades, potencialmente millones de registros, y tu aplicación los procesa en grandes lotes antes de cargarlos en una base de datos o un almacén de datos. Los requisitos clave son el rendimiento (procesar tantos bloques por segundo como sea posible), la exhaustividad (que no falten bloques ni haya lagunas) y la rentabilidad (minimizar la potencia de cálculo y el ancho de banda necesarios para recuperar terabytes de datos).
Estos diferentes requisitos explican por qué un único enfoque rara vez satisface adecuadamente ambas necesidades. Las suscripciones WebSocket funcionan para los datos en tiempo real, pero no pueden recuperar bloques históricos. El sondeo secuencial mediante RPC puede, técnicamente, obtener datos históricos, pero resulta extremadamente lento y costoso a gran escala. Los flujos de datos diseñados específicamente para gestionar tanto la transmisión en tiempo real como la recuperación de datos históricos a través de la misma interfaz resuelven este desajuste arquitectónico.
Por qué las aplicaciones necesitan ambas cosas
Casi todas las aplicaciones de blockchain en producción requieren tanto datos en tiempo real como históricos, a menudo de forma simultánea.
Un panel de control de DeFi necesita datos históricos para mostrar gráficos con la evolución del precio de un token durante los últimos 90 días, la tendencia del TVL de un pool durante el último año y el historial completo de posiciones de un usuario. Al mismo tiempo, necesita datos en tiempo real para actualizar el precio actual, mostrar las operaciones en directo a medida que se producen y alertar al usuario cuando su posición se acerque a un umbral de liquidación. Si el panel de control solo contara con datos en tiempo real, se iniciaría con una pantalla en blanco cada vez que se cargara. Si solo contara con datos históricos, las cifras siempre estarían desactualizadas.
Un indexador de blockchain necesita datos históricos para crear su base de datos inicial, procesando todos los bloques desde el bloque génesis (o desde el bloque de implementación del contrato) hasta el presente. Una vez completada la recarga de datos históricos, necesita datos en tiempo real para mantener la base de datos actualizada, procesando cada nuevo bloque a medida que se genera. La transición de la recarga de datos históricos a la transmisión en tiempo real debe ser fluida, sin que haya ninguna brecha entre el último bloque histórico procesado y el primer bloque en tiempo real recibido. Cualquier interrupción supone una pérdida de datos. Cualquier solapamiento supone datos duplicados.
Un mercado de NFT necesita datos históricos para mostrar el historial de propiedad, los precios de venta anteriores y la procedencia de cada token. Necesita datos en tiempo real para mostrar los nuevos anuncios en el momento en que se crean, actualizar los precios cuando se reciben pujas en las subastas y confirmar las transferencias cuando se completan las ventas. Los operadores se basan en los datos históricos para la valoración y en los datos en tiempo real para la ejecución.
Un sistema de supervisión del cumplimiento normativo necesita datos históricos para llevar a cabo investigaciones retroactivas cuando se detecta una actividad sospechosa. Necesita datos en tiempo real para detectar patrones sospechosos en el momento en que se producen y generar alertas en cuestión de minutos, en lugar de días. El sistema debe ser capaz de alternar entre ambos modos, transmitiendo la nueva actividad en tiempo real y, al mismo tiempo, consultando meses de registros históricos para obtener contexto.

El reto de la arquitectura
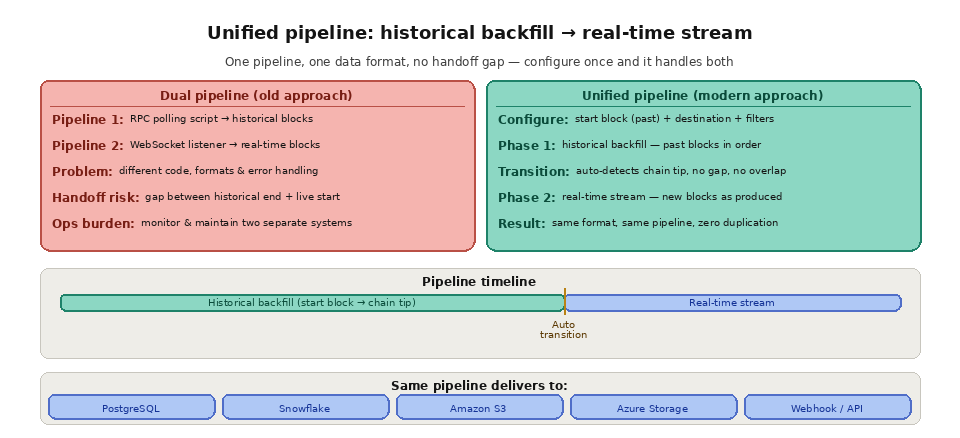
El enfoque tradicional para gestionar ambos tipos de datos consiste en crear dos sistemas independientes: un canal de rellenado histórico (normalmente un script que recorre bloques mediante RPC) y un receptor en tiempo real (normalmente una suscripción a WebSocket o un bucle de sondeo). Esta arquitectura de doble canal plantea varios problemas. Los dos sistemas utilizan código diferente, un manejo de errores distinto, formatos de datos distintos y mecanismos de entrega diferentes. Mantenerlos sincronizados durante el traspaso de los datos históricos a los de tiempo real es propenso a errores. El mantenimiento y la supervisión de dos canalizaciones independientes duplican la carga operativa.
Un canal de datos unificado que gestiona tanto los datos históricos como los de tiempo real a través de una única interfaz elimina estos problemas. Se configura un único canal con un bloque inicial (en el pasado para los datos históricos, o «más reciente» para los de tiempo real únicamente), y el sistema entrega los datos a partir de ese punto inicial, pasando de forma fluida de la recuperación de datos históricos a la transmisión en tiempo real una vez que alcanza el extremo de la cadena. Mismo formato de datos, mismo mecanismo de entrega, misma gestión de errores, misma supervisión. Al canal no le importa si el bloque que está procesando se generó hace tres años o hace tres segundos.
¿Cuál es la diferencia entre los datos de la cadena de bloques en tiempo real y los históricos?
Los datos son los mismos bloques y transacciones; lo que difiere es cuándo se necesitan y cómo se obtienen. Los datos en tiempo real se leen en la punta de la cadena mediante una suscripción, por lo que están optimizados para una baja latencia. Los datos históricos se leen de forma masiva a partir de bloques anteriores, por lo que están optimizados para el rendimiento y el coste. Por eso, consultar datos de la cadena de bloques de forma eficiente suele implicar elegir una herramienta diferente para cada tarea. La tabla siguiente resume las diferencias.
Dimensión | Datos en tiempo real | Datos históricos |
|---|---|---|
Definición | La punta de la cadena y las transacciones que se están produciendo en este momento | Todo, desde los orígenes hasta el pasado reciente |
Patrón de acceso | Suscripción, bloque a bloque | Por lotes, varios bloques a la vez |
Sensible a | Latencia | Rendimiento y coste |
¿Cómo se accede a los datos históricos de la cadena de bloques?
Hay tres formas habituales de consultar datos históricos. Puedes consultar un nodo de archivo, que conserva el estado completo en cada altura de bloque y responde a consultas puntuales sobre cualquier momento histórico. Se puede ejecutar un «backfill», que recorre un rango de bloques y exporta los resultados de forma masiva. O bien, se puede utilizar un indexador que ya haya procesado y almacenado los datos en una base de datos consultable. Cada opción presenta diferentes compensaciones en cuanto a esfuerzo de configuración, velocidad y coste, y la elección adecuada depende de la cantidad de historial que se necesite y de la frecuencia con la que se requiera. Para obtener una visión más detallada de las opciones y sus compensaciones, consulta «Acceso a datos históricos de la cadena de bloques».
¿Qué aplicaciones necesitan datos en tiempo real y cuáles, datos históricos?
La mayoría de las aplicaciones de producción necesitan ambas cosas, pero el equilibrio varía según el caso de uso. Las funciones sensibles a la latencia se inclinan por el tiempo real, mientras que las funciones analíticas y de auditoría se inclinan por los datos históricos. La tabla siguiente relaciona las cargas de trabajo habituales con su necesidad principal de datos, y puedes encontrar más patrones en estos casos de uso de streaming en blockchain.
Caso de uso | Necesidad de datos primarios | ¿Por qué? |
|---|---|---|
Bot de trading | En tiempo real | Reacciona ante los cambios de precio en cuestión de segundos |
Informe fiscal o de auditoría | Histórico | Reconstruye un historial completo de actividades |
Indexador de blockchain | Ambos | Historial de rellenos; a continuación, « streams » (nuevas manzanas) |
¿Cómo se pueden unificar los datos en tiempo real y los históricos en un único proceso?
La arquitectura más limpia consiste en configurar un único canal con un punto de partida en el pasado, procesar los datos en orden hacia adelante y, a continuación, pasar automáticamente a la entrega en tiempo real una vez que se llega al extremo de la cadena. Esto elimina el frágil traspaso entre un script de relleno y un receptor en tiempo real independiente. Si estás valorando cómo deben llegar los datos, la elección entre el sondeo y la transmisión en continuo determina en gran medida lo complicado que resulta implementar ese traspaso por tu cuenta, y un servicio gestionado como Quicknode Streams se encarga por ti del orden, las lagunas y las reorganizaciones.
Preguntas frecuentes
¿Son los datos en tiempo real más valiosos que los datos históricos?
Ninguno de los dos es, en general, más valioso; cada uno cumple una función diferente. Los datos en tiempo real son fundamentales para funciones en las que la actualidad es lo más importante, como las alertas y la ejecución de operaciones, mientras que los datos históricos son esenciales para los análisis, las auditorías y cualquier visión que requiera un contexto del pasado. La mayoría de las aplicaciones serias dependen de ambos a la vez.
¿Hasta cuándo puedo consultar los datos históricos de la cadena de bloques?
Con la infraestructura adecuada, puedes consultar datos desde el bloque génesis. Para obtener el estado completo en cualquier momento histórico, se necesita un nodo de archivo en lugar de un nodo completo podado; por eso es importante distinguir entre un nodo completo y un nodo de archivo a la hora de planificar el acceso a datos históricos.
¿Puede un único canal de datos proporcionar tanto datos en tiempo real como datos históricos?
Sí. Un canal de transmisión unificado puede comenzar a partir de un bloque anterior, completar los datos retrospectivamente y, a continuación, continuar con los datos en tiempo real sin interrupciones ni necesidad de un segundo sistema. Esta es la idea fundamental que subyace a la transmisión de datos mediante blockchain, que proporciona datos ordenados independientemente de si el bloque es antiguo o completamente nuevo.
¿Cuál es la forma más rápida de completar los datos históricos?
Los scripts RPC secuenciales son sencillos, pero lentos y costosos a gran escala. Las herramientas de rellenado diseñadas específicamente para este fin, que exportan rangos de bloques de forma masiva a una base de datos o a un almacén de datos, suelen ser mucho más rápidas y económicas, ya que están optimizadas para el rendimiento en lugar de para procesar una solicitud cada vez.
¿Necesito un indexador para las consultas históricas?
No siempre. Para búsquedas ocasionales, basta con un nodo de archivo o un «backfill». Pero si se realizan consultas frecuentes y complejas sobre rangos amplios, la indexación de la cadena de bloques preprocesa los datos en un almacén consultable, de modo que cada consulta sea rápida, en lugar de tener que volver a calcularse a partir de bloques sin procesar.
Cómo gestiona « Quicknode » ambas cosas
Quicknode Streams ofrece un canal unificado tanto para datos de blockchain en tiempo real como históricos. Se puede configurar una única «Stream» para que comience desde cualquier bloque histórico y procese hacia adelante, entregando los datos en orden de finalidad a su destino (PostgreSQL, Snowflake, Amazon S3, Azure Storage, webhooks y más). Una vez que la «Stream» llega al extremo de la cadena, pasa automáticamente a la « mode » en tiempo real y continúa entregando nuevos bloques a medida que se producen. No hay interrupciones, ni lógica de traspaso, ni un segundo canal que mantener.
Para consultas puntuales en tiempo real, la API Core de Quicknode ofrece acceso RPC distribuido a nivel global con soporte de archivos en todos los planes, lo que significa que tu aplicación puede consultar el estado actual de la cadena o cualquier estado histórico en cualquier altura de bloque a través de un único endpoint. Los métodos mejorados de la API agrupan consultas comunes de varios pasos en una sola llamada, lo que reduce la latencia en las lecturas en tiempo real. En lo que respecta específicamente a los rellenos históricos, Quicknode ofrece plantillas de relleno con un solo clic con conjuntos de datos preconfigurados en más de 20 cadenas, estimaciones transparentes de costes y tiempos, y velocidades de entrega hasta siete veces más rápidas que los scripts basados en RPC.
Lecturas recomendadas
Primeros pasos con Streams - Documentaciónde Quicknode
Relleno de datos en la cadena de bloques - Documentación de Quicknode
Plantillas de relleno con un solo clic - Quicknode
Quicknode API principal