Respuestas>Más información sobre la transmisión de datos en blockchain>¿Qué es la transmisión de datos en blockchain?
¿Qué es la transmisión de datos en blockchain?
// Tags
transmisión de datos de blockchainDatos de la cadena de bloques en tiempo real
En resumen: La transmisión de datos de blockchain es un enfoque basado en notificaciones push para acceder a los datos de la cadena de bloques, en el que los nuevos bloques, transacciones y eventos se envían automáticamente a tu aplicación o base de datos a medida que se generan en la cadena. En lugar de que tu aplicación pregunte repetidamente al nodo «¿hay algo nuevo?» (sondeo), un servicio de transmisión te envía los datos en el momento en que están disponibles. La transmisión reduce la latencia, elimina la pérdida de eventos, simplifica la arquitectura del backend y se escala de forma mucho más eficiente que los patrones tradicionales de solicitud-respuesta.
La explicación sencilla
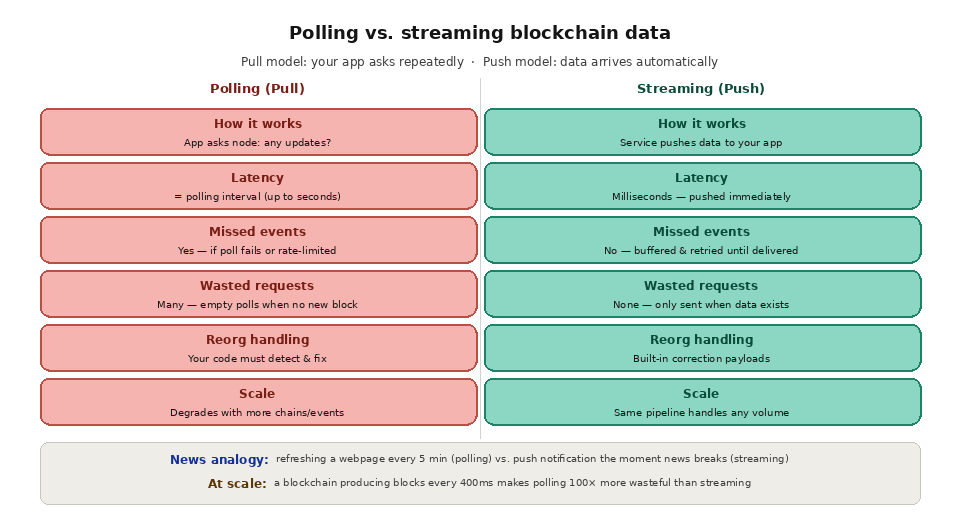
Hay dos formas fundamentales de obtener datos de cualquier sistema: puedes solicitarlos (pull) o se te pueden enviar (push). Durante la mayor parte de la historia de la cadena de bloques, los desarrolladores han utilizado el modelo «pull». Tu aplicación envía una solicitud RPC a un nodo, el nodo devuelve una respuesta y tu aplicación decide cuándo volver a solicitarla. Este es el patrón de sondeo. Es sencillo de implementar, pero ineficiente, especialmente cuando tu aplicación necesita mantenerse sincronizada con el estado más reciente de la cadena de bloques.
El streaming da un giro a este modelo. En lugar de que tu aplicación pregunte «¿qué ha ocurrido en el último bloque?» miles de veces al día, estableces un canal de datos una sola vez y el servicio de streaming envía los datos de cada nuevo bloque a tu aplicación o base de datos a medida que se generan. Tu aplicación pasa a ser un consumidor de un flujo continuo de datos, en lugar de un solicitante de instantáneas de datos aisladas.
La analogía es la diferencia entre actualizar una página web de noticias cada cinco minutos y suscribirse a una notificación push que te avisa en cuanto se publica una noticia de última hora ( story ). Ambas opciones te proporcionan la misma información al final, pero el modelo de notificaciones push es más rápido, menos ineficaz y más fiable.
Cómo funciona la transmisión de datos en blockchain
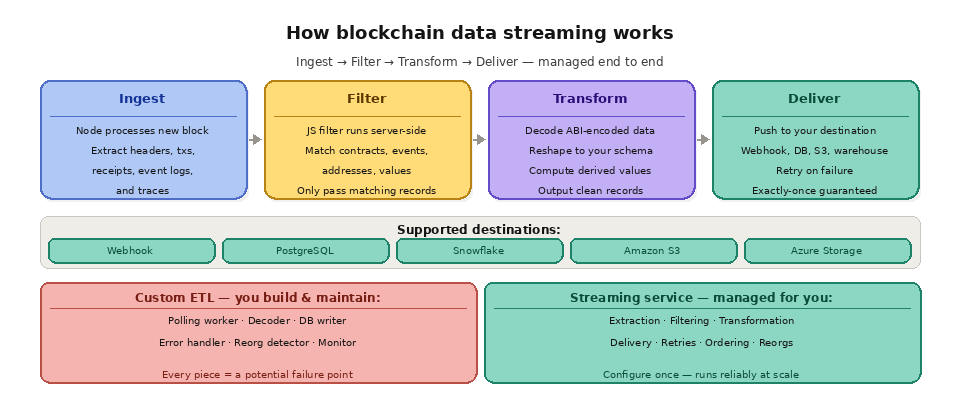
Un servicio de streaming actúa como intermediario entre los nodos de la cadena de bloques y tu aplicación o infraestructura de datos. En lo que respecta a la ingesta de datos, el servicio se conecta a los nodos de las redes compatibles y procesa cada nuevo bloque a medida que se finaliza. Extrae los datos sin procesar del bloque, incluyendo encabezados, transacciones, recibos de transacciones (con registros de eventos) y, opcionalmente, trazas de ejecución. Estos datos sin procesar constituyen el registro completo de todo lo que ha ocurrido en ese bloque.
En cuanto al procesamiento, el servicio de streaming aplica los filtros o transformaciones que hayas configurado. Quizá solo te interesen los eventos de transferencia ERC-20 procedentes de un conjunto específico de contratos. Un filtro escrito en JavaScript u otro lenguaje compatible se ejecuta sobre los datos de cada bloque y solo deja pasar los registros que cumplen tus criterios. Este filtrado del lado del servidor es fundamental para la eficiencia, ya que significa que tu destino solo recibe y almacena los datos que realmente necesitas, y no el bloque completo.
En cuanto a la entrega, los datos filtrados se envían al destino que hayas configurado. Este puede ser una URL de webhook en la que tu aplicación esté a la escucha, una base de datos PostgreSQL, un almacén de datos Snowflake, un bucket de Amazon S3, Azure Blob Storage u otro destino compatible endpoint. El servicio de streaming se encarga de garantizar la entrega, lo que incluye reintentos en caso de fallo, deduplicación y ordenación correcta, de modo que tu destino reciba un flujo secuencial y sin interrupciones de datos de la cadena de bloques.
Entrenamiento en tiempo real frente a los enfoques ETL tradicionales
Los flujos de trabajo ETL (Extract, Transform, Load) tradicionales basados en blockchain exigen a los desarrolladores crear y mantener una infraestructura considerable. Una configuración ETL personalizada típica incluye un proceso de sondeo que llama a puntos finales RPC según una programación para recuperar nuevos bloques, una capa de procesamiento que decodifica y transforma los datos sin procesar, un proceso de escritura en la base de datos que inserta registros, un gestor de errores que gestiona los reintentos y los fallos, un detector de reorganizaciones que identifica y revierte los datos de bifurcaciones abandonadas, y un sistema de supervisión que avisa cuando alguno de estos componentes falla. Cada elemento añade complejidad y cada uno de ellos es un posible punto de fallo.
Los servicios de streaming agrupan todo esto en un único canal gestionado. La extracción, el filtrado, la transformación, la entrega, la lógica de reintentos, la ordenación y la gestión de la reorganización se llevan a cabo íntegramente en la infraestructura del proveedor. Tu responsabilidad se limita a configurar qué datos deseas, dónde quieres que se envíen y cómo quieres que se estructuren. Esto reduce drásticamente el esfuerzo de ingeniería necesario para crear y mantener una infraestructura de datos de blockchain.
La diferencia de rendimiento también es considerable. Un proceso basado en sondeos tiene, por naturaleza, una latencia igual al intervalo de sondeo. Si tu trabajador comprueba si hay nuevos bloques cada 5 segundos, podrías acumular un retraso de hasta 5 segundos respecto a la punta de la cadena, incluso cuando todo funciona a la perfección. Los sondeos perdidos (debido a errores, límites de frecuencia o reinicios del trabajador) aumentan esta diferencia. La transmisión en tiempo real elimina la latencia de las consultas, ya que los datos se envían tan pronto como están disponibles. En cadenas de alto rendimiento, en las que se producen bloques cada pocos cientos de milisegundos, esta diferencia es significativa para las aplicaciones sensibles a la latencia.
Características principales de la transmisión en directo de la producción
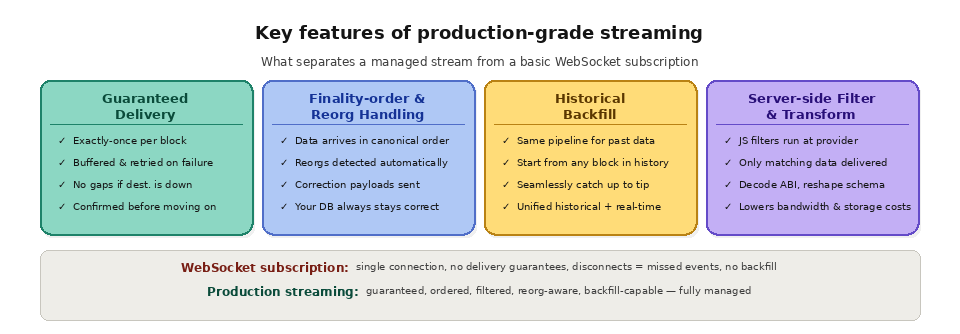
Hay varias características que distinguen el streaming de nivel de producción de una simple suscripción a WebSocket. La entrega garantizada asegura que los datos de cada bloque lleguen a su destino exactamente una vez, incluso si la conexión se interrumpe temporalmente o si el destino sufre una breve interrupción del servicio. El servicio de streaming almacena los datos en el búfer y vuelve a intentarlo hasta que se confirme la entrega, por lo que nunca se producen lagunas en los datos.
La entrega por orden de finalidad significa que los datos llegan en el orden que la cadena de bloques considera canónico. En cadenas con tiempos de finalidad variables, el servicio de transmisión espera hasta que un bloque esté suficientemente confirmado antes de entregarlo, lo que evita que tu aplicación procese datos que más tarde podrían quedar invalidados por una reorganización. Cuando se producen reorganizaciones, el servicio detecta la bifurcación, identifica qué bloques ya no son canónicos y envía cargas útiles de corrección para que tu destino pueda actualizarse en consecuencia.
El relleno histórico te permite utilizar el mismo canal de transmisión para los datos pasados, no solo para los nuevos bloques. En lugar de crear un proceso ETL independiente para los datos históricos y otro distinto para los datos en tiempo real, se configura un único canal con un bloque inicial en el pasado y se deja que avance a lo largo del historial, para luego pasar sin interrupciones al tiempo real una vez que alcanza la punta de la cadena. Este canal unificado simplifica tu arquitectura y garantiza la coherencia entre los datos históricos y los datos en tiempo real.
El filtrado y la transformación del lado del servidor reducen el volumen de datos que llega a su destino, lo que disminuye los costes de ancho de banda, los costes de almacenamiento y la sobrecarga de procesamiento. Los filtros pueden basarse en direcciones, firmas de eventos, selectores de funciones, valores de transacciones o cualquier otra propiedad de los datos en bloque. Las transformaciones pueden remodelar las cargas útiles, descodificar datos codificados en ABI, calcular valores derivados y generar registros en un esquema que se ajuste a las tablas de su base de datos.
Cómo ofrece « Quicknode » (Streams ) la transmisión de datos mediante blockchain
Quicknode Streams Es un servicio de transmisión de datos y ETL basado en blockchain, diseñado específicamente para ofrecer datos en tiempo real e históricos de más de 80 cadenas, con funciones integradas de filtrado, transformación y entrega garantizada. Streams es compatible con múltiples tipos de conjuntos de datos (bloques, transacciones, recibos, registros de eventos, trazas) y múltiples destinos (webhooks, PostgreSQL, Snowflake, Amazon S3, Azure Storage y muchos más).
Streams Procesa los datos en orden de finalidad con garantías de entrega «exactamente una vez», gestiona automáticamente las reorganizaciones de la cadena mediante el envío de cargas útiles de corrección y admite el procesamiento por lotes y la compresión configurables para un rendimiento óptimo durante las completaduras históricas. Los filtros de JavaScript se ejecutan en la infraestructura de Quicknode, lo que te permite decodificar eventos, buscar coincidencias con patrones, consultar almacenes externos de clave-valor y dar forma a las cargas útiles de salida antes de que los datos lleguen a su destino. Las plantillas de rellenado con un solo clic proporcionan flujos de trabajo preconfigurados para conjuntos de datos comunes en más de 20 cadenas, con estimaciones transparentes de costes y tiempos de finalización que se muestran antes de empezar.
Para flujos de trabajo aún más sofisticados, « Streams » se integra con « Quicknode Functions» para permitir la automatización sin servidor sobre datos en tiempo real. «Functions» puede enriquecer los registros con datos adicionales de la cadena de bloques, llamar a API externas, activar notificaciones o ejecutar lógica de negocio arbitraria en respuesta a eventos en tiempo real. Juntos, « Streams » y «Functions» proporcionan una plataforma completa de datos de cadena de bloques que sustituye la infraestructura ETL personalizada por una solución gestionada y escalable.
¿Cuál es la diferencia entre el streaming y el sondeo?
El sondeo y la transmisión en tiempo real son las dos formas en que una aplicación se mantiene al día de la actividad en la cadena de bloques, y se sitúan en extremos opuestos de un espectro. El sondeo se basa en el modelo «pull»: tu aplicación pregunta repetidamente a un nodo si hay datos nuevos. La transmisión en tiempo real se basa en el modelo «push»: un servicio te envía los datos nuevos en el instante en que están disponibles. La tabla siguiente compara ambos métodos en función de los aspectos más importantes a la hora de elegir un enfoque.
Dimensión
Encuestas
Streaming
Datos flow
La aplicación se ejecuta según un horario
El servicio envía notificaciones a medida que se generan los datos
Latencia
Limitado por el intervalo de muestreo
Near en tiempo real, sin retraso por intervalos
Riesgo de pérdida de datos
Lagunas en caso de que una encuesta falle o se omita
Entrega garantizada y sin interrupciones
Gestión de reorganizaciones
Lo montas tú mismo
Incorporadas mediante cargas útiles de corrección
Carga operativa
Tú gestionas y amplías los trabajadores
Gestionado por el proveedor
Para una comparación más detallada de los dos modelos de distribución y saber cuándo conviene utilizar cada uno, consulta «Polling frente a streaming».
¿Cuáles son los casos de uso más habituales de la transmisión de datos mediante blockchain?
El streaming se adapta a cualquier carga de trabajo que deba reaccionar rápidamente a la actividad en la cadena o mantener una base de datos sincronizada de forma continua. Entre los ejemplos más comunes se incluyen el seguimiento en tiempo real de carteras y carteras de inversión, los paneles de control de DeFi, los bots de negociación y liquidación, la supervisión de la acuñación y venta de NFT, las alertas de fraude y cumplimiento normativo, y los almacenes de análisis que recopilan cada bloque. Cada uno de ellos se beneficia de una baja latencia y de una transmisión sin interrupciones, en lugar de instantáneas periódicas. Para consultar un catálogo más completo de patrones, véanse los casos de uso del streaming en blockchain.
¿Cómo gestiona el streaming los datos en tiempo real frente a los datos históricos?
Un buen proceso de transmisión de datos trata los datos en tiempo real y los históricos como una única línea temporal continua, en lugar de como dos sistemas separados. Puedes iniciar una transmisión desde un bloque muy lejano en el pasado, dejar que se complete hacia adelante a lo largo del historial y, a continuación, pasar sin interrupciones a los bloques en tiempo real una vez que alcance la punta de la cadena. Esto evita tener que mantener dos canalizaciones con dos rutas de código diferentes. Para comprender las ventajas e inconvenientes entre los datos recientes y los archivados, consulta «Datos de la cadena de bloques en tiempo real frente a datos históricos»; y, para conocer las estrategias de completado, consulta «Cómo acceder a los datos históricos de la cadena de bloques».
¿Cómo gestiona el streaming las reorganizaciones de la cadena?
Las reorganizaciones son la parte más complicada a la hora de consumir datos en tiempo real de una cadena de bloques, ya que un bloque que tu aplicación ya haya procesado puede ser sustituido por un bloque competidor. Los servicios de transmisión en producción gestionan esto entregando los datos en orden de finalidad y, cuando se produce una reorganización, enviando cargas útiles de corrección que indican al destino qué bloques ya no son canónicos, de modo que pueda revertir los registros afectados. Esto elimina uno de los elementos más propensos a errores de los flujos de trabajo personalizados. Obtén más información sobre qué es una reorganización de la cadena de bloques.
¿En qué se diferencia el streaming de la indexación?
El streaming y la indexación resuelven problemas relacionados, pero distintos. El streaming se centra en la transmisión: hacer llegar los datos de la cadena de bloques a su destino en tiempo real. La indexación se centra en la organización: estructurar esos datos en una base de datos consultable para que puedas realizar consultas rápidas sobre datos históricos y agregados. Muchos equipos utilizan el streaming para alimentar un índice y, a continuación, consultan dicho índice con fines analíticos. Consulta los artículos «¿Qué es la indexación de la cadena de bloques? » y «Consultas de datos de la cadena de bloques» para comprender cómo encajan todas las piezas.
Preguntas frecuentes
¿La transmisión de datos mediante blockchain es lo mismo que una suscripción a WebSocket?
No del todo. Una suscripción WebSocket es una conexión de bajo nivel que envía eventos de forma proactiva mientras el socket permanece abierto, pero no ofrece garantías de entrega y se interrumpe si se pierde la conexión. La transmisión en producción añade, además de ese modelo básico de envío proactivo, la entrega «exactamente una vez», el orden de finalidad, las correcciones de reorganización, el filtrado del lado del servidor y la recuperación histórica de datos.
¿El streaming garantiza que no me perderé ningún bloque?
Sí, con un servicio de producción. La entrega garantizada significa que el proveedor almacena los datos en búfer y vuelve a intentarlo hasta que se confirme la recepción de los datos de cada bloque en tu destino, de modo que recibas una transmisión ininterrumpida incluso si tu endpoint sufre una breve interrupción del servicio. Los servicios de eventos basados en envíos push, como Quicknode Webhooks aplican los mismos principios de fiabilidad a las notificaciones de eventos.
¿Puedo filtrar los datos en tiempo real antes de que lleguen a su destino?
Sí. El filtrado del lado del servidor te permite realizar filtrados por direcciones, firmas de eventos, selectores de funciones, valores o cualquier otra propiedad del bloque, de modo que solo se entregan los registros que te interesan. Esto reduce los costes de ancho de banda, almacenamiento y procesamiento, ya que nunca recibes los datos que no necesitas.
¿Puede el streaming sustituir a un proceso ETL personalizado?
Para la mayoría de los equipos, sí. Un servicio de streaming gestionado agrupa la extracción, el filtrado, la transformación, la entrega, los reintentos, la ordenación y la gestión de reorganizaciones en un único proceso, lo que elimina los numerosos componentes de una pila ETL desarrollada internamente. Tú configuras qué datos quieres y adónde van, y el proveedor se encarga del resto.
¿A qué destinos se pueden enviar los datos de streaming?
Entre los destinos más habituales se encuentran las URL de webhooks, PostgreSQL, Snowflake, Amazon S3 y Azure Blob Storage, entre otros. Esto te permite integrar los datos en tiempo real directamente en el backend de tu aplicación, en tu almacén de datos o en tu almacenamiento de objetos sin necesidad de crear conectores personalizados para cada uno de ellos.