Respuestas>Más información sobre la transmisión de datos en blockchain>Sondeo frente a transmisión de datos de blockchain
Recopilación de datos de la cadena de bloques frente a transmisión en tiempo real
// Tags
Polling frente a streaming WebSocket y blockchain
En resumen: El «polling» es un patrón basado en el «pull», en el que tu aplicación solicita repetidamente nuevos datos a un nodo de la cadena de bloques a intervalos fijos. El «streaming» es un patrón basado en el «push», en el que los nuevos datos se envían automáticamente a tu aplicación a medida que se generan en la cadena de bloques. El «polling» es sencillo de implementar, pero desperdicia recursos, introduce latencia y conlleva el riesgo de perder datos. El «streaming» es más eficiente, más rápido y más fiable a gran escala, pero requiere una infraestructura diferente. Para la mayoría de las aplicaciones de cadena de bloques en producción, el streaming es el enfoque más adecuado para la ingesta de datos.
La explicación sencilla
Toda aplicación basada en blockchain necesita saber cuándo ocurre algo en la cadena de bloques. Un monedero necesita saber cuándo su usuario recibe una transferencia. Un protocolo DeFi necesita detectar cuándo se actualiza un oráculo de precios. Un bot de trading necesita detectar las nuevas transacciones en el momento en que se incorporan a un bloque. Una plataforma de análisis necesita procesar cada bloque a medida que se genera. La pregunta es: ¿cómo se entera tu aplicación de estos eventos?
Con el sondeo, tu aplicación ejecuta un bucle: llama al RPC endpoint, comprueba si ha habido alguna novedad, procesa los datos nuevos, espera un intervalo fijo y repite. Este es el patrón que la mayoría de los desarrolladores aprenden primero, ya que se corresponde de forma natural con el funcionamiento de las API HTTP. Configura un temporizador, realiza una solicitud cada N segundos y gestiona la respuesta. No requiere ninguna infraestructura especial más allá de la capacidad de realizar solicitudes HTTP.
Con el streaming, tu aplicación establece una conexión o configura un canal de datos una sola vez, y los nuevos datos llegan automáticamente. No hay bucles, ni temporizadores, ni solicitudes repetidas. Cuando se genera un nuevo bloque, los datos fluyen hacia tu aplicación sin que esta los solicite. La función de la aplicación consiste simplemente en procesar los datos entrantes a medida que llegan.
Cómo funcionan las encuestas en la práctica
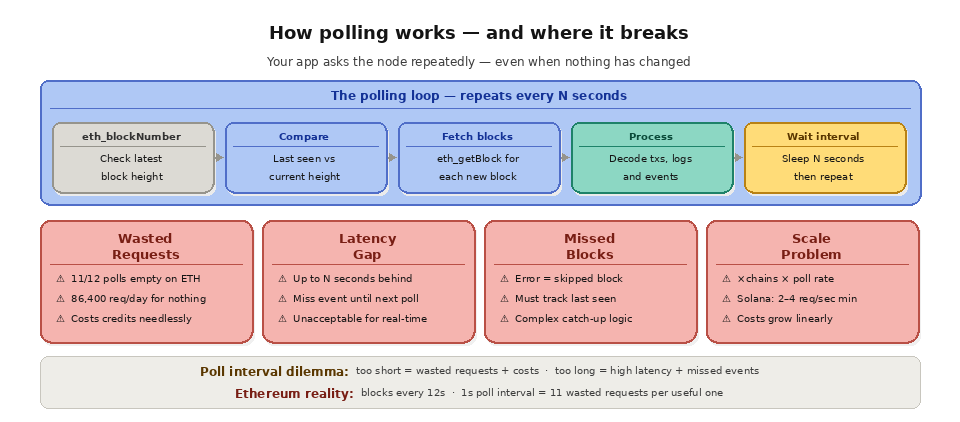
Una implementación típica de sondeo para supervisar los nuevos bloques es la siguiente: tu aplicación llama a «eth_blockNumber» para obtener el último bloque, lo compara con el último bloque que procesó, recupera cualquier bloque nuevo mediante «eth_getBlockByNumber», extrae los datos que necesita y programa el siguiente sondeo. Cada iteración requiere como mínimo una llamada RPC (para comprobar el número del último bloque) y, potencialmente, muchas más (para recuperar los datos completos del bloque, los recibos de las transacciones y los registros de eventos de cada nuevo bloque).
El intervalo de sondeo es una decisión de diseño fundamental. Si se realiza el sondeo con demasiada frecuencia, se desperdician solicitudes RPC (y créditos) preguntando «¿hay algo nuevo?» cuando la respuesta es «no». En Ethereum, donde se generan bloques cada 12 segundos, realizar un sondeo cada segundo significa que 11 de cada 12 solicitudes no devuelven nada útil. Si las consultas son demasiado espaciadas, se introduce latencia. Si el intervalo es de 30 segundos, es posible que no se detecte un nuevo bloque hasta 30 segundos después de su generación. También se podrían procesar varios bloques por intervalo, lo que generaría una carga desigual en el sistema.
El sondeo conlleva varios riesgos de fiabilidad. Si un sondeo falla debido a un error de red, un límite de frecuencia o un problema en un nodo, tu aplicación podría perderse un bloque por completo, a menos que realice un seguimiento del número del último bloque procesado y retroceda hasta él en el siguiente sondeo que se realice con éxito. Si tu aplicación se bloquea o se reinicia, debe determinar en qué punto se quedó y reanudarse desde ahí, gestionando cualquier bloque generado durante el tiempo de inactividad. Si el proceso de sondeo se retrasa debido a demoras en el procesamiento, la diferencia entre la punta de la cadena y el estado de tu aplicación aumenta, y para ponerse al día es necesario procesar una acumulación de bloques pendientes.
En las cadenas de alto rendimiento, el sondeo se vuelve especialmente problemático. Solana genera ranuras cada 400 ms. Arbitrum y Base generan bloques cada 250 ms. Sondear estas cadenas a su ritmo de generación de bloques requiere entre 2 y 4 solicitudes RPC por segundo solo para comprobar los números de bloque, además de solicitudes adicionales para obtener los datos completos de los bloques. A gran escala, con múltiples cadenas, el volumen (y el coste) de las solicitudes RPC crece linealmente con el número de cadenas y el ritmo de generación de bloques de cada una.
Cómo funciona el streaming en la práctica
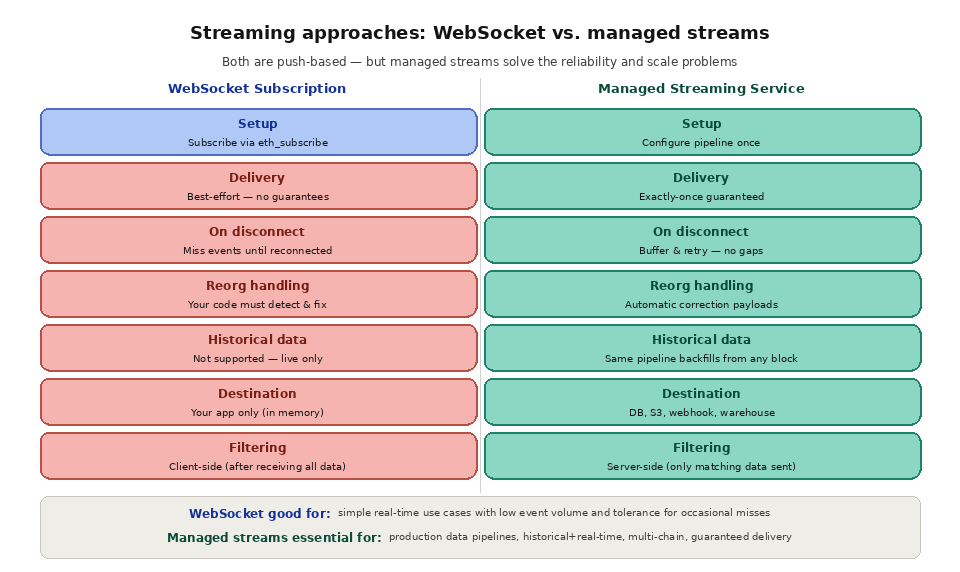
Las suscripciones WebSocket son la forma más sencilla de transmisión en tiempo real de la cadena de bloques. Tu aplicación abre una conexión WebSocket persistente con un nodo y envía una solicitud de suscripción (como «eth_subscribe» con «newHeads»). El nodo envía cada nueva cabecera de bloque a tu aplicación a través de la conexión abierta tan pronto como se genera. Sin sondeos, sin solicitudes innecesarias, sin retrasos.
Los WebSockets funcionan bien para casos de uso sencillos, pero presentan limitaciones importantes a gran escala. Las conexiones son con estado y pueden interrumpirse debido a problemas de red, reinicios del servidor o tiempos de espera por inactividad. Cuando se interrumpe una conexión, la aplicación pierde cualquier evento que se produzca antes de la reconexión, y debe detectar la desconexión, volver a conectarse y recuperar los datos perdidos. La gestión de múltiples conexiones WebSocket simultáneas en varias cadenas añade complejidad. Las suscripciones a WebSockets tampoco admiten datos históricos. Si necesitas procesar bloques de la semana pasada, los WebSockets no te servirán de ayuda.
Los servicios de streaming diseñados específicamente para este fin resuelven estas limitaciones. En lugar de mantener frágiles conexiones WebSocket, tu aplicación configura un canal de datos que el servicio de streaming gestiona de extremo a extremo. El servicio se conecta a los nodos de la cadena de bloques, procesa cada bloque, aplica tus filtros y entrega los resultados a tu destino con entrega garantizada. Si tu destino no está disponible temporalmente, el servicio almacena los datos en el búfer y vuelve a intentarlo. Si se produce una reorganización, el servicio envía cargas útiles de corrección. Si necesitas datos históricos, ese mismo canal puede recuperar datos desde cualquier bloque inicial.
Comparación de los dos enfoques
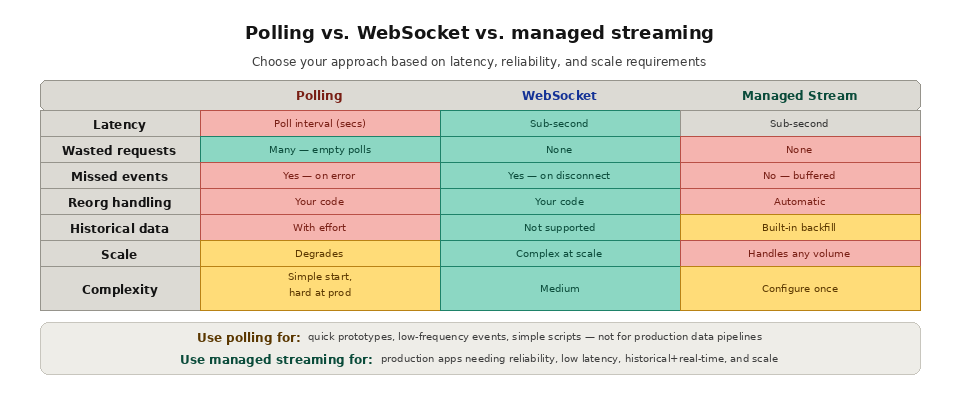
La latencia es la diferencia más evidente. En el mejor de los casos, el sondeo siempre tiene una latencia igual al intervalo de sondeo, aunque en la práctica suele ser mayor debido al tiempo de procesamiento y a la recuperación de errores. La transmisión en continuo proporciona los datos tan pronto como están disponibles, normalmente a los pocos segundos de que se genere un bloque. Para aplicaciones en las que la latencia es un factor crítico, como los bots de negociación o los paneles de control en tiempo real, la transmisión en continuo resulta significativamente más rápida.
La eficiencia en el uso de los recursos es la segunda gran diferencia. El sondeo genera un volumen de solicitudes proporcional a la frecuencia del sondeo, independientemente de si existen datos nuevos. Un proceso de sondeo que comprueba si hay nuevos bloques cada segundo realiza 86 400 solicitudes al día, aunque solo le interese un evento específico que se produce una vez a la semana. La transmisión en tiempo real consume recursos proporcionales al volumen real de datos. Si no ocurre nada que se ajuste a tus criterios de filtrado, no se envía nada y no se consumen recursos por tu parte.
La fiabilidad es lo que distingue ambos enfoques a gran escala. El método de sondeo requiere que tu aplicación mantenga su propio seguimiento del estado, detección de lagunas, recuperación de errores y lógica de puesta al día. Cada caso extremo (bloques perdidos, procesamiento duplicado, reorganizaciones, límites de velocidad, conmutación por error de nodos) debe gestionarse en tu código. Los servicios de streaming gestionan estos casos extremos por parte del proveedor, proporcionando un flujo sin lagunas, ordenado y deduplicado que tu aplicación puede procesar sin preocuparse por la fiabilidad de la infraestructura.
La complejidad es la contrapartida. El sondeo es más sencillo de implementar al principio. Un bucle básico de sondeo se puede escribir en 20 líneas de código. Pero esa simplicidad es engañosa, ya que el sondeo optimizado para producción requiere gestión de errores, lógica de retroceso, gestión de estados, detección de reorganizaciones y supervisión, lo que puede suponer cientos de líneas de código. El streaming requiere una configuración inicial de un canal de datos y un sistema de destino capaz de recibir datos enviados (como un servidor de webhooks o una base de datos con la lógica de ingestión adecuada), pero, una vez configurado, requiere mucho menos mantenimiento continuo.
¿Cuál es la diferencia entre la lectura por sondeo y la transmisión en continuo?
El sondeo y la transmisión en tiempo real resuelven el mismo problema: incorporar datos actualizados de la cadena de bloques a tu aplicación, pero invierten el control flow. Con el sondeo, tu código es la parte activa: llama repetidamente a una RPC endpoint y pregunta si ha habido algún cambio. Con la transmisión en tiempo real, el proveedor es la parte activa, y te envía cada nuevo bloque o evento correspondiente en el momento en que se produce. La tabla siguiente compara los dos patrones en los aspectos que más importan en producción.
Dimensión
Encuestas
Streaming
Datos flow
Basada en la recuperación de datos: tu aplicación solicita datos
Basado en notificaciones push: los datos se envían automáticamente
Latencia
Igual o superior al intervalo de muestreo
En cuestión de segundos tras el inicio de la producción en serie
Uso de recursos
Proporcional a la frecuencia de sondeo, incluso en reposo
Proporcional al volumen real de datos
Fiabilidad a gran escala
Tu aplicación gestiona las lagunas, los reintentos y las reorganizaciones
El proveedor ofrece un flujo de datos ordenado y sin duplicados
Datos históricos
Con el apoyo de nuevas consultas sobre bloques anteriores
Con el respaldo del relleno de la misma tubería
Complejidad de la configuración
Fácil al principio, costoso de reforzar
Se configura una sola vez y requiere poco mantenimiento continuo
Ideal para
Scripts sencillos y comprobaciones poco frecuentes
Aplicaciones en tiempo real y cadenas de alto rendimiento
¿Cómo se elige un intervalo de sondeo?
Si realizas un sondeo, el intervalo debe ajustarse al tiempo de bloque de la cadena que estás leyendo. Realizar sondeos a un ritmo mucho más rápido que el de generación de bloques supone un desperdicio de solicitudes y puede activar la limitación de frecuencia, mientras que hacerlo a un ritmo mucho más lento que el tiempo de bloque añade una latencia evitable y obliga a tu trabajador a procesar varios bloques a la vez. La tabla siguiente recoge los tiempos de bloque habituales y las implicaciones prácticas que esto tiene para el sondeo en cada red.
Blockchain
Duración aproximada del bloque
Implicaciones de las encuestas
Bitcoin
Unos 10 minutos
Un intervalo de entre 1 y 2 minutos es más que suficiente
Ethereum
Unos 12 segundos
Realiza consultas cada 4 a 12 segundos para mantenerte al día sin desperdiciar recursos
BNB Smart Chain
Unos 3 segundos
El sondeo de subbloques supone una carga adicional con escasos beneficios
Base
Unos 250 ms
La recopilación de datos no puede seguir el ritmo con precisión; prefiero el streaming.
Solana
Unos 400 ms
Gran volumen de solicitudes; se recomienda encarecidamente el streaming
¿En qué casos conviene seguir utilizando el sondeo?
El streaming es la mejor opción por defecto para la mayoría de las cargas de trabajo de producción, pero el polling sigue siendo una opción razonable en algunos casos. Los scripts puntuales, los rellenos retrospectivos y los trabajos por lotes poco frecuentes rara vez justifican una canalización gestionada. El sondeo también es adecuado cuando solo se necesita un único valor bajo demanda, como una comprobación de saldo antes de una acción del usuario, en la que no hay un flujo continuo al que suscribirse. Sin embargo, cuando la actualidad y el volumen sí importan, la balanza se inclina rápidamente, por lo que conviene comprender la diferencia entre datos en tiempo real y datos históricos antes de decantarse por un enfoque.
¿Cómo gestiona el streaming las reorganizaciones y la pérdida de datos?
Lo más complicado a la hora de consumir datos en tiempo real de una cadena de bloques no es el escenario ideal, sino los casos extremos. Una reorganización de la cadena puede sustituir un bloque que tu aplicación ya haya procesado, y una conexión interrumpida puede dejar un hueco en tus datos. Con el sondeo sin procesar o los WebSockets, debes detectar y solucionar estas situaciones por tu cuenta. Un servicio gestionado como Quicknode Streams se encarga de ello por ti: entrega los datos en orden de finalidad, emite cargas útiles de corrección cuando se produce una reorganización y almacena en búfer y vuelve a intentarlo cuando tu destino no está disponible. Esa diferencia es lo que hace que la entrega basada en notificaciones push sea mucho más fácil de gestionar a gran escala.
Preguntas frecuentes
¿Es el streaming siempre mejor que las encuestas?
No siempre. Para la mayoría de las aplicaciones de producción que necesitan datos continuos y de baja latencia, la transmisión en tiempo real destaca por su eficiencia y fiabilidad. Sin embargo, para scripts puntuales, comprobaciones de saldo sencillas o tareas de baja frecuencia, el sondeo es perfectamente adecuado y más fácil de configurar. La elección correcta depende de la actualidad que deban tener los datos y del volumen que se procese. Para obtener una introducción al modelo basado en «push», consulta qué es la transmisión de datos en blockchain.
¿Con qué frecuencia debo realizar una consulta a un servidor RPC endpoint?
Adapta tu intervalo de consulta al tiempo de bloque de la cadena. En Ethereum, realizar consultas cada 4 a 12 segundos te mantiene al día sin desperdiciar llamadas. En cadenas rápidas como Solana o Base, realizar consultas a la frecuencia de los bloques no es práctico y la transmisión en continuo es la mejor opción. Realizar consultas mucho más rápido de lo que se producen los bloques suele no arrojar datos nuevos y agota el presupuesto de solicitudes. Consulta cómo funcionan las solicitudes RPC para saber en qué consiste cada llamada.
¿Cuesta más la recopilación de datos que el streaming?
A menudo ocurre así a gran escala. El sondeo genera solicitudes según un horario fijo, independientemente de si hay datos nuevos o no, por lo que un proceso de sondeo muy activo puede realizar decenas de miles de llamadas al día para capturar solo unos pocos eventos. El streaming consume recursos en proporción a los datos que realmente cumplen tus filtros, lo que suele traducirse en menos solicitudes innecesarias y un menor coste para las cargas de trabajo continuas.
¿Qué ocurre con mis datos durante una reorganización?
Con un sondeo simple o WebSockets sin procesar, una reorganización puede hacer que tu aplicación retenga transacciones que ya no existen en la cadena canónica. Un servicio de streaming gestionado detecta la reorganización y envía cargas útiles de corrección para que tu estado se mantenga coherente. Comprender la diferencia entre el rendimiento y la latencia también te ayuda a decidir cuánto tiempo debes esperar antes de considerar los datos como confirmados.
¿Puedo obtener datos históricos de un servicio de streaming?
Sí. A diferencia de las suscripciones WebSocket, que solo envían nuevos eventos a partir del momento en que te conectas, un canal de streaming completo puede recuperar datos de cualquier bloque anterior utilizando la misma configuración. Esto te permite reproducir el historial y, a continuación, pasar sin interrupciones a los datos en tiempo real sin necesidad de ejecutar dos sistemas independientes.
Cómo « Quicknode » es compatible con ambos patrones
QuicknodeLa API principal de 's admite tanto el sondeo a través de puntos finales HTTP RPC como las suscripciones en tiempo real mediante conexiones WebSocket en todas las cadenas compatibles. Para las aplicaciones que utilizan el sondeo, la guía de Quicknode sobre solicitudes RPC eficientes recoge las mejores prácticas para minimizar las llamadas innecesarias, implementar una gestión adecuada de los errores y gestionar los límites de frecuencia.
Para aplicaciones que estén listas para ir más allá del sondeo, Quicknode Streams ofrece un canal de streaming totalmente gestionado. Streams proporciona datos de blockchain en tiempo real con entrega garantizada, procesamiento por orden de finalidad, gestión automática de reorganizaciones y filtrado del lado del servidor, todo ello sin que tu aplicación tenga que mantener conexiones WebSocket ni infraestructura de sondeo. Streams admite la entrega a webhooks, PostgreSQL, Snowflake, Amazon S3, Azure Storage y más, lo que lo hace adaptable a cualquier arquitectura de backend. En la documentación de Quicknode hay disponible una guía de comparación directa entre las suscripciones WebSocket y Streams , que aborda las ventajas e inconvenientes y la ruta de migración para los equipos que están pasando de arquitecturas basadas en sondeo o WebSocket.