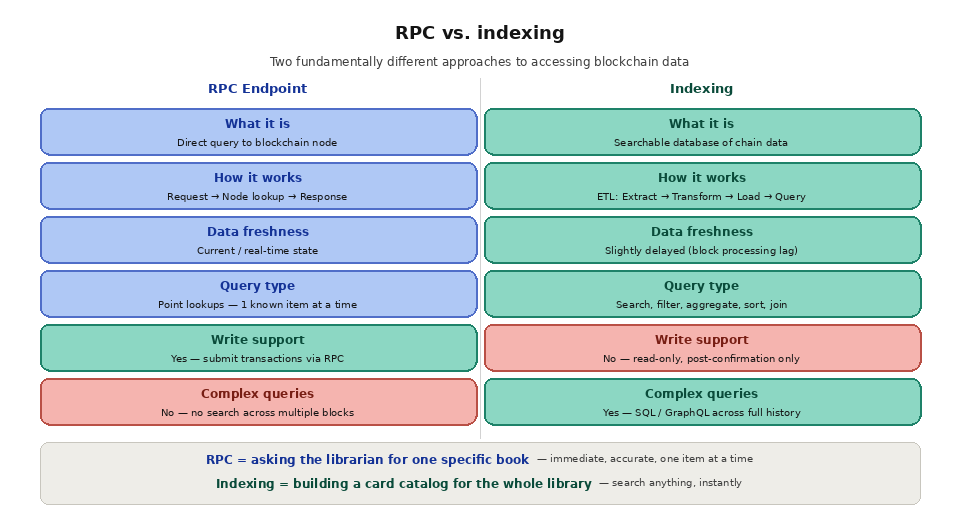
요약: RPC와 인덱싱은 블록체인 데이터에 접근하는 두 가지 근본적으로 다른 방식입니다. RPC 엔드포인트를 사용하면 한 번에 하나의 요청씩 블록체인의 현재 상태를 실시간으로 조회할 수 있습니다. 인덱싱은 블록체인 데이터를 추출하고 변환하여 검색 가능한 데이터베이스에 저장하므로, 애플리케이션이 과거 기록을 대상으로 복잡한 쿼리를 실행할 수 있게 해줍니다. RPC는 사서에게 특정 책 한 권을 찾아달라고 요청하는 것과 같습니다. 인덱싱은 도서관 전체를 위한 카드 카탈로그를 만드는 것과 같습니다. 대부분의 운영 환경 애플리케이션에는 이 두 가지가 모두 필요합니다.
간단한 설명
모든 블록체인 애플리케이션에는 데이터가 필요합니다. 지갑에는 계정 잔액이 필요하고, DeFi 대시보드에는 토큰 가격과 유동성 풀 상태가 필요하며, NFT 마켓플레이스에는 소유권 기록과 거래 내역이 필요합니다. 분석 플랫폼에는 수천 개의 계약과 수백만 건의 거래에 걸친 집계 지표가 필요합니다. 문제는 블록체인에서 해당 데이터를 애플리케이션으로 어떻게 가져올 것인가 하는 것입니다.
RPC 엔드포인트는 블록체인의 기본 인터페이스입니다. 애플리케이션이 노드에 JSON-RPC 요청을 보내면, 이는 블록체인의 현재 또는 최근 상태에 대해 직접적인 질문을 하는 것입니다. 예를 들어, ‘이 지갑의 현재 잔액은 얼마인가’, ‘이 특정 거래에서 무슨 일이 일어났는가’, ‘블록 번호 20,000,000에는 무엇이 포함되어 있는가’와 같은 질문들입니다. 노드는 해당 답변을 조회하여 반환합니다. RPC는 특정 항목 조회에 있어 즉각적이고 정확하며 직관적입니다. 하지만 RPC에는 중대한 한계가 있습니다. RPC 메서드는 특정하고 알려진 데이터를 가져오기 위해 설계되었을 뿐, 체인 전반에 걸친 검색이나 집계에는 적합하지 않습니다. “지난 30일 동안 이 지갑에서 발생한 모든 거래를 찾아라” 또는 “거래량 기준 상위 10개 유동성 풀을 보여줘”와 같은 요청을 처리할 수 있는 RPC 메서드는 존재하지 않습니다.
인덱싱은 원시 블록체인 데이터 위에 검색 가능한 데이터베이스를 구축함으로써 이러한 공백을 메워줍니다. 인덱서는 블록이 생성되는 즉시 이를 읽어들이고, 트랜잭션과 이벤트 로그를 디코딩한 뒤, 원시 데이터를 구조화된 레코드로 변환하여 적절한 인덱스가 적용된 데이터베이스에 기록합니다. 인덱싱이 완료되면 애플리케이션은 SQL, GraphQL 또는 데이터베이스가 지원하는 기타 쿼리 언어를 사용하여 데이터를 조회할 수 있습니다. 이를 통해 복잡한 필터링, 집계, 정렬, 조인 및 전체 텍스트 검색이 모두 가능해집니다.
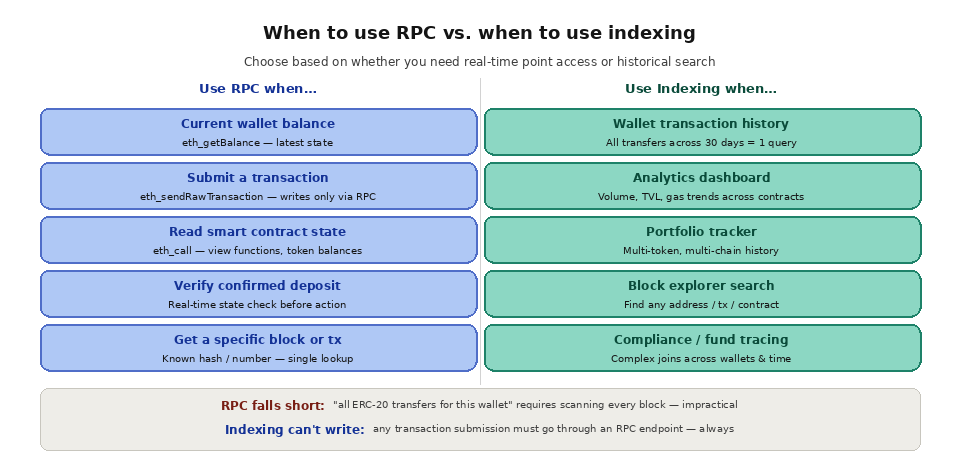
애플리케이션에서 특정하고 알려진 데이터를 실시간으로 읽거나 써야 할 때 RPC가 올바른 선택입니다. 지갑의 현재 ETH 잔액을 확인하는 것은 단 한 번의 "eth_getBalance" 호출로 가능합니다. 서명된 트랜잭션을 멥풀에 제출하려면 "eth_sendRawTransaction"이 필요합니다. 스마트 계약의 뷰 함수에서 반환 값을 읽으려면 "eth_call"을 사용합니다. 이 모든 것은 원하는 내용을 정확히 알고 있으며, RPC 메서드가 이를 직접 반환할 수 있는 포인트 쿼리입니다.
RPC는 쓰기 작업에 있어서도 유일한 옵션입니다. 인덱서를 통해 트랜잭션을 제출할 수는 없습니다. 인덱서는 데이터가 체인에 커밋된 후에 이를 처리하는 읽기 전용 시스템입니다. 애플리케이션에서 트랜잭션을 전송하거나, 토큰을 승인하거나, 스마트 계약과 상호 작용하거나, 상태를 변경하는 작업을 브로드캐스트해야 할 때마다 반드시 RPC endpoint 를 거쳐야 합니다.
실시간 상태 확인은 RPC의 또 다른 강점입니다. DeFi 프로토콜이 청산을 실행하기 전에 사용자의 담보 비율을 확인해야 하거나, 브리지가 입금 확인 여부를 검증해야 할 때, RPC를 통해 노드의 현재 상태를 조회합니다. 응답에는 최신 정식 블록이 반영되어 데이터가 가능한 한 최신 상태임을 보장합니다.
RPC가 한계가 드러나는 부분은 여러 블록이나 계약에 걸쳐 데이터를 스캔, 필터링 또는 집계해야 하는 쿼리입니다. “이 주소가 관련된 모든 ERC-20 전송 내역을 보여줘”라는 요청을 처리하려면 모든 블록을 순회하며 모든 거래 영수증을 확인해야 하는데, 이는 RPC만으로는 계산상 실현 불가능합니다. "지난 24시간 동안 유니스왑 V3의 총 거래량은 얼마인가"라는 질문은 수십 개의 풀 계약에 걸친 수천 개의 블록에서 이벤트 로그를 해독하고 합산해야 합니다. 이는 인덱싱 문제입니다.
인덱싱을 사용할 때
애플리케이션에서 블록체인 데이터를 검색, 필터링, 정렬 또는 집계해야 할 때마다 인덱싱은 필수적입니다. 여러 토큰과 체인에 걸친 사용자의 전체 거래 내역을 표시하는 포트폴리오 추적 도구는 인덱싱된 데이터에 의존합니다. 거래량, TVL 추세, 가스 사용 패턴 및 프로토콜 지표를 보여주는 분석 대시보드는 전적으로 인덱싱된 데이터베이스 위에 구축됩니다. Etherscan과 같은 블록 탐색기는 전체 체인을 인덱싱하여 사용자가 어떤 주소, 거래 또는 계약이든 검색할 수 있도록 합니다.
역사적 분석은 인덱싱의 또 다른 핵심 활용 사례입니다. 예를 들어, 규정 준수 담당자( equipe )가 6개월 동안 일련의 지갑을 거쳐 자금이 이동한 경로( flow )를 추적해야 하는 경우, 복잡한 조인(join)과 필터링을 통해 인덱싱된 거래 데이터를 쿼리해야 합니다. 또한, 리서치 회사가 1년 치의 이더리움( Ethereum ) 블록에 걸친 MEV 추출 패턴을 분석하고자 한다면, 거래, 추적 정보, 이벤트 로그를 포괄적으로 인덱싱해야 하며, 이러한 쿼리에 따른 계산 부하는 블록체인 노드가 아닌 데이터베이스에서 처리되어야 합니다.
이벤트 주도형 아키텍처 역시 인덱싱의 이점을 누릴 수 있습니다. 특정 스마트 계약 이벤트가 발생했는지 감지하기 위해 RPC 엔드포인트를 폴링하는 대신, 인덱서는 새로운 블록을 지속적으로 처리하여 일치하는 이벤트를 실시간으로 애플리케이션에 전달할 수 있습니다. 이는 연결이 끊어져 이벤트를 놓칠 수 있는 WebSocket 구독보다 더 안정적이며, 빈 응답으로 인해 요청을 낭비하는 HTTP 폴링보다 더 효율적입니다.
두 가지를 함께 사용하기
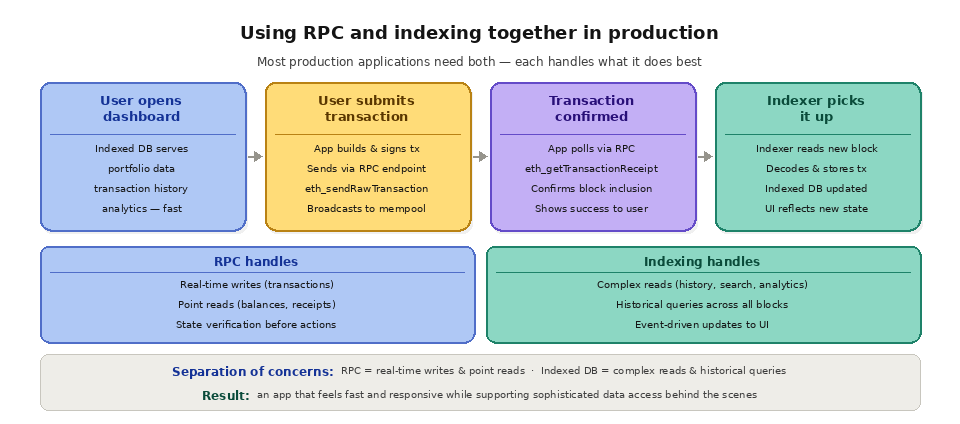
대부분의 생산 환경 블록체인 애플리케이션은 RPC와 인덱싱을 함께 사용합니다. 사용자에게 제공되는 읽기 기능(포트폴리오 가치, 거래 내역, 분석 대시보드, 검색 결과 등)은 일반적으로 인덱싱된 데이터를 기반으로 합니다. 사용자가 특정 작업(거래 전송, 토큰 스왑, NFT 발행)을 수행하면, 애플리케이션은 RPC로 전환하여 네트워크에 거래를 제출하고 해당 거래가 포함되었는지 확인합니다. 거래가 확인되면 인덱서가 새로운 블록에서 해당 거래를 가져와 데이터베이스를 업데이트하며, 이 변경 사항은 UI에 반영됩니다.
이 아키텍처는 관심사를 명확하게 분리합니다. RPC는 실시간 쓰기 및 특정 지점 읽기를 처리합니다. 인덱스 기반 데이터베이스는 복잡한 읽기 작업과 과거 데이터 쿼리를 처리합니다. 그 결과, 사용자에게는 빠르고 반응성이 뛰어난 애플리케이션으로 느껴지면서도, 내부적으로는 정교한 데이터 액세스 패턴을 지원합니다.
RPC와 인덱싱의 차이점은 무엇인가요?
간단히 말해, RPC endpoint 는 현재 상태나 특정 상태에 대한 직접적인 질문에 답하는 반면, 블록체인 인덱싱은 체인을 검색 및 집계할 수 있는 데이터베이스로 사전 처리합니다. 아래 표에는 이러한 실질적인 차이점을 나란히 정리해 두었습니다.
양상
RPC
색인 생성
액세스 패턴
한 가지 요청, 한 가지 답변
검색, 필터링 및 집계
데이터 최신성
실시간, 최신 블록
체인 끝부분보다 약간 뒤처짐
역사적 깊이
아카이브 노드가 필요합니다
저장되어 있으며 즉시 조회 가능
쓰기 지원
네, 작성하는 유일한 방법은
아니요, 읽기 전용입니다
설치 작업
로우, 전화 좀 해 endpoint
파이프라인을 더 확장하거나, 직접 구축하거나, 구매하기
다음에 가장 적합합니다
실시간 읽기 및 트랜잭션
분석, 기록 및 검색
이전 기록에 대한 쿼리의 경우, 인덱서가 RPC보다 더 빠를까요?
여러 블록에 걸쳐 있는 모든 정보에 대해서는 그렇습니다. RPC 노드에 지갑의 전체 내역을 요청하면 블록을 하나씩 스캔해야 하는 반면, 인덱서는 이미 해당 데이터를 디코딩하여 저장해 두었기 때문에 동일한 요청도 단 한 번의 빠른 쿼리로 처리됩니다. 내역이 오래될수록 이 차이는 더욱 커집니다. 블록체인 데이터 쿼리가 왜 어려운지, 그리고 실시간 데이터와 과거 데이터가 서로 상반된 방향으로 작용하는 이유를 확인해 보세요.
쿼리 유형
최고의 도구
왜
현재 잔액 또는 현황
RPC
직접적이고 실시간으로
거래 제출하기
RPC
RPC만 쓰기 권한이 있습니다
지갑 거래 내역
색인 생성기
블록 간 검색이 필요합니다
프로토콜 총 자산 규모 또는 TVL
색인 생성기
시간에 따른 집계 필요
라이브 신규 블록 이벤트
RPC 또는 스트리밍
저지연 푸시
RPC를 기반으로 블록체인 인덱서를 구축할 수 있나요?
네, 거의 모든 인덱서가 그렇게 작동합니다. 인덱서는 RPC나 스트리밍 피드를 통해 체인을 읽은 뒤, 각 블록을 디코딩하고 구조화된 행을 자체 데이터베이스에 기록합니다. 어려운 부분은 리오그, 재시도, 간극을 안정적으로 처리하는 것인데, 이 때문에 많은 팀이 직접 RPC 폴링 루프를 구현하는 대신 관리형 블록체인 데이터 스트리밍 파이프라인을 사용합니다.
인덱싱이 RPC를 대체하나요?
아닙니다. 인덱싱과 RPC는 Web3 인프라 스택에서 서로 보완적인 계층입니다. RPC는 트랜잭션을 제출하고 최신 상태를 조회하는 유일한 수단인 반면, 인덱싱은 검색, 이력 조회 및 분석 기능을 지원합니다. 실제 운영 중인 앱은 쓰기 작업과 실시간 조회 요청은 RPC로, 복잡한 조회 요청은 인덱스로 라우팅합니다.
자주 묻는 질문
인덱서를 통해 거래를 제출할 수 있나요?
아닙니다. 인덱서는 데이터가 체인에 확정된 후에 이를 처리하는 읽기 전용 시스템입니다. 모든 트랜잭션 제출은 RPC endpoint 를 거쳐야 합니다.
분석 쿼리의 경우 RPC가 왜 느린가요?
RPC는 호출 한 번당 알려진 데이터 한 건을 반환하며, 체인 전반에 걸쳐 데이터를 필터링하거나 집계할 수 없습니다. RPC를 통해 분석 질문에 답하려면 수천 번의 호출을 순차적으로 수행한 뒤 결과를 직접 결합해야 하는데, 이는 속도가 느리고 비용이 많이 듭니다.
RPC와 비교했을 때, 색인화된 데이터는 얼마나 최신 상태인가요?
인덱싱된 데이터는 인덱서에 따라 체인 끝부분보다 보통 몇 초에서 몇 분 정도 뒤처집니다. RPC는 최신 정식 블록을 반영하므로, 1초 미만의 최신 데이터를 얻으려면 여전히 노드에서 직접 읽어야 합니다.
색인 생성을 위해 아카이브 노드가 필요하신가요?
오래된 기록을 보충하려면 아카이브 노드나 보충 파이프라인에서 제공하는 아카이브 데이터가 필요합니다. 두 노드의 차이점에 대해서는 ‘풀 노드 대 아카이브 노드’를 참조하십시오.
The Graph는 인덱서인가요, 아니면 RPC 제공자인가요?
The Graph는 인덱싱 프로토콜입니다. 이 프로토콜의 인덱서는 RPC를 통해 체인을 읽은 후, 처리된 결과를 쿼리 가능한 서브그래프로 제공합니다. 이 프로토콜 자체로는 트랜잭션을 제출하거나 1초 미만의 실시간 데이터를 제공할 수 없습니다.
Quicknode 가 두 가지 모두를 지원하는 방법
Quicknode 이 방정식의 양측 모두를 위한 인프라를 제공합니다. Core API는 80개 이상의 체인에 걸쳐 전 세계적으로 분산된 저지연 RPC 액세스를 제공하며, 99.99%의 가동 시간을 유지하고 경쟁사보다 2.5배 빠른 응답 속도로 실시간 조회 및 트랜잭션 제출을 처리합니다. 개선된 API 메서드를 통해 토큰 잔액 조회나 NFT 컬렉션 조회와 같은 일반적인 작업에 필요한 개별 RPC 호출 횟수를 줄일 수 있습니다.
Quicknode Streams RPC와 인덱싱 간의 격차를 해소하여, 원시 또는 필터링된 블록체인 데이터를 데이터베이스, 데이터 웨어하우스 또는 웹훅으로 직접 전달하는 푸시 기반 데이터 파이프라인을 제공합니다. 인덱서에 데이터를 공급하기 위해 맞춤형 RPC 폴링 인프라를 구축하고 유지 관리할 필요 없이, 스트림(Stream)을 구성하기만 하면 Quicknode 에서 데이터 추출, 필터링, 전달, 재구성 보정 및 재시도 로직을 처리합니다. Streams 는 실시간 스트리밍과 과거 데이터 백필을 모두 지원하므로, 단일 도구로 인덱스를 제네시스 블록부터 채우고 최신 상태로 유지할 수 있습니다. 자체 인덱서를 구축해야 하는 팀을 위해, Quicknode 에서는 Streams 를 사용하여 PostgreSQL을 기반으로 한 완전한 블록체인 인덱서를 만드는 방법을 단계별로 설명하는 가이드를 공개하고 있습니다.