🤖 最新推出:《Quicknode 人工智慧實戰手冊》 10 個經過實測的 AI 程式設計食譜agents 。
查看食譜 已通過 SOC 2 Type II 認證 · ISO 27001
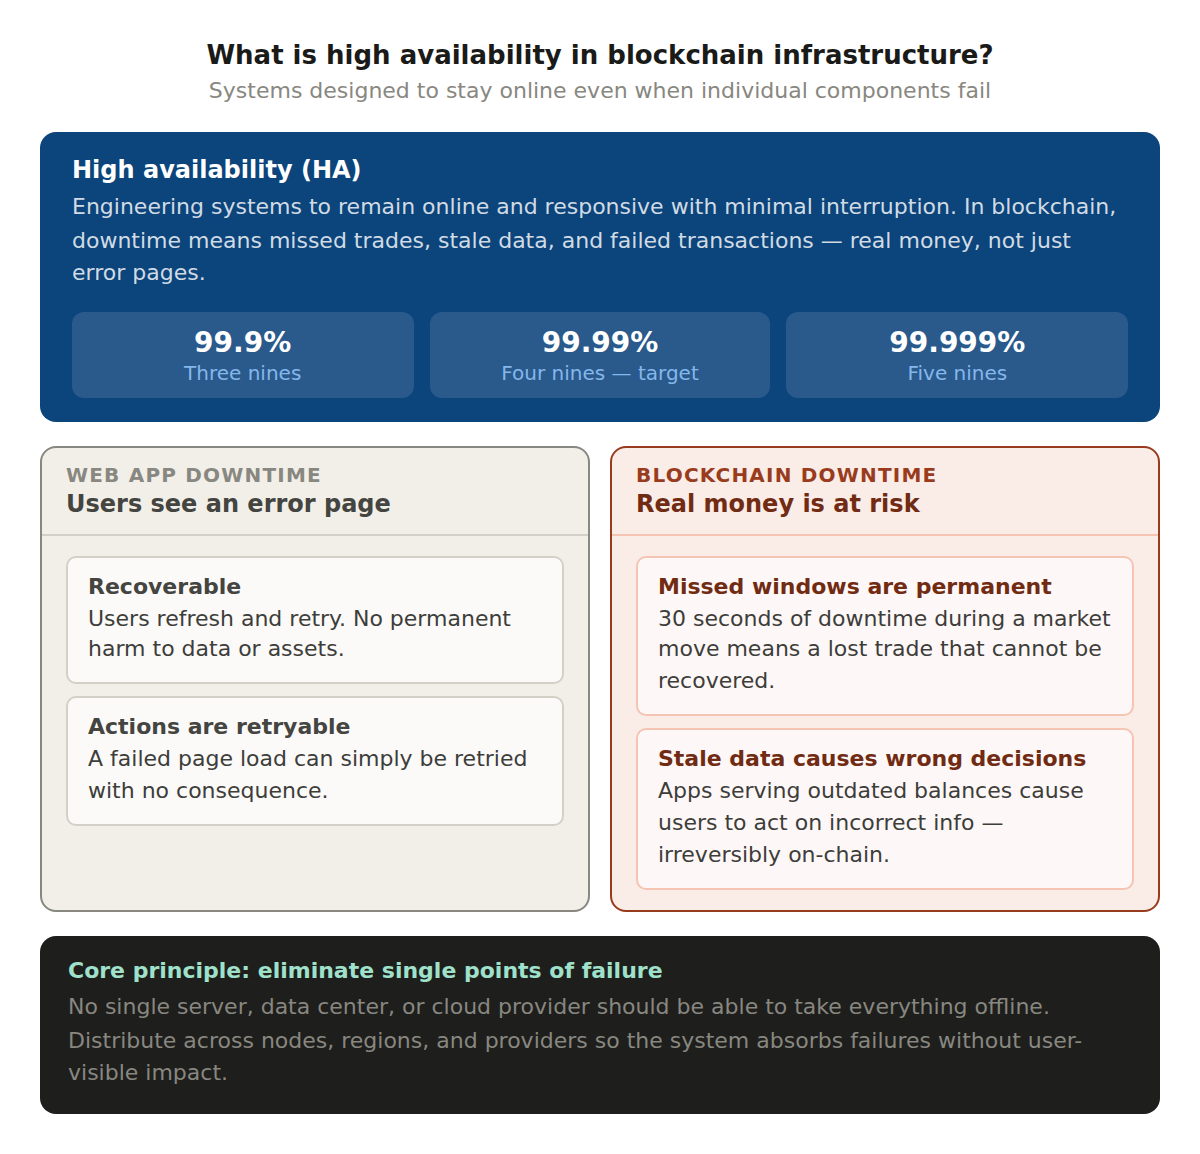
答案>了解可靠性與正常運作時間>區塊鏈基礎架構中的「高可用性」是什麼? 簡而言之:高可用性(HA)指的是即使個別組件發生故障,系統仍能保持線上運作並持續回應,且停機時間降至最低的設計。在區塊鏈基礎架構中,高可用性意味著您的 RPC 端點、節點和資料管道能持續可靠地處理請求,通常以 99.9% 或更高的正常運作時間為目標。
為何正常運作時間比您想像的更重要
當傳統的網路應用程式發生故障時,使用者會看到錯誤頁面。當區塊鏈基礎設施發生故障時,其後果可能遠比這嚴重得多。交易遺漏、資料過時、交易失敗以及未處理的事件,不僅會讓使用者感到沮喪,更會造成實際的金錢損失。
假設有一個依賴 RPCendpoint 來提交交易的 DeFi 交易機器人。如果在市場劇烈波動期間,該endpoint 即使僅離線 30 秒,該機器人便會完全錯失交易時機。又或者,試想一個因節點供應商發生服務中斷而無法查詢餘額的錢包應用程式。使用者無從得知自己的資金是否安全,而貴公司的客服諮詢量將因此暴增。
高可用性是一門旨在防止此類情況發生的工程學科。其意指設計出即使發生單一故障,也不會導致整個系統離線的系統。
在區塊鏈中,何謂高可用性?
區塊鏈中的高可用性,是指即使個別組件發生故障,仍能確保節點、RPC 端點及資料管道保持線上運作並能即時回應的實務做法。高可用性架構不會僅依賴單一節點或單一區域,而是將工作負載分散至冗餘組件上,確保單一故障絕不會導致整個服務癱瘓。此架構高度仰賴狀態良好且已同步的節點,因此節點可靠性與自動故障轉移是其核心構成要素。
高可用性如何運作
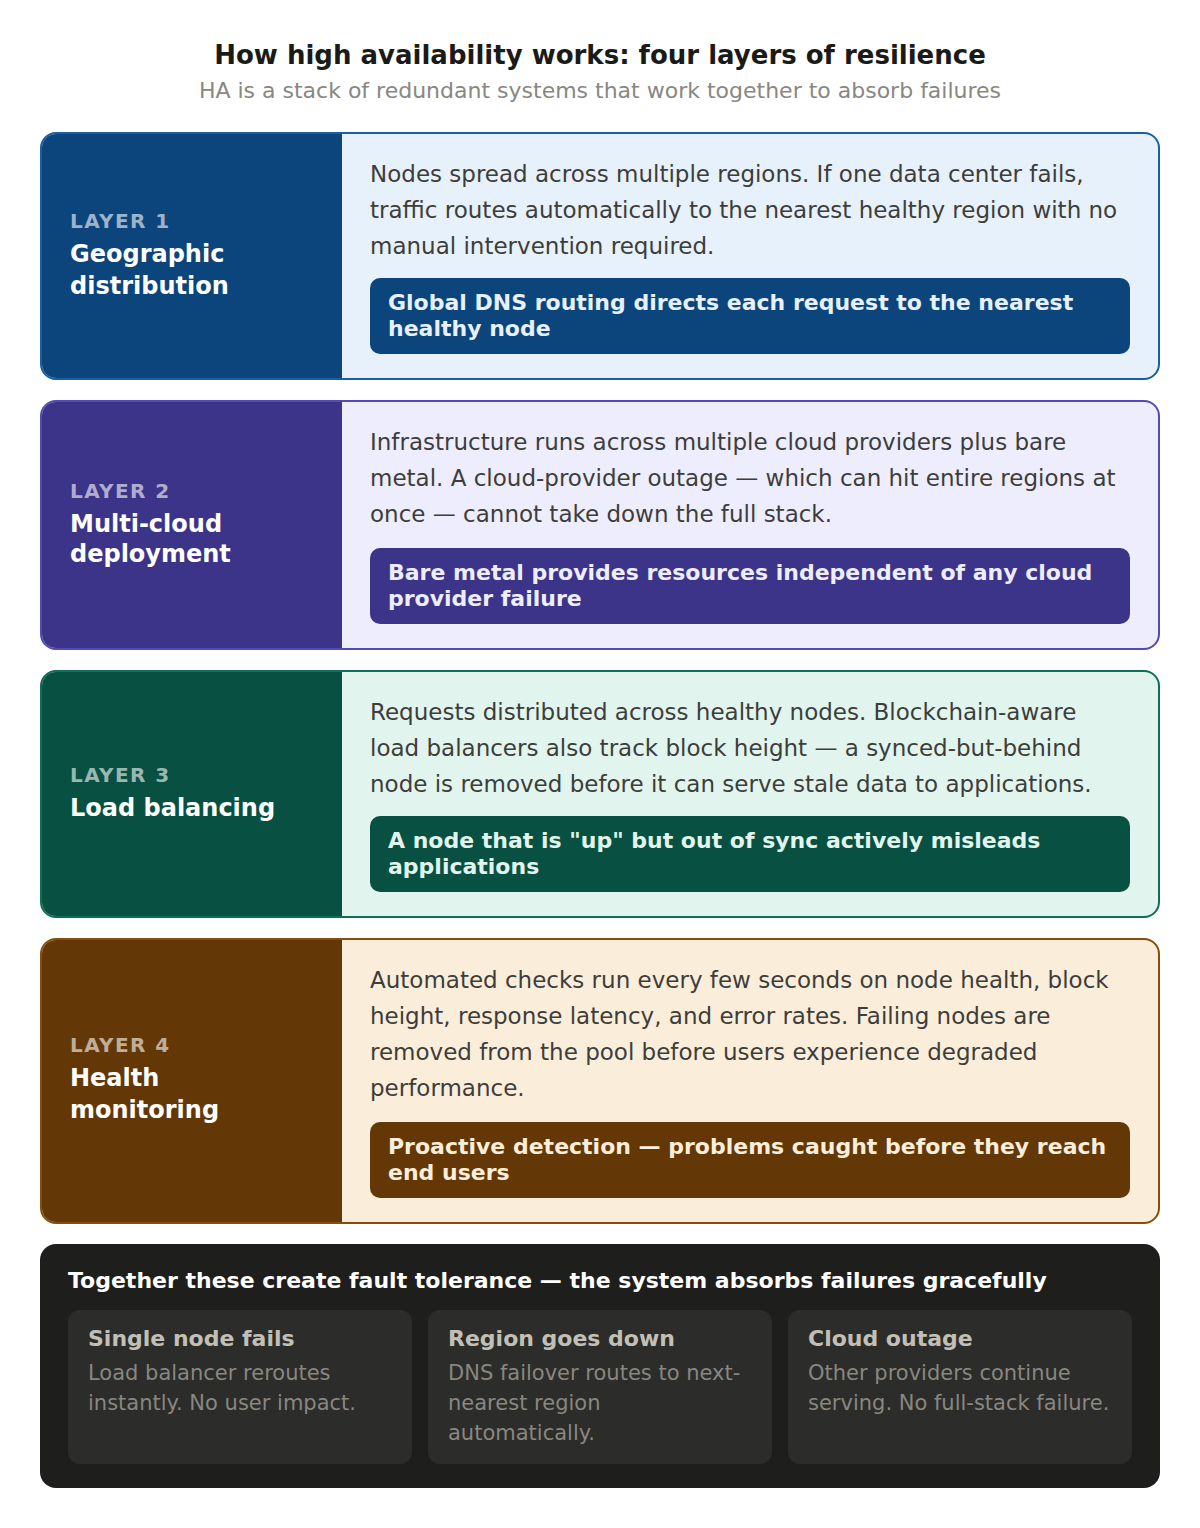
從本質上來說,高可用性(HA)的核心在於消除單點故障。高可用性系統不會僅依賴單一伺服器、單一資料中心或單一雲端服務供應商,而是將工作負載分散至多個具冗餘功能的元件上。
在區塊鏈基礎架構中,這通常涉及幾個層面。第一層是地理分布,即將節點分散佈於多個區域,如此一來,若某個資料中心發生問題,流量便會自動導向最近的正常運作替代節點。第二層是多雲端部署。 透過在多個雲端服務供應商(有時也包含裸機)上運行,可確保特定雲端服務的故障不會導致整個技術堆疊癱瘓。第三層是負載平衡,其將傳入的 RPC 請求分配至一組正常運作的節點池中,並自動繞過任何速度緩慢或無回應的節點。第四層是健康狀態監控,自動系統會持續檢查節點健康狀態、區塊高度及回應時間,在問題影響使用者之前即予以標記。
這些組件協同運作,共同實現了工程師所稱的「容錯能力」。該系統能夠平穩地吸收故障,而非直接崩潰。
可用性的衡量
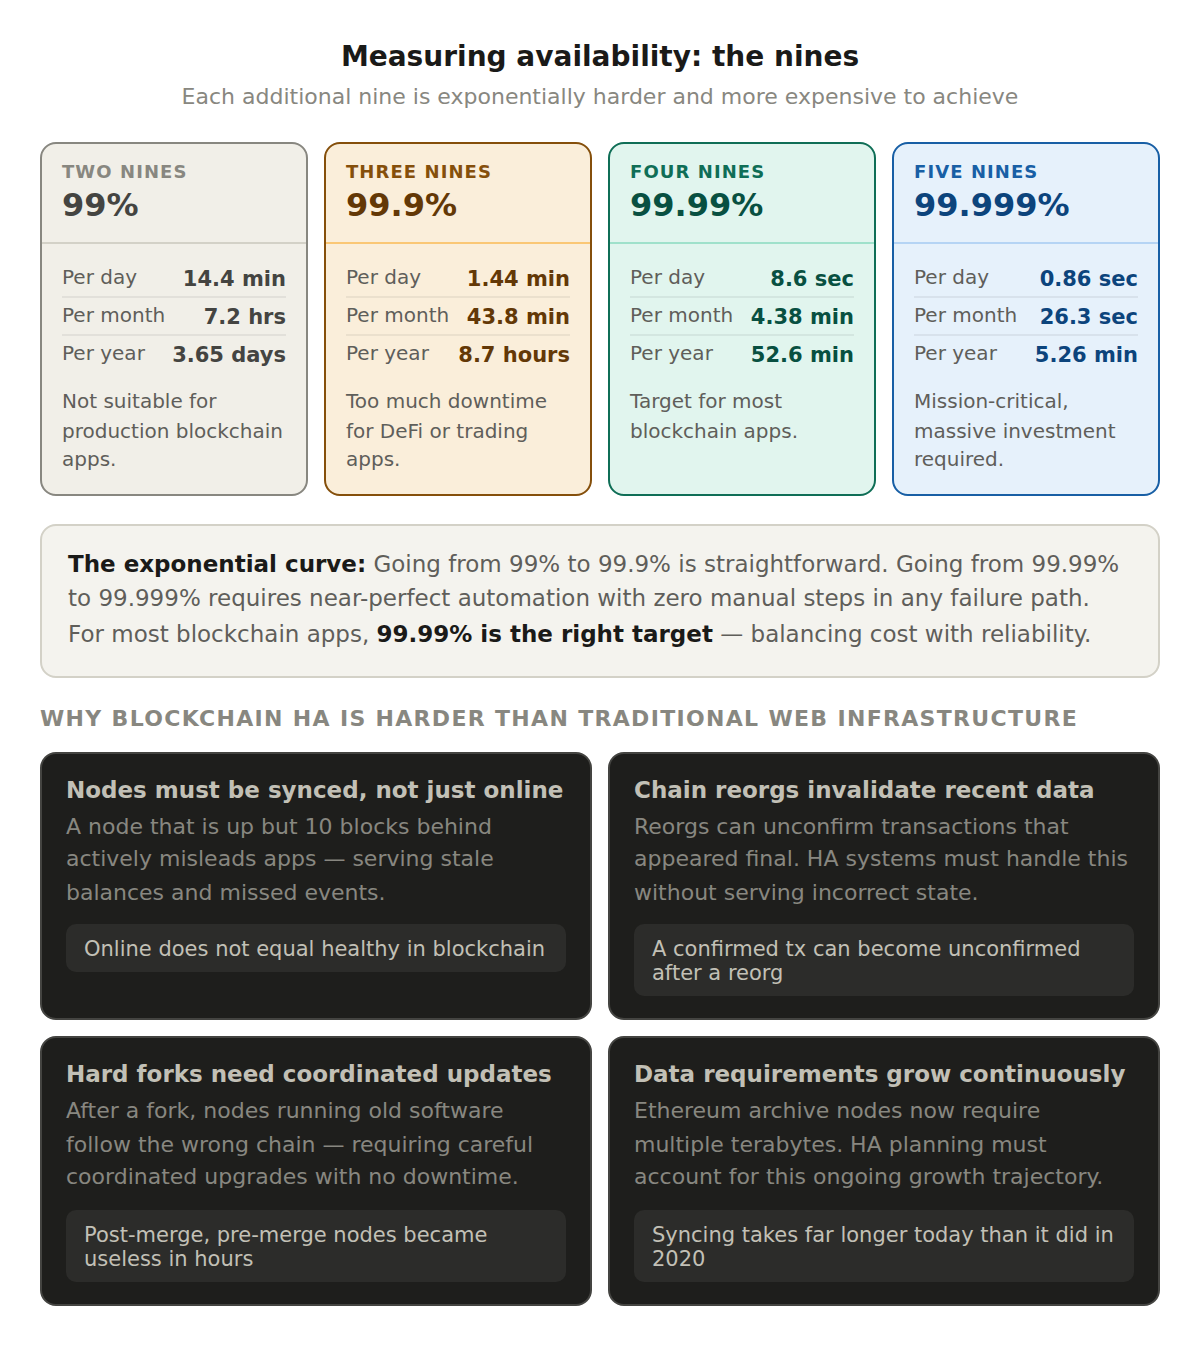
可用性通常以特定期間內的正常運作時間佔總時間的百分比來表示。您經常會聽到「三個九」(99.9%)或「四個九」(99.99%)這類說法。
以下是這些數字在實際應用中的具體意義。若可用性為 99.9%,每年約有 8.7 小時的停機時間;若為 99.99%,則降至每年約 52 分鐘;若為 99.999%(五個九),則全年停機時間僅略超過 5 分鐘。
每增加一個「9」,要達到該水準的難度便呈指數級增長,且需要在冗餘、監控和自動化方面投入更多資源。對於大多數區塊鏈應用而言,99.99% 是能在成本與可靠性之間取得平衡的目標。
您應以多少百分比的正常運作時間為目標?
正常運作時間的目標以「九」為單位來描述。每增加一個「九」,允許的停機時間就會大幅減少,而要達到這個目標所需的成本也會隨之增加。下表顯示了在實際操作中,各級別在全年範圍內的具體意義。
正常運作時間 | 姓名 | 每年停機時間 |
|---|
99.9% | 三個九 | 約 8.7 小時 |
99.99% | 四個九 | 約 52 分鐘 |
99.999% | 五個九 | 剛超過 5 分鐘 |
高可用性與容錯性有何不同?
人們常將這些術語互換使用,但它們並非同一概念。高可用性旨在將停機時間降至最低,並接受在故障轉移期間出現短暫的中斷;而容錯性則透過並行運行完全冗餘的組件,以實現零停機時間。大多數區塊鏈團隊都追求高可用性,因為它能在合理的成本下提供強大的運行時間。
面向 | 高可用性 | 容錯性 |
|---|
目標 | 停機時間極短 | 零停機時間 |
方法 | 冗餘加上快速故障轉移 | 並行冗餘元件 |
成本 | 中等 | 高 |
典型目標 | 99.9% 至 99.99% 的正常運作時間 | 連續運作 |
為什麼區塊鏈如此困難
傳統的網路服務只需在負載平衡器後方啟動更多伺服器即可。區塊鏈基礎架構則較為複雜,因為節點必須與網路保持同步。若節點在區塊高度上落後,即使在技術上仍屬「線上」狀態,實質上也毫無用處。
區塊鏈還帶來了傳統基礎架構中不存在的獨特故障模式。鏈重組可能會使近期資料暫時失效。網路升級或硬分叉需要協調各節點進行更新。不同的客戶端實作在負載下可能表現出不同的行為。此外,資料本身正在不斷增長,這意味著儲存和同步的需求會隨著時間推移而增加。
正因如此,區塊鏈的高可用性(HA)比單純在伺服器叢集前方部署負載平衡器來得更為複雜。這需要對協定有深入的了解,並持續投入營運資源。
該如何設計一個高可用性的 RPC 架構?
一套具韌性的架構結合了多種技術:將節點分散部署於不同區域與服務供應商之間;在健康節點池前方配置負載平衡器;監控區塊高度與延遲,以便自動移除未同步的節點;並準備好備用服務供應商以供故障轉移。從應用程式端來看,這仍是一個單一的RPCendpoint ,但在其背後,卻有確保系統持續在線的冗餘機制。對區塊鏈基礎架構進行持續監控,正是實現自動路由決策的關鍵。
Quicknode 如何實現高可用性
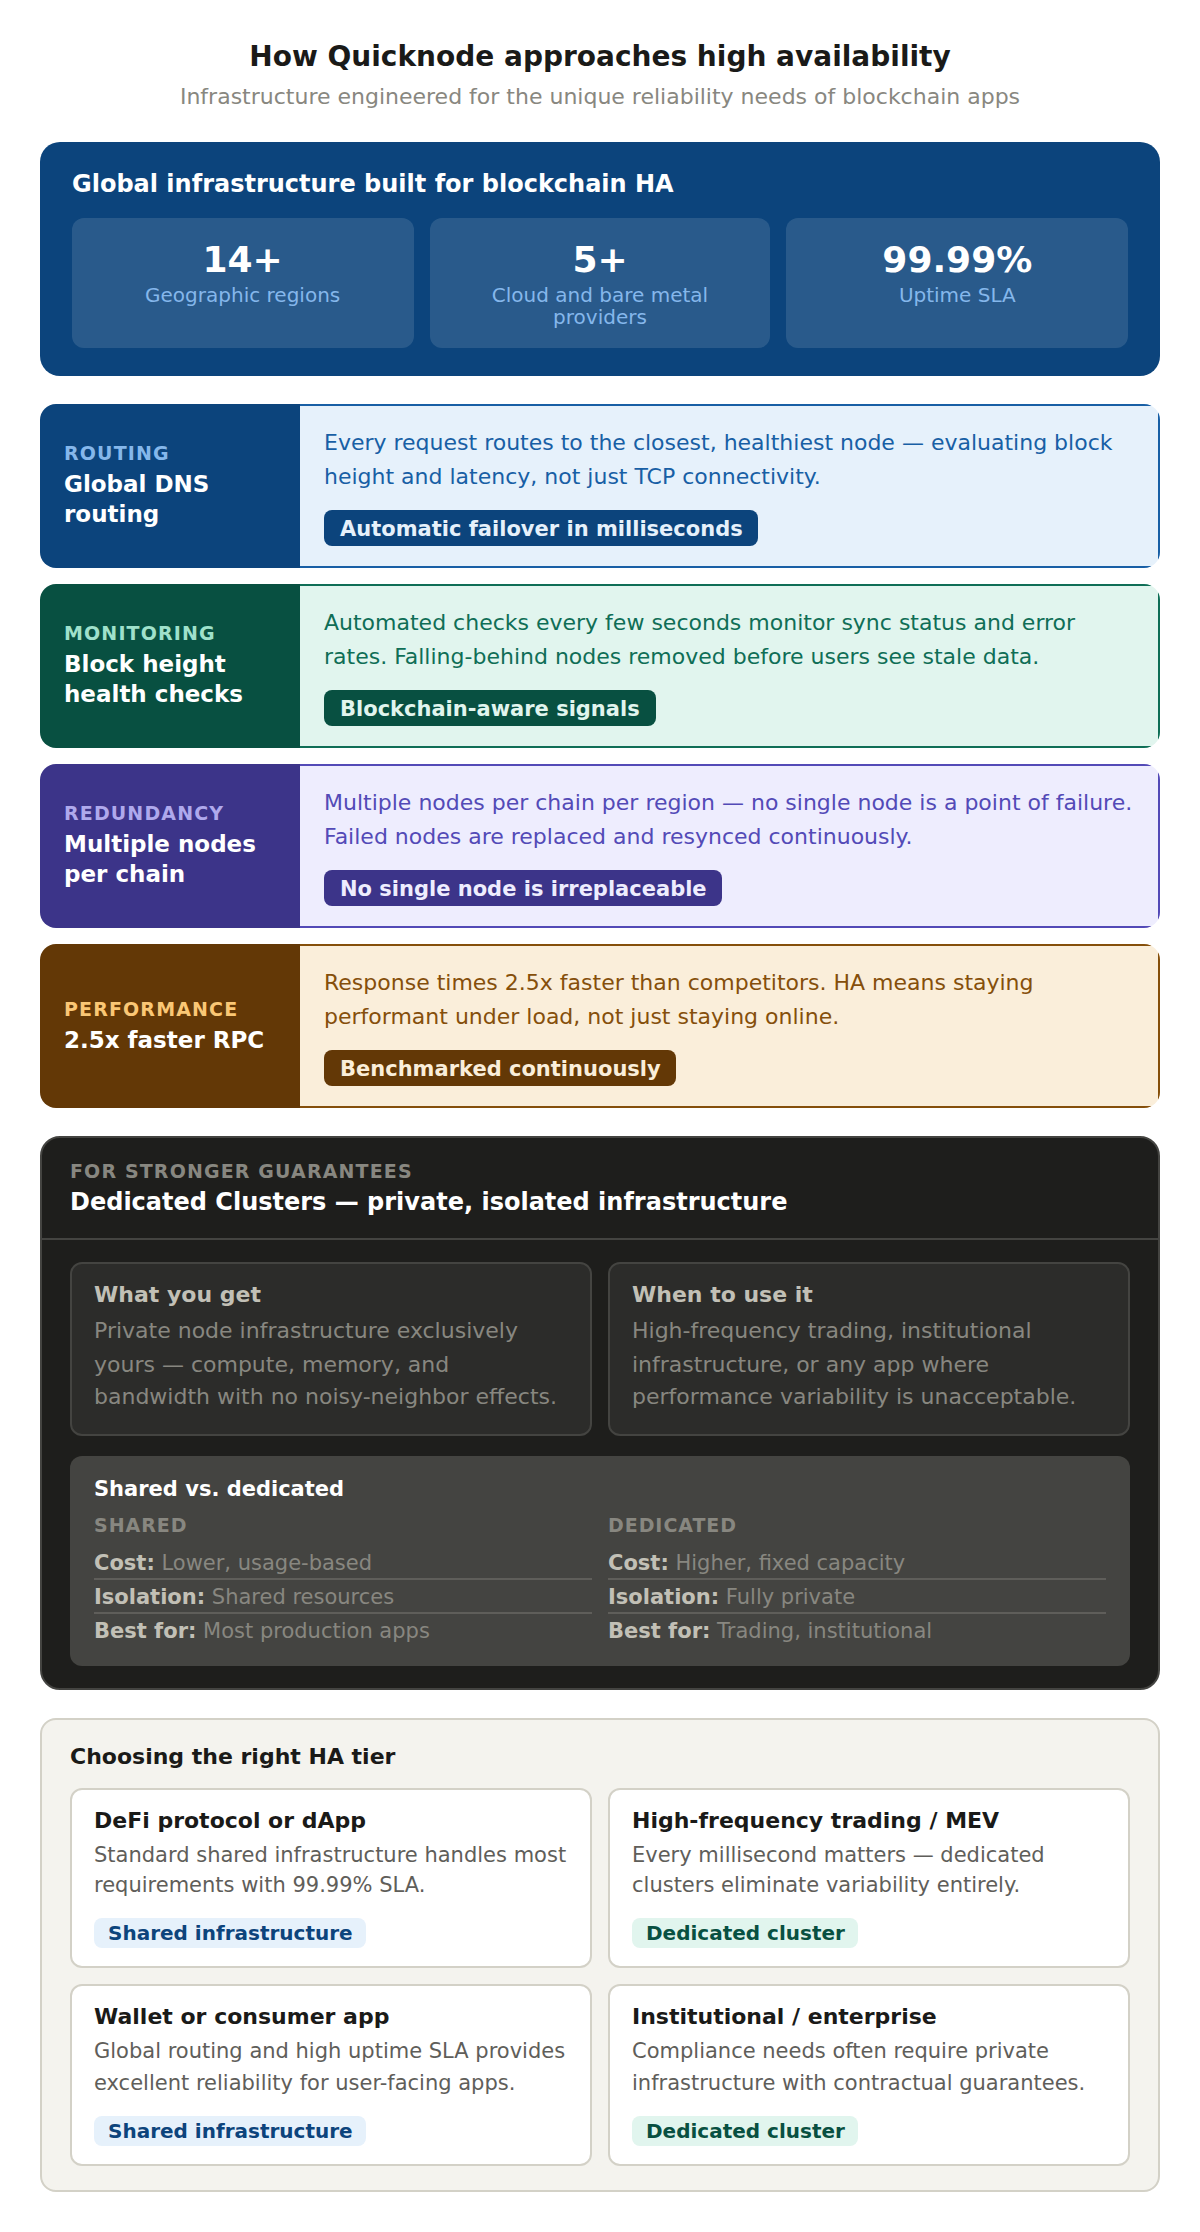
Quicknode 在多個雲端服務商及裸機服務供應商的 14 個以上區域中運作基礎架構。每個 RPC 請求都會透過基於全球 DNS 的路由機制,被導向至最近的正常運作節點;系統會持續監控區塊高度、延遲及錯誤率,以確保請求始終能送達既在線且已完全同步的節點。
對於需要更強保障的團隊,Quicknode 提供專用的clusters ,具備私有且隔離的基礎架構,並附帶保證正常運作時間的服務水準協議 (SLA)。
延伸閱讀
常見問題
對於 RPCendpoint 而言,「高可用性」代表什麼?
這表示,即使個別節點、區域或供應商發生故障,endpoint 仍會持續回應請求。流量會自動導向至運作正常且已同步的節點,因此您的應用程式將維持一致的正常運作時間,而非出現錯誤。
對於區塊鏈基礎設施而言,什麼樣的正常運作時間才算理想?
大多數生產應用程式以 99.99% 的正常運作時間為目標,這意味著每年允許約 52 分鐘的停機時間。雖然達到 99.999% 是可行的,但所需的冗餘與自動化措施將大幅增加成本。
為什麼對區塊鏈而言,實現高可用性比對網路應用程式更困難?
節點必須與網路保持同步,因此即使某個節點處於線上狀態,但區塊高度落後時,仍無法使用。區塊鏈特有的事件也會使情況更加複雜,我們將在「常見的區塊鏈故障模式」中探討這一點。
區塊鏈重組會如何影響可用性?
重組可能會暫時使近期資料失效,因此高可用性系統會等待確認,或明確處理重組情況。詳情請參閱「什麼是區塊鏈重組」。
高可用性是否意味著不再需要備份服務供應商?
不。單一服務供應商的高可用性雖能降低風險,但維持獨立的備份供應商可讓您免受全供應商範圍事故的影響,這也是韌性設計中常見的一環。