🤖 最新推出:《Quicknode 人工智慧實戰手冊》 10 個經過實測的 AI 程式設計食譜agents 。
查看食譜 解析節點可靠性:為何對區塊鏈至關重要 |Quicknode
我們的電子報內容豐富,包含免費資源、Quicknode 最新動態、Web3 洞見等。
CLI、Admin API 、MCP、SDK ,以及適用於 75 條以上區塊鏈的 AI 原生工具。由開發者打造,為開發者而生。
涵蓋 Python、Ruby 及 JavaScript 的最新程式碼範例。關於智慧合約、NFT 及去中心化應用程式(dApps)的深入指南。
已通過 SOC 2 Type II 認證 · ISO 27001
簡而言之:節點 可靠性是用來衡量區塊鏈節點在無停機、無錯誤或無過時資料的情況下, 能多麼一致且精確地回應請求。 對於任何從區塊鏈讀取或寫入資料的應用程式而言,不可靠的節點基礎架構將導致交易失敗、餘額錯誤、事件遺漏,以及使用者體驗受損。在生產環境中,節點可靠性絕非可有可無的附加功能,而是所有其他運作所依賴的基礎。
簡單的解釋 您的應用程式與區塊鏈之間的每次互動,都會經過一個節點。當使用者查詢錢包餘額時,由節點回應該查詢;當有人在去中心化交易所提交兌換交易時,由節點廣播該筆交易;當您的後端監聽智慧合約事件時,由節點傳遞這些事件。若節點運作緩慢、離線,或傳回過時資料,您的應用程式便會發生故障,進而直接影響您的使用者及營收。
請將節點的可靠性,視同傳統網路應用程式中資料庫的正常運作時間來理解。若資料庫離線,您的應用程式便無法讀取或寫入資料。 使用者會看到錯誤訊息、交易失敗,而信任度也隨之削弱。區塊鏈節點的功能與您的資料庫層相同,只是它們所處理的資料屬於金融性質。若餘額資訊未及時更新,可能會導致使用者帳戶透支;若交易中斷,可能意味著錯失交易機會;若事件處理延遲,則可能在 DeFi 協議中觸發錯誤的清算。這其中的風險更高,而對失敗的容忍度也更低。
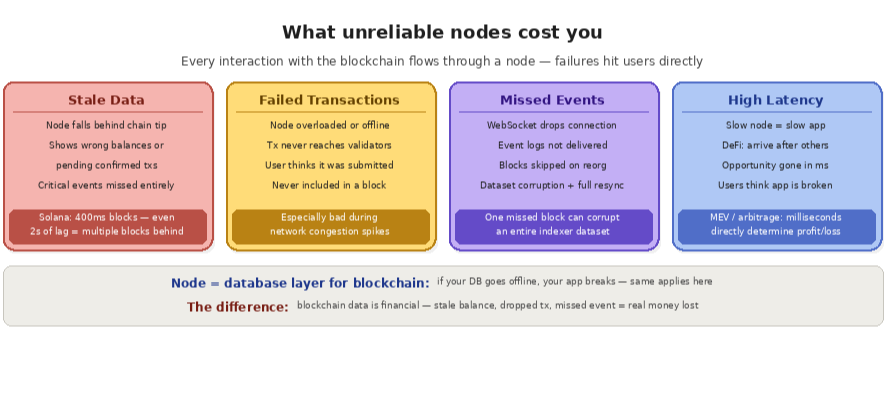
節點可靠性不足所造成的後果會以多種形式顯現,其中大部分在生產環境發生問題之前,並不會立即顯而易見。
過時資料是最危險的故障模式之一。如果您的節點落後於區塊鏈的末端(即最近確認的區塊),它就會開始提供過時的狀態。您的應用程式可能會向使用者顯示已不存在的餘額、將已經確認的交易標示為待處理,或是完全錯過關鍵的智慧合約事件。 在像Solana 這樣每 400 毫秒就會產生一個區塊的高速鏈上,即使只有幾秒鐘的同步延遲,也可能導致您的應用程式落後現實多個區塊。
交易失敗是另一項主要成本。 當您透過節點提交交易時,該節點需要將其廣播至網路的記憶池(或其等效結構)。若節點過載、與對等節點斷開連線,或配置不當,該交易可能永遠無法傳遞至驗證者。使用者以為自己的交易已提交,但它卻從未被納入區塊中。在高吞吐量鏈上,或網路擁塞期間,這種情況在效能不足或維護不善的節點上經常發生。
遺漏的事件會影響任何依賴即時區塊鏈資料的應用程式。若您的節點在重新組織過程中中斷 WebSocket 連線、未能傳送事件日誌,或跳過區塊,您的應用程式將會遺失資料。對於索引器、分析平台,以及任何需要完整鏈上活動紀錄的系統而言,即使僅遺漏單一區塊,都可能導致資料集損毀,並需要進行完整重新同步。
延遲會直接影響競技型應用場景。在 DeFi 交易、MEV 提取及套利等情境中,每毫秒都至關重要。節點運作緩慢意味著您的交易會比他人的交易晚抵達,導致機會錯失。對於時效性較不關鍵的應用程式,高延遲仍會降低使用者體驗。使用者期望錢包餘額能即時更新,交易也能迅速確認。即使區塊鏈本身的運作狀況良好,節點反應遲緩仍會讓您的應用程式給人一種「無法正常運作」的感覺。
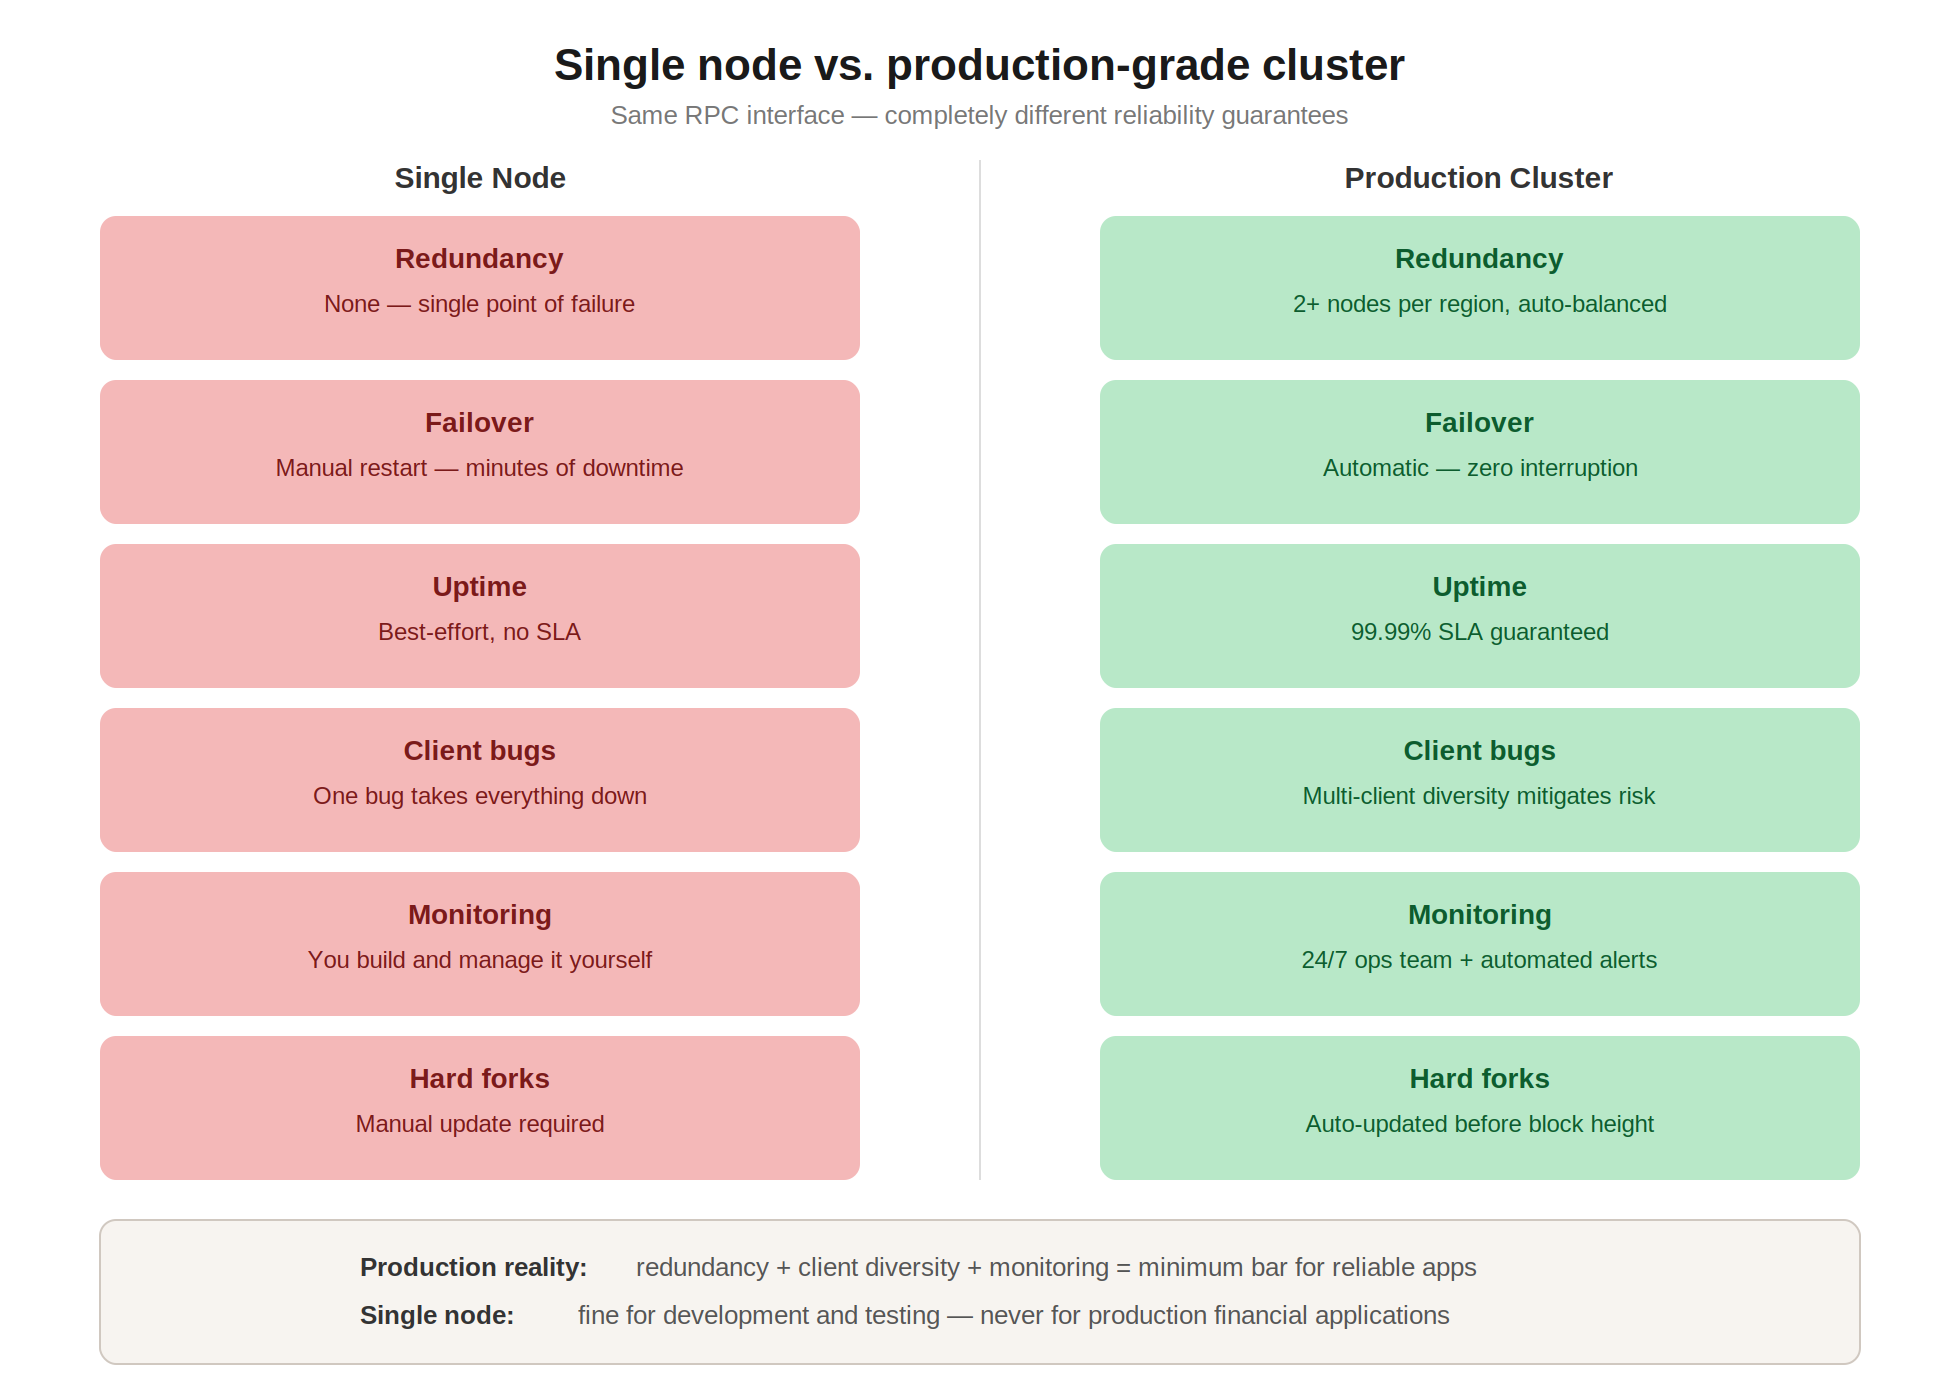
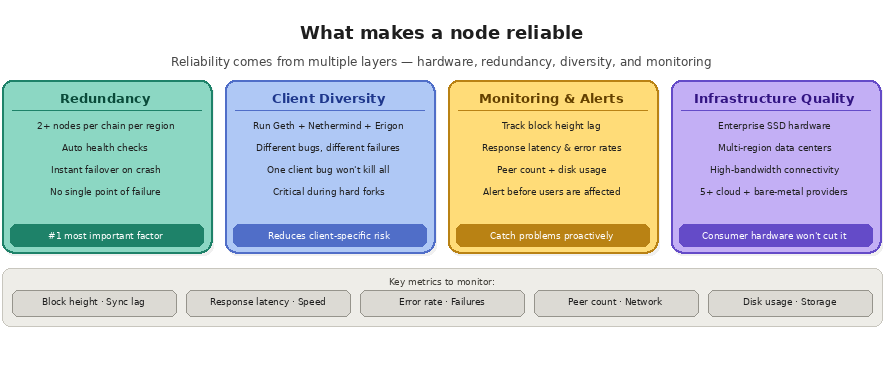
什麼使一個節點可靠 可靠性源自多個層面:硬體品質、軟體配置、網路連線、冗餘設計以及運作監控。單一節點若僅運行於消費級硬體上,並透過家用網路連線,其可靠性永遠無法與分散於多個資料中心及雲端服務供應商、且由專業團隊管理的節點叢集相提並論。
冗餘是最重要的因素。若單一節點發生故障(無論是因系統當機、磁碟故障或客戶端程式錯誤所致),冗餘系統將自動切換至正常運作的節點,且不會對您的應用程式造成任何中斷。若缺乏冗餘機制,單一故障點便可能導致整個應用程式離線。生產級基礎架構通常會在同一個區域內運行兩個或更多屬於同一鏈的節點,並具備自動狀態檢查與流量路由功能。
客戶端的多樣性同樣至關重要。不同的區塊鏈客戶端實作(例如Ethereum 上的 Geth、Nethermind 與 Erigon)具有不同的效能特性、不同的錯誤,以及不同的故障模式。運行多種客戶端實作,可降低因單一客戶端的錯誤而導致整個基礎架構癱瘓的風險。這在硬分叉和協定升級期間尤為重要,因為此時最容易浮現與特定客戶端相關的問題。
監控與警示機制對於在問題影響使用者之前及早發現至關重要。運作良好的節點基礎架構會持續追蹤各項指標,例如區塊高度(用以偵測同步延遲)、回應延遲、錯誤率、對等節點數量以及磁碟使用率。當任何指標超過閾值時,系統會自動觸發警示,以便在問題波及生產環境之前展開調查或進行故障轉移。
節點的可靠性是如何測量的? 可靠性並非單一數值,而是一組指標,這些指標綜合起來可說明某個節點在生產環境中是否值得信賴。下表列出了最重要的指標、各指標所傳達的訊息,以及生產級配置應維持的範圍。
公制
這告訴你什麼
生產目標
正常運作時間服務水準協議 (SLA)
endpoint 的可用時間比例
99.9% 或更高
錯誤率
返回錯誤的請求佔比
低於 0.1%
同步延遲
鏈條尖端後方的距離
0 至 1 個街區內
回應延遲(p99)
回應速度最慢的 1%
少於 500 毫秒
對等節點數量
穩定的網路連線
高於客戶最低門檻,維持穩定
正常運行時間雖是關鍵指標,但若某個節點雖處於「線上」狀態,卻因落後於區塊鏈尖端(tip)或持續回傳錯誤而仍不可靠,則仍屬不可靠。應持續追蹤這些訊號,而非僅進行抽樣檢查。若要全面了解如何對endpoint 進行監測,請參閱「監控區塊鏈基礎設施 」。
是什麼原因導致區塊鏈節點發生故障? 節點的故障可能源於內部或外部因素。 就內部因素而言,磁碟空間已滿、記憶體洩漏或客戶端軟體的錯誤,都可能導致節點當機或停滯。就外部因素而言,網路分割、對等節點遺失,以及網路擁塞 期間的流量激增,都可能使資源配置不足的節點不堪負荷。協定升級與硬分叉是特別高風險的時刻,因為某個客戶端特有的錯誤,可能會導致所有運行該客戶端的節點全部當機。了解常見的區塊鏈故障模式, 有助於您設計出能平穩降級而非直接停機的基礎架構。
故障轉移如何提升節點的可靠性? 故障轉移是一種將多個獨立節點整合為單一可靠服務的機制。狀態檢查會持續監控每個節點,當其中一個節點狀態惡化或離線時,流量會自動重新導向至狀態正常的節點,因此您的應用程式完全不會察覺到服務中斷。這是高可用性的 核心,且仰賴基礎架構的冗餘設計 :運行多個節點,以確保隨時都有備援節點待命。請參閱「什麼是故障轉移」 一文,了解無縫切換在實際運作中的運作方式。
您應該自行架設節點,還是使用服務供應商? 自行運作節點雖能讓您擁有完全的控制權,但會將所有可靠性負擔都轉嫁給您的equipe :包括硬體、冗餘機制、監控、升級,以及全天候(24/7)的值班支援。 託管服務供應商會承接這些營運負擔,並從您提出的第一個請求開始,即為您提供分散式且具備冗餘的節點群組。正確的選擇取決於您的規模、預算以及對營運風險的容忍度,且可能因工作負載而異——畢竟,自行架設存檔節點的 負擔遠比架設完整節點更為沉重。請參閱「自建 vs 購買 」一文,以獲取決策的評估框架。
Quicknode 如何確保可靠性 Quicknode該平台的基础架構專為大規模生產環境的可靠性而打造。該平台每日處理橫跨 80 多個區塊鏈網路的數十億次 API 請求,並提供 99.99% 的正常運行時間服務水準協議 (SLA)。此可靠性源自於橫跨 14 個以上區域及 5 家以上雲端與裸機服務供應商的全球分散式架構、每條鏈的多種客戶端實作、自動故障轉移與負載平衡,以及由專責區塊鏈運維團隊equipe 提供的 24/7 全天候監控。
Quicknode 採用針對特定使用情境優化的節點clusters ,這意味著流量會被路由至針對當前請求類型進行優化的節點。讀取密集型工作負載、檔案查詢以及交易廣播,各自都會被導向針對該特定模式進行調校的基礎架構。此方法能在負載波動的情況下提供穩定的效能,而非在流量激增時導致效能下降。
針對對可靠性要求極高的團隊,Quicknode 的專用Clusters 服務提供完全隔離的私有節點基礎架構。 每個叢集在同一個區域內運行具冗餘的節點,並採用獨立的流量分發路徑,因此其他客戶的共享流量絕不會影響您的效能。專用Clusters 提供保證正常運作時間的服務水準協議(SLA)、支援 Prometheus Exporter 進行自訂監控,以及 14 天的日誌保留期,以確保完整的營運可視性。此等級的基礎架構正是驅動 Web3 領域中部分最大型錢包、交易所及 DeFi 協議的動力來源。
常見問題
在區塊鏈中,什麼是節點可靠性? 節點可靠性是指區塊鏈節點在無停機、無錯誤或無過時資料的情況下,能多麼一致且精確地回應請求。可靠的節點會持續與區塊鏈末端保持同步、迅速回應,並維持可用狀態,以便您的應用程式能不中斷地讀取和寫入區塊鏈資料。
對於區塊鏈節點而言,什麼樣的正常運作時間 SLA 才算理想? 生產環境的應用程式應以 99.9% 或更高的正常運行時間為目標,這意味著每年停機時間不得超過約 9 小時。對於交易所和去中心化金融(DeFi)協議等高要求的工作負載,通常需要達到 99.99% 的服務水準協議(SLA),這意味著每年停機時間不得超過 1 小時。
您是如何監控節點可靠性的? 持續追蹤區塊高度差異、錯誤率、回應延遲及對等節點數量,並在任何一項指標超過閾值時觸發警示。將這些指標與日誌及追蹤資料結合分析,不僅能顯示節點效能正在下降,更能釐清原因,讓您在用戶察覺之前即能進行故障轉移或進行修復。
節點可靠性與節點效能之間有何區別? 效能關乎速度,也就是節點回應的速度快慢。可靠性則關乎一致性,也就是節點是否能正確回應,並在長時間內保持可用。如果節點經常當機,即使速度再快也可能不可靠;若效能不足,即使可靠也可能速度緩慢。生產環境的基礎架構需要這兩者兼備。
使用多個節點是否能提高可靠性? 是的。透過運行具備自動故障轉移功能的冗餘節點,可以消除單點故障,因此即使其中一個節點發生故障,也不會導致您的應用程式離線。這種冗餘機制正是區塊鏈基礎設施實現高可用性的 基礎。
延伸閱讀 // Publisher
Quicknode
更新於 2026 年 6 月 3 日
2026年2月3日 — 閱讀時間 9 分鐘