簡而言之:監控區塊鏈基礎架構,意味著需持續追蹤應用程式所依賴的節點、RPC 端點及資料管道的健康狀態、效能與準確性。與監控傳統網頁伺服器不同,區塊鏈監控必須考量到鏈特有的行為,例如區塊產出率、同步狀態、最終性檢查點、記憶池擁塞以及 gas 價格動態。 需追蹤的核心指標包括區塊高度(您的節點是否與最新狀態同步?)、RPC 延遲(請求是否迅速?)、錯誤率(請求是否成功?)以及資料新鮮度(您的應用程式是否能看到最新狀態?)。有效的監控應結合自動警示機制以即時處理問題,並透過儀表板進行趨勢分析與容量規劃。
簡單的解釋
如果您的應用程式依賴區塊鏈,那麼該應用程式的運作狀況,完全取決於連接該區塊鏈的基礎架構是否健全。即使智慧合約編寫得再完美、前端設計得再精美,一旦負責提供資料的 RPCendpoint 發生故障、處理延遲或開始回傳錯誤,一切都將變得毫無價值。透過監控,您才能在用戶察覺之前,及早發現系統故障。
傳統的網頁應用程式監控主要著重於伺服器的 CPU、記憶體、磁碟和網路。 區塊鏈基礎架構監控不僅涵蓋上述所有項目,還包含一組傳統系統中不存在的、特定於區塊鏈的指標。節點是否已同步至最新區塊?節點是否位於標準鏈上,還是卡在分叉上?RPC 回應所返回的資料是否來自正確的區塊高度?記憶池是否已擁塞到足以影響交易確認時間?正是這些區塊鏈特有的訊號,區分了穩健的監控架構與那些會忽略關鍵故障模式的監控架構。
應監控哪些項目
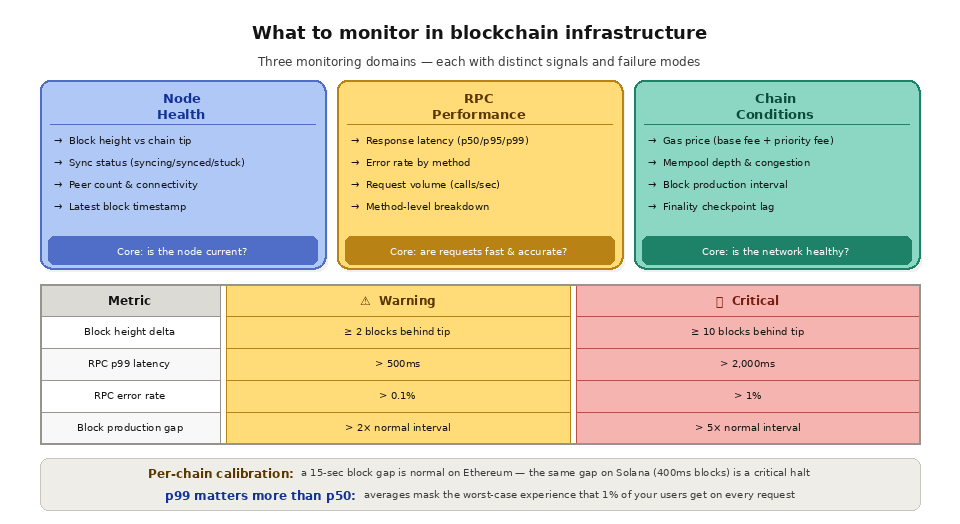
節點狀態
最基本的指標是區塊高度:您的節點處理過的最新區塊是什麼,以及它與區塊鏈的實際末端相比如何?若節點落後於區塊鏈末端(即使僅落後幾個區塊),便會提供過期的資料。您的應用程式可能會顯示過時的餘額、遺漏最近的交易,或無法偵測到已確認的事件。在像Solana 這樣的高速區塊鏈上(區塊生成時間為 400 毫秒),即使是微小的同步延遲,也意味著您的應用程式已落後實際狀況多個區塊。
請監控您的節點區塊高度與鏈尖之間的差距。一個運作正常的節點,其區塊高度應始終與鏈尖相差 0 至 1 個區塊。若差距達到 2 個區塊以上,即為警示訊號;若差距達到 10 個區塊以上,則表示您的節點存在同步問題,需立即進行調查。
同步狀態會顯示您的節點目前是正在同步、已完全同步,還是卡住了。若節點顯示為「正在同步」且進度穩定,則表示該節點運作正常;若節點顯示為「正在同步」,但數分鐘內區塊高度未增加,則表示該節點已卡住,需要處理。
「對等節點數」用來追蹤您的節點與其他節點的連接數量。一個運作正常的節點會與多個對等節點保持連線,以便進行資料傳播及參與共識機制。若對等節點數持續減少,可能表示網路連線出現問題或配置有誤。
RPC 效能
回應延遲是指從傳送 RPC 請求到收到回應之間所花費的時間。 應以百分位數(p50、p95、p99)而非平均值來追蹤此指標,因為平均值會掩蓋使用者實際遭遇的最差情況。若 p50 延遲為 50 毫秒,而 p99 為 2,000 毫秒,這表示多數請求處理迅速,但每 100 次請求中就有 1 次需耗時整整 2 秒。正是這些緩慢的請求,才會讓使用者感到沮喪。
錯誤率是指返回錯誤(非 200 的 HTTP 狀態碼、JSON-RPC 錯誤回應或超時)的 RPC 請求所佔的百分比。 運作正常的endpoint 其錯誤率應低於 0.1%。若錯誤率高於 1%,則表示存在問題,需立即進行調查。常見的錯誤類型包括 429(速率限制)、502/503(節點不可用),以及 JSON-RPC 錯誤,例如「missing trie node」(存檔資料不可用)或「nonce too low」(交易提交衝突)。
方法層級的細分會依據 RPC 方法(例如 eth_call、eth_getBalance、eth_sendRawTransaction 等)來區分指標,因為不同方法具有不同的效能特徵與故障模式。若 eth_getLogs 的延遲突然飆升,可能表示節點在處理日誌過濾時遇到困難;而若 eth_sendRawTransaction 的錯誤率突然飆升,則可能表示記憶池(mempool)發生擁塞。
鏈條件
對於任何會提交交易的應用程式而言,追蹤 Gas 費率至關重要。監控基礎手續費與優先級手續費的走勢,有助於您的應用程式估算適當的 Gas 費率,避免在網路流量平穩時支付過多費用,並在網路擁塞導致交易成本上升時向使用者發出警示。
記憶池深度表示有多少筆待處理交易正在等待被納入區塊。記憶池深度的增加預示著網路擁塞加劇,這意味著手續費會上升,確認時間也會變長。需要可預測交易確認結果的應用程式,應監控記憶池深度,並據此調整其運作行為。
區塊產出率因鏈而異,且在發生網路問題時可能會波動。監控區塊產出間隔有助於在鏈的運作速度減緩或中斷影響您的應用程式功能之前及早發現。
設定監控
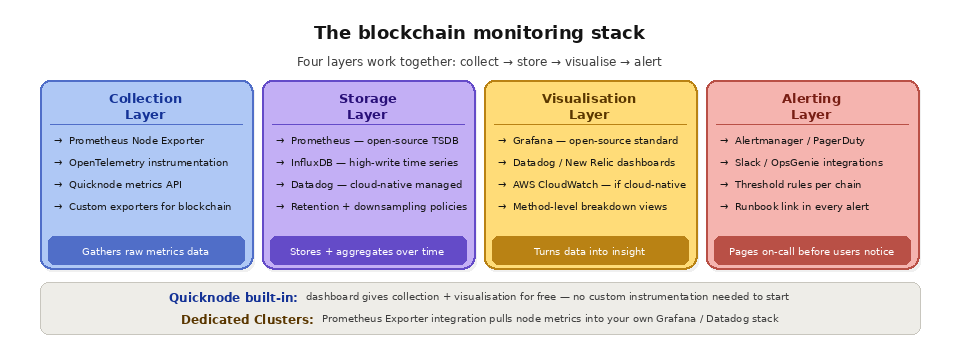
標準的區塊鏈基礎設施監控架構由收集層、儲存層、視覺化層及警示層組成。
收集層負責從您的基礎架構中蒐集指標。對於自架設的節點,Prometheus Node Exporter 及自訂指標匯出工具等工具會蒐集系統指標與區塊鏈專屬指標。至於託管式端點,多數服務供應商皆提供基於 API 或 webhook 的指標存取方式。應用程式層級的指標則可透過 OpenTelemetry、StatsD 或各服務供應商專屬的 SDK 進行蒐集。
儲存層是一種針對指標資料進行優化的時間序列資料庫。Prometheus、InfluxDB 和 Datadog 是最常見的選擇。時間序列資料庫專為指標資料的高寫入量與時間順序特性而設計,並內建對彙總、降採樣及保留政策的支援。
可視化層將原始指標轉化為可供採取行動的儀表板。Grafana 是開源監控可視化的業界標準,原生支援 Prometheus、InfluxDB 以及其他數十種資料來源。Datadog、New Relic 和 AWS CloudWatch 則將整合式可視化功能納入其監控平台之中。
警示層會根據閾值評估指標,並在需要關注時通知相關人員。 有效的警示應具備以下特質:可採取行動(每則警示都應有對應的應變手冊)、經過微調(靈敏度不宜過高以致頻繁觸發,也不宜過低以致漏報實際問題)、能正確路由(透過 PagerDuty、Slack 或類似工具發送給當值人員),以及具情境相關性(包含足夠的資訊,讓人員無需開啟儀表板即可開始診斷問題)。
區塊鏈特有的監控挑戰
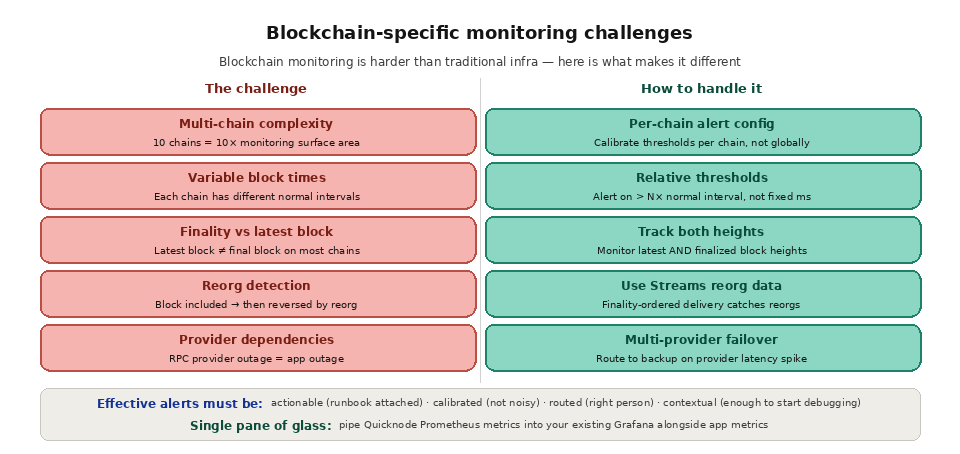
多鏈環境會使監控複雜度倍增。若您的應用程式支援 10 條鏈,您就需要針對每條鏈追蹤節點狀態、RPC 效能以及鏈的運作狀況。每條鏈都有不同的區塊生成時間、不同的最終性模型,以及不同的故障模式。一套在Ethereum 上運作完美的監控設定,可能會在Solana 上漏掉關鍵訊號,反之亦然。
區塊生成時間的不穩定性,使得設定靜態警示閾值變得更加困難。Ethereum 區塊之間出現 15 秒的間隔是正常的;但在Solana (該鏈的區塊應每 400 毫秒生成一次)上出現 15 秒的間隔,則是一個嚴重的問題。警示設定應針對每條區塊鏈分別校準,而非統一設定。
對最終性的認知對於監控資料管道至關重要。監控不僅應追蹤節點所見到的最新區塊,還應追蹤最新的已最終化區塊。尚未達到最終性的區塊中的資料可能會因重新組織(reorg)而被覆寫,因此,依賴已最終化資料的應用程式,其監控機制必須能夠區分「最新區塊高度」與「已最終化區塊高度」。
哪些是必須追蹤的最重要的區塊鏈監測指標?
只需關注幾個高信號指標,便能偵測到絕大多數的區塊鏈基礎架構問題。下表摘要說明了每個指標所反映的資訊、代表系統運作正常的數值範圍,以及您應聯絡值班工程師的臨界點。
公制 | 測量項目 | 健康範圍 | 何時應發出警報 |
|---|---|---|---|
區塊高度差 | 距鏈條末端的距離 | 0 至 1 個街區內 | 落後 10 個街區或以上 |
RPC 延遲 (p99) | 回應速度最慢的 1% | 少於 500 毫秒 | 超過 2 秒 |
請將這些指標視為時間序列而非單次讀數來追蹤,如此一來便能在問題演變為服務中斷之前,及早察覺趨勢。特別是延遲,應以百分位數來衡量:進一步了解影響RPC 延遲的因素,以及它如何融入更廣泛的區塊鏈可觀測性框架中。
區塊鏈監控與傳統基礎設施監控有何不同?
標準的伺服器監控僅能告知您機器是否處於運行狀態,但區塊鏈節點即使通過所有基礎架構檢查,仍可能在背後默默傳輸過時或經重新組織的資料。區塊鏈監控是在一般主機指標之上,疊加了具備區塊鏈意識的訊號。
面向 | 傳統的基礎設施監控 | 區塊鏈基礎設施監控 |
|---|---|---|
主要健康指標 | CPU、記憶體、磁碟、網路 | 區塊高度、同步狀態、最終性 |
常見故障mode | 伺服器當機或負載過高 | 節點處於線上狀態,但提供過時或經重新組織的資料 |
正確性風險 | 一旦伺服器回應,值即降至低點 | 有效的資料可能會因重新組織而發生逆轉 |
最大的差異在於隨時間推移的正確性。某個回應在返回時可能正確,但幾秒後便可能失效,因此監控機制應區分「最新區塊」與「已最終確認的區塊」。關於此區分為何對資料管線至關重要,請參閱「區塊鏈最終性」。
不運行自己的節點,能否監控區塊鏈基礎設施?
是的。託管式 RPC 服務供應商會提供請求量、延遲及錯誤率的儀表板與指標,且無需您進行任何儀器化設定,這消除了自行架設監控系統所帶來的多數營運負擔。這通常是實現高可用性的最快捷徑,因為服務供應商會為您處理節點狀態、擴展及冗餘事宜。Quicknode 的Core API預設即提供基於endpoint 的分析功能,因此您從第一個請求開始就能掌握基礎架構的運作狀況。
該如何監控多鏈區塊鏈基礎設施?
多鏈監控意味著需針對每條鏈分別校準閾值,因為在「Ethereum 」上屬正常範圍的延遲,在「sub-second」鏈上卻可能構成嚴重事件。將每條鏈的指標集中匯總至單一儀表板,並依據各鏈的基準值觸發警示。針對資料管道, Quicknode Streams 會針對每條鏈分別回報傳送成功率與處理延遲,讓您能在某個網路出現延遲時立即知悉。
常見問題
您應該多久監控一次區塊鏈基礎設施?
持續進行。每隔幾秒鐘收集區塊高度和延遲資料,並在near 上即時評估警示規則。高速鏈每秒會產生多個區塊,因此若採用一分鐘的輪詢間隔,可能會掩蓋掉已經嚴重落後的節點。將短暫的資料收集間隔與「指標、日誌和追蹤」這三大支柱結合,以實現全面覆蓋。
什麼樣的 RPC 錯誤率算是理想?
運作正常的endpoint 錯誤率應低於 0.1%。若錯誤率高於 1%,則表示存在實際問題,例如速率限制、節點不可用或存檔資料遺失。請務必按方法將錯誤細分,以便釐清哪些呼叫失敗以及原因為何。
「最新區塊監控」與「最終區塊監控」之間有何區別?
最新區塊是指您的節點所偵測到的最新區塊,而已確認的區塊則已達到不會被逆轉的階段。依賴已確認資料的應用程式應在達到已確認高度時發出警示,因為未確認區塊中的資料可能會在重組過程中消失。
您是如何監控區塊鏈節點的停機狀況的?
同時追蹤區塊高度差異、對等節點數量及錯誤率,並將警示轉發至值班通報管道。透過將監控與嚴謹的節點可靠性措施及自動故障轉移機制相結合,一旦某個節點狀態惡化,流量便能立即轉向運作正常的節點。
監控區塊鏈基礎設施會使用哪些工具?
常見的開源技術堆疊包含:Prometheus 負責資料收集與儲存、Grafana 負責儀表板,以及 Alertmanager 負責路由。託管服務供應商會提供內建的分析功能,而專用的Clusters 則能將節點層級的指標直接匯出至現有的 Prometheus 或 Datadog 環境中。
Quicknode 如何提供監控功能
Quicknode 針對每個endpoint 皆內建監控與分析功能。Quicknode 儀表板會顯示即時與歷史指標,包括請求量、回應延遲、錯誤率,以及方法層級的細項分析。這些指標無需任何自訂監測程式即可取得,讓開發人員能立即掌握其區塊鏈基礎架構的運作狀況。
對於已建置監控基礎架構的團隊,Quicknode 的專用Clusters 服務支援與 Prometheus Exporter 的整合。這讓您能將節點層級和endpoint 層級的指標直接匯入您的 Prometheus 實例、Grafana 儀表板或 Datadog,從而透過單一平台實現應用程式堆疊與區塊鏈基礎架構的統一監控。專用Clusters 服務還包含 14 天的日誌保留功能,以便進行詳細的請求層級分析。
Quicknode Streams 提供資料管線健康狀態的監控功能,包括傳送成功率、處理延遲及錯誤日誌。對於運行多鏈資料管線的團隊而言,Streams 監控功能可確保您在資料遺漏影響應用程式之前,即能及時掌握管線是否出現延遲或傳送問題。
延伸閱讀
指標、日誌與追蹤的區別 - Quicknode 文件
區塊鏈基礎設施監控-Quicknode 術語表
Quicknode 核心 API
Quicknode 專用Clusters
