🤖 最新推出:《Quicknode 人工智慧實戰手冊》 10 個經過實測的 AI 程式設計食譜agents 。
查看食譜 區塊鏈警示的最佳實務 |Quicknode
我們的電子報內容豐富,包含免費資源、Quicknode 最新動態、Web3 洞見等。
CLI、Admin API 、MCP、SDK ,以及適用於 75 條以上區塊鏈的 AI 原生工具。由開發者打造,為開發者而生。
涵蓋 Python、Ruby 及 JavaScript 的最新程式碼範例。關於智慧合約、NFT 及去中心化應用程式(dApps)的深入指南。
已通過 SOC 2 Type II 認證 · ISO 27001
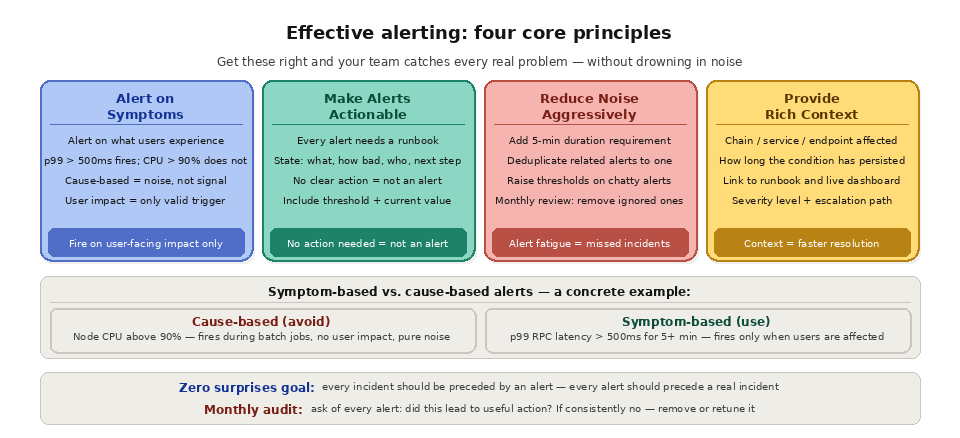
簡而言之: 有效的警示機制應在適當時機,將真實問題通知給正確的人員,並提供足夠的背景資訊,以便立即採取行動。 最重要的原則包括:針對症狀(對使用者造成的影响)而非原因(內部指標)發出警示;確保每則警示皆可採取行動(若無需採取任何行動,就不應觸發警示);積極減少干擾(警示疲勞會導致真正事件被忽略);以及提供背景資訊(問題為何、嚴重程度如何、誰受到影響,以及該如何處理)。 對於區塊鏈應用程式而言,警示機制還必須涵蓋鏈特有的狀況,例如節點同步延遲、Gas 價格飆升、交易確認延遲以及區塊重組等。
簡單的解釋 警報機制是監控數據與人類行動之間的橋樑。監控系統會蒐集數千項指標與數百萬筆日誌記錄。警報機制則負責判斷哪些訊號值得在凌晨 3 點將人喚醒。若能正確設定,您的equipe 便能在使用者察覺之前就發現問題;若設定不當,則會導致真實事件淹沒在龐大的噪音洪流中(警報過多),或是關鍵問題一直未被發現,直到使用者大呼小叫為止(警報過少)。
一套調校得當的警示系統,其目標在於「零意外」:每起生產環境事件發生前都應有警示預先通知,而每則警示都應在實際(或即將發生)的事件之前發出。若警示在沒有相應問題的情況下觸發,會讓您的equipe 習慣性地忽略這些警示;若問題發生時未伴隨事前警示,則表示您的監控系統存在漏洞。
監控與警示之間有何區別? 監控與警示雖有關聯,但兩者有所區別。監控是指持續收集能反映系統運作狀態的指標、日誌和追蹤資料;警示則是建構在監控之上的層級,負責判斷哪些訊號需要人工介入,並將其轉發給適當的人員。您可以進行監控而不觸發警示,但若缺乏良好的監控基礎,就無法有效執行警示。關於這方面的資料層面,請參閱
監控區塊鏈基礎設施
以及更廣泛的實踐,即
.
關注症狀,而非病因 警示機制中最重要的一項原則是:應針對「症狀」(使用者所經歷的情況)而非「原因」(內部發生的狀況)觸發警示。基於症狀的警示會在從使用者角度來看系統出現故障時觸發;而基於原因的警示則是在內部指標超過閾值時觸發,無論使用者是否受到影響。
像「節點 CPU 使用率超過 90%」這類基於原因的警示,可能會在正常的批次處理工作執行期間觸發——儘管該工作會消耗大量 CPU 資源,但並不會影響使用者體驗。此類警示會產生干擾,並削弱對警示系統的信任。 像「p99 RPC 回應時間超過 500 毫秒,且持續超過 5 分鐘」這類基於症狀的警示,僅會在使用者實際遭遇回應遲緩時觸發,無論其成因是 CPU 負載過高、同步問題,還是網路擁塞。
這並不表示您永遠不該監控內部指標。內部指標對於儀表板、趨勢分析以及事件後調查而言都極具價值。但除非這些指標與對使用者造成的實際影響直接相關,否則不應觸發警示頁面。請將警示保留給那些表明實際使用者正面臨或即將面臨系統故障的訊號。
基於症狀的警示與基於原因的警示有何區別? 基於症狀的警示是根據使用者實際遭遇的情況觸發,而基於原因的警示則是根據可能影響或不影響使用者的內部指標觸發。下表對比了這兩者的差異,以便您決定哪些訊號應觸發通知,哪些則應保留在儀表板上。
面向
基於症狀的警示
基於原因的警示
觸發器已開啟
對使用者的影響
內部指標閾值
範例
第 99 頁:RPC 延遲超過 500 毫秒,持續 5 分鐘
節點 CPU 使用率超過 90%
假陽性風險
低
高
最適合用於
讓人豁然開朗的篇章
儀表板與調查背景
讓警示具有可操作性 每則警報都應有明確且有紀錄可循的應對措施。如果警報觸發時,值班工程師的第一反應是「我該怎麼處理這個?」,那麼這則警報就無法付諸行動。
每則警示應包含問題內容(對症狀的清晰描述)、量化背景(被觸發的閾值及當前數值)、影響範圍(受影響的endpoint 、鏈或服務)、持續時間(該狀況已持續多久),以及執行手冊的連結(用於診斷和解決問題的逐步說明)。
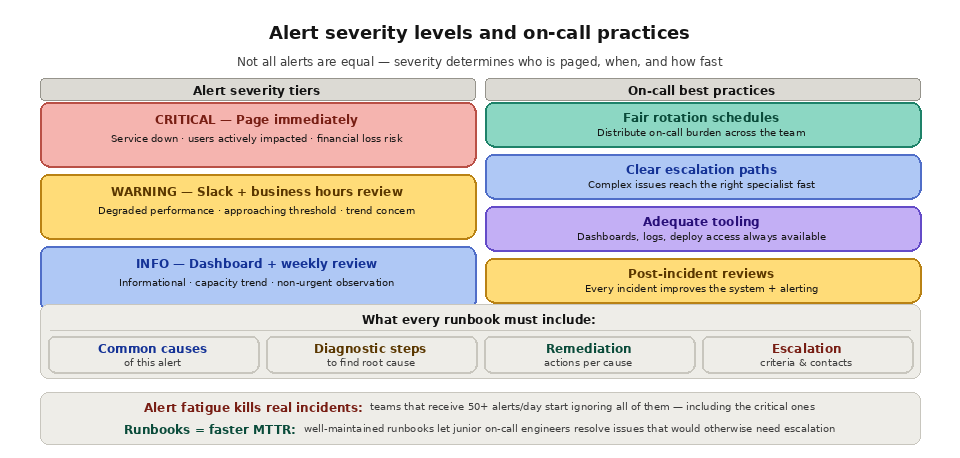
執行手冊是每項警報不可或缺的文件。一份執行手冊應引導應變人員逐步了解警報的常見原因、用於找出根本原因的診斷步驟、針對每種常見原因的修復措施,以及升級處理標準(何時應通知其他人)。維護良好的執行手冊能大幅縮短事件應變時間,並讓經驗較少的equipe 成員也能有效處理值班任務。
減少警報干擾 警報疲勞是有效警報系統面臨的最大威脅。當團隊每天收到數十則警報,其中大部分是誤報或優先級較低的警報時,他們便會開始忽略所有警報,包括關鍵警報在內。
醫療保健領域的研究(其中「警報疲勞」已被公認為一項患者安全問題)顯示,多達 99% 的警報可能是誤報,導致臨床醫師選擇關閉或忽略這些警報。
降低噪音的策略包括:提高頻繁觸發且無需採取行動的警示閾值;新增持續時間要求(僅當狀況持續 5 分鐘以上時才觸發警示,而非因短暫的突增而觸發);刪除相關警示的重複(若同一服務供應商的五個終端點速度皆變慢,則僅發送一則警示,而非五則);實施嚴重性等級 (關鍵警示立即發送通知;警告級警示則發送至 Slack 頻道,供工作時間內審查),以及定期檢視並停用那些持續被忽略或無需採取行動即可解決的警示。
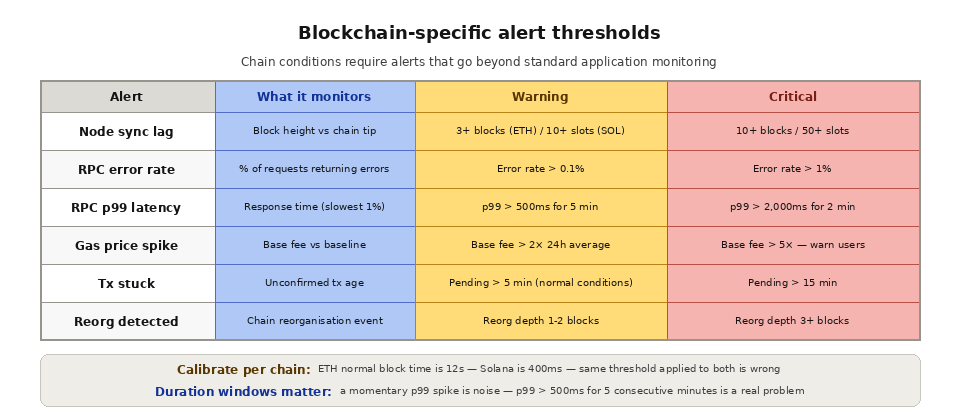
區塊鏈專用警示機制 區塊鏈應用程式除了標準的應用程式和基礎架構警示外,還需要涵蓋鏈層級狀況的警示。
當您的節點(或服務供應商的節點)與區塊鏈末端之間的同步延遲超過可配置的區塊數時,系統應觸發警示。對於Ethereum ,當落後 3 個以上區塊時觸發警示;對於Solana ,當落後 10 個以上時槽時觸發警示。同步延遲意味著您的應用程式正在提供過期的資料。
Gas 價格飆升會影響任何提交交易的應用程式。當基礎手續費超過某個閾值,導致交易成本對您的使用情境而言變得不經濟時,系統會發出警示。這使您的應用程式能夠主動警告使用者、延後非緊急交易,或調整 Gas 參數。
當提交的交易未能在預期時間內獲得確認時,系統會觸發「交易卡住」警報。在正常情況下,若交易在Ethereum 上懸而未決超過 10 分鐘,很可能是因為 gas 價格不足,需要提高手續費後重新提交。
當您所依賴的區塊鏈發生區塊重組時,重組偵測警示會通知您。若您的資料處理管線在未等待最終確認的情況下,便處理鏈末端的區塊,則重組可能導致近期處理過的資料出現錯誤,需要進行修正。
「供應商健康警示」會追蹤您的 RPC 供應商的整體運作狀況。若該供應商的錯誤率驟升至超過您的閾值,您的應用程式應做好準備,切換至備用供應商,或進入服務降級狀態mode 。
哪些區塊鏈狀況應觸發警示? 除了標準的基礎設施警示外,區塊鏈應用程式還需要針對鏈狀態進行調整的警示。下表列出了常見的狀況及閾值範例。像重組(reorgs)這類狀況需要特別處理,我們將在「何謂區塊鏈重組」 一節中進行說明;而同步延遲則直接與節點可靠性 相關。
狀況
閾值範例
為何這很重要
節點同步延遲
3 個以上區塊 (Ethereum) 或 10 個以上插槽 (Solana)
您提供的資料已過時
汽油價格飆升
Base 超出您經濟承受能力的費用
交易成本變得過高
卡住的交易
已待處理超過 10 分鐘
價格可能偏低,需要重新提交
區塊鏈重組
比你的確認次數更深層
最近處理的資料可能有誤
服務提供者錯誤率
超越你的基準線
是時候切換到備用系統了
值班最佳實務 只有當有人能及時且妥善地回應警報時,警報系統才算有效。 建立健全的輪值機制,需包含:公平的輪值排程,將負擔均攤至equipe ;明確的升級流程,確保複雜問題能迅速轉交給適當的專家;完善的工具支援,讓值班工程師能立即存取儀表板、日誌及部署工具;事後檢討,藉此改善系統與警示設定;以及能體認輪值實際成本的薪酬或休假政策。
警示機制與高可用性是如何協同運作的? 警示功能會在系統發生故障時通知您,而高可用性則能在您處理問題的同時,確保服務持續運作。這兩者相輔相成:當您已準備好備援系統隨時接手時,服務狀態警示才能發揮最大效益。請將警示機制與高可用性 設計、自動化故障轉移 ,以及能實現快速應變的基礎架構冗餘 相結合。
Quicknode 如何實現有效的警示功能 Quicknode其內建的分析功能為區塊鏈基礎架構的警示機制提供了指標基礎。儀表板上可查看請求量、回應延遲、錯誤率以及方法層級的細項分析,並可據此設定警示閾值。對於擁有自訂警示基礎架構的團隊,Quicknode 的專用Clusters 可匯出相容於 Prometheus 的指標,這些指標可直接與 Alertmanager、Grafana Alerts、PagerDuty 或您技術堆疊中的任何警示系統整合。
Quicknode Streams 提供傳送健康指標,可針對資料管道問題觸發警示:包括傳送失敗、處理延遲及目的地錯誤。結合 RPC 層的警示功能,這能讓團隊全面涵蓋其即時 API 存取與串流資料基礎架構。
延伸閱讀
常見問題
什麼因素讓一則警示具有可操作性? 當應變人員確切知道該如何處理時,該警報才具有可操作性。警報應明確說明症狀、已逾越的閾值及當前數值、受影響的範圍、狀況持續的時間,並附上包含診斷與修復步驟的應變手冊連結。
何謂警報疲勞? 所謂的「警報疲勞」,是指當equipe 接收過多警報(尤其是誤報)時,系統會開始忽略所有警報,包括關鍵警報在內。提高閾值、設定持續時間要求、進行重複警報去重,以及採用嚴重性分級,都能有效減輕此現象。
是否應針對 CPU 使用率設定警示? 通常不應設定為頁面的觸發條件。CPU 是一項基於原因的指標,在正常運作期間常會出現突增,但不會影響使用者。請將其保留在儀表板上,並改為針對使用者可見的症狀(例如錯誤率升高或延遲增加)來觸發頁面通知。
該如何針對區塊鏈重組發出警示? 在您所依賴的區塊鏈上設定重組偵測功能,並在重組深度超過您設定的確認數時觸發警示。若您的處理流程僅處理區塊鏈最前端的區塊,則重組意味著近期資料需要進行修正。有關相關風險,請參閱「常見區塊鏈故障模式 」。
警示應採用哪些嚴重性等級? 一個簡單而有效的模式分為兩個層級:關鍵警報會立即發送傳呼通知,而警告警報則會發送到特定通訊頻道,供工作時間內進行審查。如此一來,傳呼通知便能保留給那些確實需要人員緊急處理的問題。
// Publisher
Quicknode
更新於 2026 年 6 月 2 日
2026年3月20日 — 閱讀時間 9 分鐘