Respuestas>Más información sobre RPC y API>¿Qué es la latencia de RPC?
¿Qué es la latencia RPC?
// Tags
Latencia de RPCLatencia de la cadena de bloquesTiempo de respuesta de la API
En resumen: la latencia RPC es el tiempo que tarda tu aplicación en enviar una solicitud a un nodo de la cadena de bloques y recibir una respuesta. Se mide en milisegundos y influye directamente en la rapidez con la que los usuarios perciben tu dapp. Una latencia elevada implica actualizaciones lentas del saldo, retrasos en las confirmaciones de las transacciones y la pérdida de oportunidades de negociación. Una baja latencia se traduce en una experiencia ágil y en tiempo real. La latencia RPC depende de la distancia de la red, el rendimiento de los nodos, la complejidad de las solicitudes y la calidad de tu proveedor de infraestructura.
La explicación sencilla
Cada vez que tu aplicación interactúa con la cadena de bloques, se produce un retraso entre el momento en que se formula la consulta y el momento en que se obtiene la respuesta. Ese retraso es la latencia. Cuando un usuario abre tu aplicación de monedero y espera medio segundo para ver su saldo, esa espera se debe principalmente a la latencia del RPC. Cuando un bot de trading envía una transacción de intercambio y tarda 200 milisegundos en recibir la confirmación de que el nodo la ha aceptado, esos 200 ms son latencia. La cifra puede parecer pequeña, pero en las aplicaciones de cadena de bloques, especialmente en DeFi, juegos y trading, esos milisegundos se traducen en diferencias reales en la experiencia del usuario y en los resultados financieros.
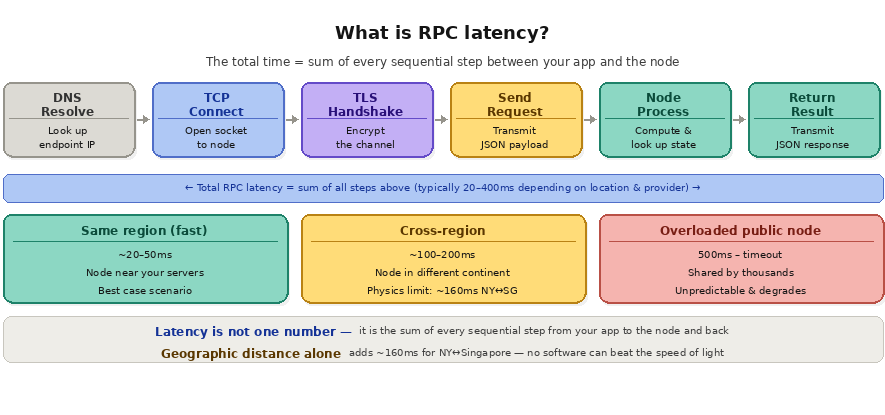
La latencia no es una cifra única. Es la suma de varios pasos secuenciales: resolución de DNS (búsqueda de la dirección IP de endpoint), establecimiento de la conexión TCP, protocolo de enlace TLS (cifrado de la conexión), transmisión de la solicitud, tiempo de procesamiento del nodo, transmisión de la respuesta y análisis de la respuesta. Cada paso añade tiempo. Una solicitud a un nodo de la misma región geográfica puede completarse en 20-50 ms. Una solicitud a un nodo situado al otro lado del mundo puede tardar entre 200 y 400 ms. La misma solicitud a un nodo sobrecargado o mal mantenido puede tardar segundos, o incluso agotar el tiempo de espera por completo.
Por qué la latencia es más importante de lo que crees
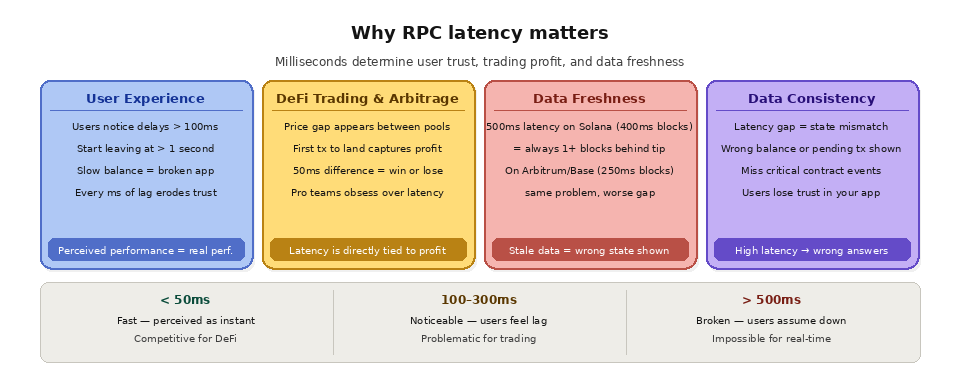
En el caso de las aplicaciones orientadas al usuario, la latencia es el factor más importante que influye en el rendimiento percibido. Los estudios realizados en aplicaciones web demuestran de forma sistemática que los usuarios perciben los retrasos superiores a 100 ms y comienzan a abandonar las interacciones cuando estos superan el segundo. Las aplicaciones basadas en blockchain no son una excepción. Si consultar el saldo tarda dos segundos porque tu proveedor de RPC es lento, los usuarios darán por hecho que tu aplicación no funciona, y no que la infraestructura subyacente tiene retrasos.
En el trading y el arbitraje de DeFi, la latencia está directamente relacionada con la rentabilidad. Cuando surge una discrepancia de precios entre dos fondos de liquidez, el primer bot que consigue realizar una transacción se lleva el beneficio. Una diferencia de 50 ms en el tiempo de respuesta del RPC puede determinar si tu transacción se incluye antes que la de un competidor. Por eso, los equipos de trading profesionales prestan especial atención a la latencia de la infraestructura y suelen utilizar puntos de conexión dedicados que se encuentran geográficamente próximos a los validadores.
En lo que respecta a la coherencia de los datos, la latencia crea un desfase entre el estado real de la cadena de bloques y lo que muestra tu aplicación. En Solana, donde se generan bloques cada 400 ms, un proveedor de RPC con una latencia media de 500 ms implica que tu aplicación siempre va, como mínimo, un bloque por detrás de la punta de la cadena. En las capas 2 (L2) de Ethereum , como Arbitrum o Base, que producen bloques cada 250 ms, se da el mismo problema. Quicknode introdujo una métrica denominada «Latency Freshness Score» (puntuación de frescura de la latencia) que compara el tiempo de respuesta del RPC con la tasa de producción de bloques de una cadena, lo que ofrece a los desarrolladores una medida precisa de hasta qué punto sus datos se acercan realmente al tiempo real.
¿Qué factores determinan la latencia de las RPC?
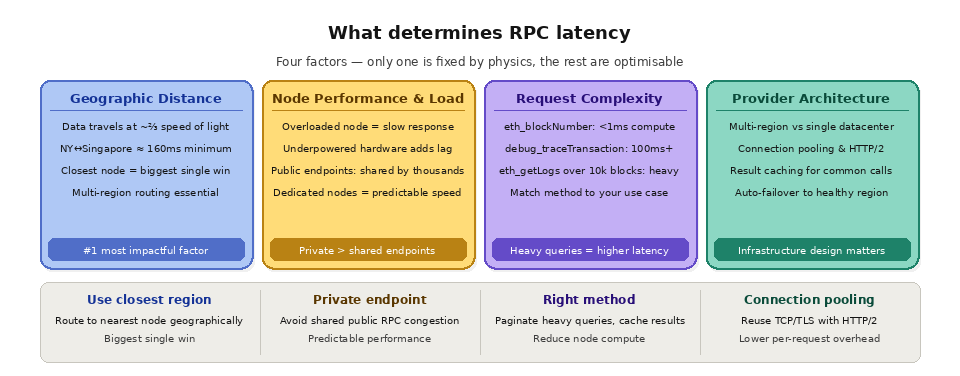
La distancia geográfica es el factor más importante. Los datos viajan por cables de fibra óptica a aproximadamente dos tercios de la velocidad de la luz, lo que significa que un trayecto de ida y vuelta entre Nueva York y Singapur añade unos 160 ms de retraso puramente físico que ninguna optimización de software puede eliminar. Conectarse a un nodo que se encuentre geográficamente cerca de tus servidores de aplicaciones (o de tus usuarios) es la medida más eficaz que puedes tomar para reducir la latencia.
El rendimiento y la carga de los nodos son el segundo factor. Un nodo que esté procesando miles de solicitudes simultáneas, que se esté retrasando en la sincronización de bloques o que se ejecute en un hardware con poca potencia responderá más lentamente que un nodo bien equipado y con poca carga. Este es el problema fundamental de los puntos finales RPC públicos: son compartidos por miles de usuarios, por lo que sus tiempos de respuesta son impredecibles y se deterioran durante los picos de tráfico.
La complejidad de la solicitud también es importante. Una simple llamada a «eth_blockNumber» apenas requiere cálculo y devuelve una respuesta muy breve. Una llamada a «debug_traceTransaction» obliga al nodo a volver a ejecutar una transacción completa y a devolver un registro detallado de la ejecución, lo que puede llevar cientos de milisegundos o más. Una consulta «eth_getLogs» que abarque miles de bloques obliga al nodo a analizar una cantidad considerable de datos. Comprender la carga computacional de tus llamadas RPC te ayuda a establecer expectativas adecuadas y a optimizar tus patrones de solicitud.
La arquitectura de la infraestructura del proveedor es el factor definitivo. Los proveedores que operan con nodos distribuidos a nivel mundial Clústeres con enrutamiento inteligente de solicitudes, agrupación de conexiones y almacenamiento en caché de resultados ofrecen una latencia menor y más constante que los proveedores que ejecutan nodos en un único centro de datos. Las arquitecturas multirregionales también aportan resiliencia: si una región experimenta problemas, el tráfico se redirige automáticamente a la siguiente región operativa más cercana.
¿Cuál es una buena latencia de RPC?
Un buen objetivo de latencia depende de la cadena a la que prestes servicio y de la ubicación de tus usuarios. El punto de referencia útil no es una cifra absoluta en milisegundos, sino cómo se compara tu tiempo de respuesta con la tasa de producción de bloques de la cadena: si respondes más lentamente de lo que la cadena produce bloques, tus datos siempre estarán desactualizados al menos un bloque. La tabla siguiente ofrece objetivos prácticos para la capacidad de respuesta en tiempo real.
Contexto
Tiempo de bloque
Objetivo de latencia para tiempo real
Solana
intervalo de ~400 ms
Menos de ~100 ms
Ethereum L2 (Base, Arbitrum)
~250 ms
Menos de ~100 ms
Ethereum L1
~12 segundos
Menos de ~250 ms
Solicitud dentro de la misma región
No aplicable
De 20 a 50 ms
Solicitud internacional
No aplicable
De 200 a 400 ms
Como regla general, los usuarios perciben los retrasos superiores a 100 ms, por lo que mantener las respuestas típicas de RPC por debajo de ese umbral da la sensación de que son instantáneas. Para comprender las llamadas que hay detrás de estas cifras, consulta cómo funcionan las solicitudes RPC y el papel del RPC endpoint.
¿Cuál es la diferencia entre latencia y ancho de banda?
A menudo se confunden la latencia y el rendimiento, pero miden cosas diferentes. La latencia es el tiempo que tarda una sola solicitud desde su envío hasta la respuesta. El rendimiento es el número de solicitudes que el sistema puede gestionar por unidad de tiempo. Un proveedor puede tener una latencia baja pero un rendimiento limitado, o un rendimiento alto pero una latencia irregular bajo carga. Ambos aspectos son importantes, y optimizar uno no mejora automáticamente el otro.
Aspecto
Latencia
Rendimiento
Medidas
Es hora de hacer una petición
Solicitudes gestionadas por segundo
Unidad
Milisegundos
Solicitudes por segundo
Se sintió como
La sensación de fluidez que transmite la aplicación
¿Qué carga puede soportar?
Herido por
Distancia y carga de los nodos
Límites de capacidad y topes tarifarios
Para un análisis más detallado de esta disyuntiva, véase «rendimiento frente a latencia». Un elevado volumen de solicitudes también puede activar la limitación de la tasa de RPC, lo que conlleva reintentos y colas que se traducen en una mayor latencia efectiva.
¿Cómo se puede reducir la latencia de las RPC?
Las mayores ventajas se obtienen reduciendo la distancia y aligerando la carga. Conéctate a un nodo geográficamente cercano a tus usuarios, utiliza un proveedor multirregional con enrutamiento automático y reutiliza las conexiones para evitar los costes repetidos de configuración de DNS, TCP y TLS. Agrupa o simplifica las llamadas pesadas y sustituye los bucles de sondeo frecuentes por una entrega basada en notificaciones push, de modo que no tengas que pagar repetidamente la latencia de las solicitudes por los mismos datos. Optar por el streaming en lugar del sondeo, confiar en nodos fiables y disponer de una ruta de conmutación por error permite mantener una latencia baja y constante, incluso cuando una ruta se ve afectada.
Preguntas frecuentes
¿La latencia del RPC es lo mismo que el tiempo de confirmación de un bloque?
No. La latencia RPC es el tiempo de ida y vuelta que se tarda en enviar una consulta a un nodo y obtener una respuesta, medido en milisegundos. El tiempo de confirmación de un bloque es el tiempo que tarda la cadena en incluir y finalizar una transacción, lo cual viene determinado por el protocolo. Una endpoint RPC rápida no puede hacer que una cadena confirme bloques más rápido que su tiempo de bloque.
¿Por qué va tan lento mi RPC endpoint ?
Las causas más habituales son la distancia geográfica al nodo, un nodo con una carga elevada o con recursos insuficientes, y tipos de solicitudes que consumen muchos recursos, como las consultas de rastreo o las consultas de registros de gran tamaño. Los puntos de acceso públicos compartidos por muchos usuarios son especialmente propensos a sufrir picos de latencia impredecibles durante los picos de tráfico.
¿Afecta la latencia a las operaciones de DeFi?
Sí, directamente. Cuando surge una oportunidad de arbitraje, la primera transacción que se procesa se lleva el beneficio, por lo que incluso una ventaja de 50 ms en el tiempo de respuesta del RPC puede determinar si tu transacción se incluye antes que la de un competidor.
¿Cómo se mide la latencia de RPC?
Es el tiempo transcurrido desde el envío de una solicitud hasta la recepción de la respuesta, que incluye la resolución DNS, el establecimiento de la conexión, el protocolo de enlace TLS, la transmisión, el procesamiento en los nodos y el análisis de la respuesta. Los equipos suelen hacer un seguimiento de los percentiles de latencia, como el p50 y el p99, en lugar de un único valor medio.
¿Una baja latencia implica que los datos son recientes?
No por sí solo. Un endpoint rápido que vaya retrasado en la sincronización de bloques puede devolver resultados obsoletos rápidamente. Para garantizar la actualidad en tiempo real se requiere tanto una baja latencia como un nodo que esté perfectamente sincronizado con la punta de la cadena; por eso, el tiempo de respuesta debe compararse con la tasa de producción de bloques.
Cómo consigue « Quicknode » una baja latencia
QuicknodeLa infraestructura de [nombre] está diseñada específicamente para el acceso a datos de blockchain con baja latencia. La plataforma opera una red distribuida a nivel mundial que abarca más de 14 regiones a través de más de 5 proveedores de servicios en la nube y de servidores físicos, lo que garantiza que las solicitudes se dirijan al nodo disponible más cercano, independientemente de dónde se encuentren su aplicación o sus usuarios. Esta arquitectura ofrece tiempos de respuesta 2,5 veces más rápidos que los de la competencia de media, según las mediciones de QuickLee, la herramienta de evaluación comparativa de RPC de código abierto de Quicknode que proporciona datos de latencia transparentes y en tiempo real en múltiples cadenas y regiones.
Quicknode mantiene una alta actualidad en la altura de los bloques en todas las cadenas compatibles, lo que significa que sus nodos están siempre perfectamente sincronizados con el último bloque. Esto es fundamental para las cadenas de evolución rápida, en las que quedarse atrás incluso unas pocas bloques respecto a la punta de la cadena reduce la actualidad de los datos. La infraestructura se adapta automáticamente en función de la demanda de tráfico e incluye mecanismos de conmutación automática ante fallos, por lo que la latencia se mantiene constante incluso durante los picos de tráfico.
Para aplicaciones con los requisitos de latencia más exigentes, los servidores « Clústeres »dedicados de Quicknode ofrecen una infraestructura aislada y privada, sin tráfico compartido con otros clientes. Los servidores « » dedicados Clústeres Quicknodeeliminan por completo el problema del «vecino ruidoso», ofreciendo un rendimiento predecible y de baja latencia en todo momento. En el caso concreto de Solana , los Yellowstone gRPC puntos finales de xml-ph-0001@deepl.internal utilizan Protocol Buffers en lugar de JSON para la serialización de datos, lo que reduce el tamaño de la carga útil y el tiempo de análisis para lograr la menor latencia posible en casos de uso de alta frecuencia.