Respuestas>Más información sobre los nodos de blockchain>Por qué es importante la fiabilidad de los nodos
Por qué es importante la fiabilidad de los nodos
// Tags
fiabilidad de los nodostiempo de actividad de la cadena de bloques
En resumen: La fiabilidad de un nodo es la medida de la consistencia y precisión con la que un nodo de cadena de bloques responde a las solicitudes sin tiempos de inactividad, errores ni datos obsoletos. Para cualquier aplicación que lea o escriba en una cadena de bloques, una infraestructura de nodos poco fiable se traduce en transacciones fallidas, saldos incorrectos, eventos perdidos y una experiencia de usuario deficiente. En entornos de producción, la fiabilidad de los nodos no es algo prescindible. Es la base sobre la que se sustenta todo lo demás.
La explicación sencilla
Cada interacción que tu aplicación tiene con una cadena de bloques pasa por un nodo. Cuando un usuario consulta el saldo de su monedero, un nodo responde a esa consulta. Cuando alguien realiza un intercambio en una plataforma de intercambio descentralizada, un nodo difunde esa transacción. Cuando tu backend está a la espera de eventos de contratos inteligentes, un nodo transmite esos eventos. Si el nodo es lento, está inactivo o devuelve datos obsoletos, tu aplicación deja de funcionar, lo que afecta directamente a tus usuarios y a tus ingresos.
Piensa en la fiabilidad de los nodos del mismo modo que pensarías en el tiempo de actividad de una base de datos para una aplicación web tradicional. Si tu base de datos deja de estar disponible, tu aplicación no puede leer ni escribir datos. Los usuarios ven mensajes de error, las transacciones fallan y la confianza se erosiona. Los nodos de blockchain cumplen la misma función que tu capa de base de datos, salvo que los datos que manejan son de naturaleza financiera. Un saldo desactualizado podría provocar que un usuario se quedara en descubierto. Una transacción fallida podría suponer la pérdida de una operación. Un evento retrasado podría desencadenar liquidaciones incorrectas en un protocolo DeFi. Hay mucho más en juego y la tolerancia al fallo es menor.
Cuánto te cuestan realmente los nodos poco fiables
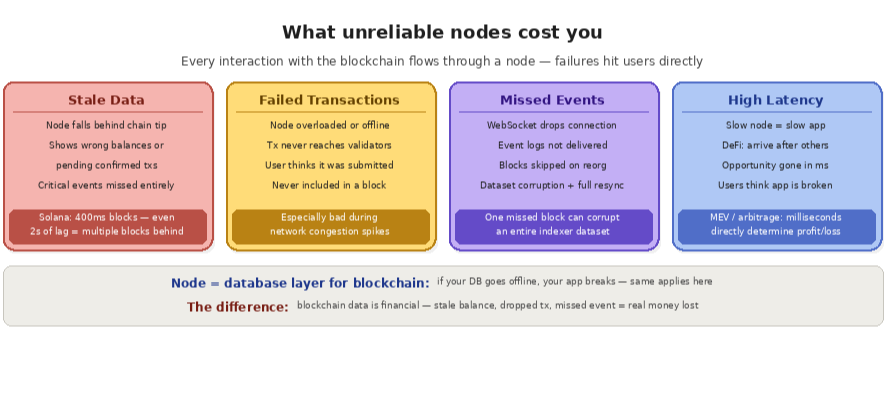
Las consecuencias de una fiabilidad deficiente de los nodos se manifiestan de múltiples formas, y la mayoría de ellas no se aprecian de inmediato hasta que surge algún problema en el entorno de producción.
Los datos obsoletos constituyen uno de los modos de fallo más peligrosos. Si tu nodo se queda rezagado respecto a la punta de la cadena (el bloque confirmado más reciente), empieza a proporcionar un estado desactualizado. Tu aplicación podría mostrar a un usuario un saldo que ya no existe, indicar que una transacción está pendiente cuando ya se ha confirmado, o pasar por alto por completo un evento crítico de un contrato inteligente. En cadenas rápidas como Solana , donde se generan bloques cada 400 milisegundos, incluso unos pocos segundos de retraso en la sincronización pueden significar que tu aplicación vaya varios bloques por detrás de la realidad.
Las transacciones fallidas suponen otro gasto importante. Cuando se envía una transacción a través de un nodo, este debe difundirla al mempool de la red (o su equivalente). Si el nodo está sobrecargado, desconectado de los pares o mal configurado, es posible que la transacción nunca llegue a los validadores. El usuario cree que su transacción se ha enviado, pero esta nunca llega a incluirse en un bloque. En cadenas de alto rendimiento o durante períodos de congestión de la red, esto puede ocurrir con frecuencia en nodos con poca potencia o mal mantenidos.
Los eventos perdidos afectan a cualquier aplicación que dependa de datos de la cadena de bloques en tiempo real. Si tu nodo pierde las conexiones WebSocket, no envía los registros de eventos o omite bloques durante una reorganización, tu aplicación perderá datos. En el caso de los indexadores, las plataformas de análisis y cualquier sistema que necesite un registro completo de la actividad en la cadena de bloques, incluso un solo bloque perdido puede corromper tu conjunto de datos y requerir una resincronización completa.
La latencia afecta directamente a los casos de uso competitivos. En el trading de DeFi, la extracción de MEV y el arbitraje, cada milisegundo cuenta. Un nodo lento implica que tu transacción llega después de la de otra persona, y la oportunidad se pierde. En el caso de aplicaciones en las que el tiempo no es tan crítico, una latencia elevada sigue degradando la experiencia del usuario. Los usuarios esperan que los saldos de sus carteras se actualicen al instante y que las transacciones se confirmen rápidamente. Las respuestas lentas de los nodos hacen que tu aplicación parezca que no funciona bien, incluso cuando la propia cadena de bloques funciona correctamente.
¿Qué hace que un nodo sea fiable?
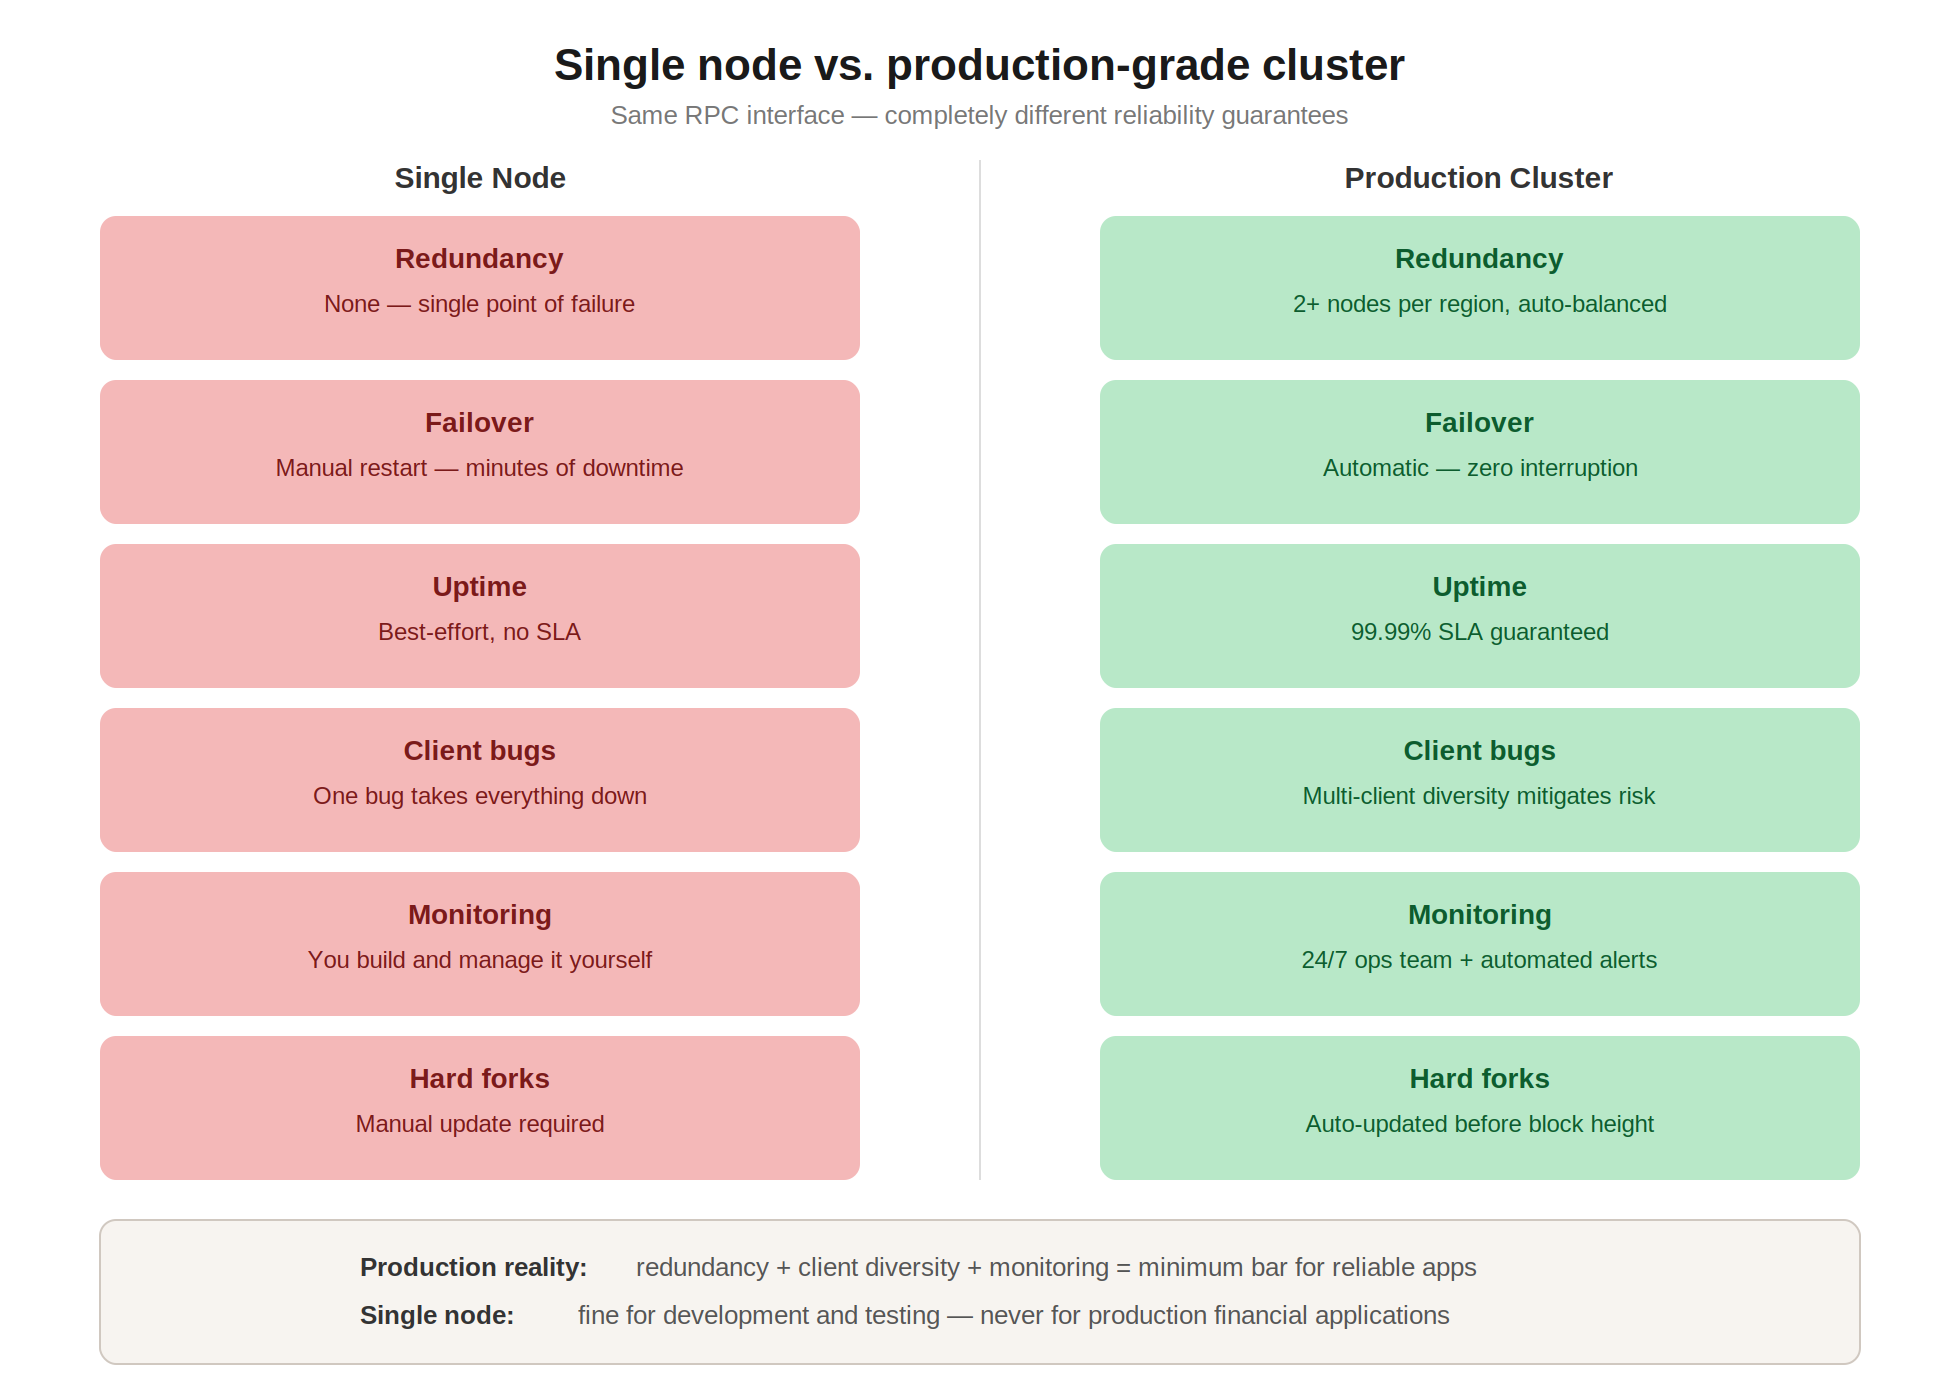
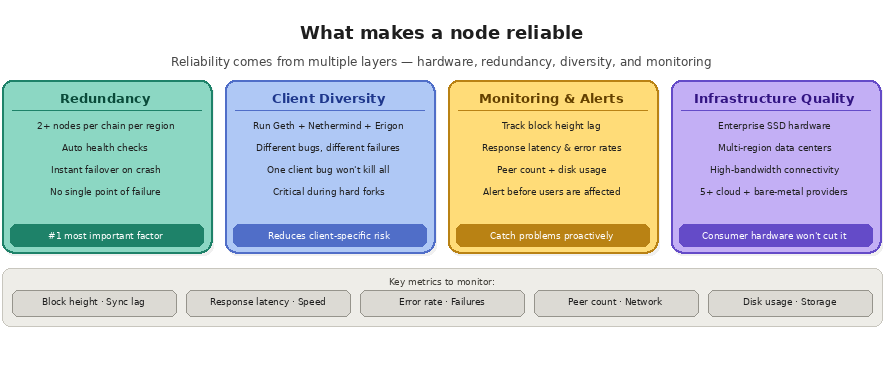
La fiabilidad se basa en múltiples factores: la calidad del hardware, la configuración del software, la conectividad de red, la redundancia y la supervisión operativa. Un único nodo que funcione con hardware de consumo y una conexión a Internet doméstica nunca podrá igualar la fiabilidad de un clúster de nodos gestionado profesionalmente y distribuido entre varios centros de datos y proveedores de servicios en la nube.
La redundancia es el factor más importante. Si un único nodo deja de funcionar (debido a un fallo del sistema, un fallo del disco o un error del cliente), un sistema redundante realiza una conmutación por error a un nodo en buen estado sin que se produzca ninguna interrupción en tu aplicación. Sin redundancia, un único punto de fallo puede dejar toda tu aplicación fuera de servicio. La infraestructura de nivel de producción suele ejecutar dos o más nodos de la misma cadena dentro de una región, con comprobaciones automáticas del estado y enrutamiento del tráfico.
La diversidad de clientes también es importante. Las diferentes implementaciones de clientes de blockchain (por ejemplo, Geth, Nethermind y Erigon en Ethereum) presentan características de rendimiento distintas, errores diferentes y modos de fallo distintos. Utilizar varias implementaciones de clientes reduce el riesgo de que un error en un cliente provoque la caída de toda la infraestructura. Esto es especialmente importante durante las bifurcaciones duras y las actualizaciones de protocolo, momentos en los que es más probable que surjan problemas específicos de cada cliente.
La supervisión y las alertas son esenciales para detectar los problemas antes de que afecten a los usuarios. Una infraestructura de nodos bien gestionada realiza un seguimiento continuo de métricas como la altura del bloque (para detectar retrasos en la sincronización), la latencia de respuesta, las tasas de error, el número de pares y el uso del disco. Cuando alguna métrica supera un umbral, las alertas automáticas activan una investigación o una conmutación por error antes de que el problema llegue al entorno de producción.
¿Cómo se mide la fiabilidad de un nodo?
La fiabilidad no es una cifra aislada, sino un conjunto de indicadores que, en su conjunto, permiten determinar si se puede confiar en un nodo en entorno de producción. La tabla siguiente muestra las métricas más importantes, lo que indica cada una de ellas y el rango que debe mantener una configuración apta para producción.
Métrico
Qué te indica
Objetivo de producción
Acuerdo de nivel de servicio (SLA) sobre tiempo de actividad
Porcentaje de tiempo en que el « endpoint » está disponible
99,9 % o más
Índice de error
Porcentaje de solicitudes que devuelven errores
Por debajo del 0,1 %
Retraso en la sincronización
Distancia detrás de la punta de la cadena
Entre 0 y 1 manzana
Latencia de respuesta (p99)
El 1 % de las respuestas más lentas
Menos de 500 ms
Número de pares
Conectividad de red óptima
Se mantiene por encima del mínimo del cliente
El tiempo de actividad es la cifra más destacada, pero un nodo puede estar «activo» y, aun así, resultar poco fiable si va rezagado respecto a la punta de la cadena o devuelve errores. Realiza un seguimiento continuo de estas señales en lugar de comprobarlas de forma puntual. Para obtener una visión completa de cómo implementar la instrumentación en un endpoint, consulta la sección sobre supervisión de la infraestructura de la cadena de bloques.
¿Qué provoca que falle un nodo de blockchain?
Los nodos fallan tanto por causas internas como externas. A nivel interno, un disco que se llena, una fuga de memoria o un error en el software de un cliente pueden provocar el bloqueo o la paralización de un nodo. A nivel externo, las particiones de red, la pérdida de pares y los picos de tráfico durante la congestión de la red pueden desbordar un nodo con recursos insuficientes. Las actualizaciones de protocolo y las bifurcaciones duras son momentos especialmente arriesgados, ya que un error específico de un cliente puede provocar la caída de todos los nodos que lo ejecutan. Comprender los modos de fallo habituales de las cadenas de bloques te ayuda a diseñar una infraestructura que se degrade de forma controlada en lugar de dejar de funcionar por completo.
¿Cómo mejora la conmutación por error la fiabilidad de los nodos?
La conmutación por error es el mecanismo que convierte varios nodos individuales en un único servicio fiable. Las comprobaciones de estado supervisan cada nodo y, cuando uno de ellos presenta un fallo o se desconecta, el tráfico se redirige automáticamente a un nodo en buen estado, de modo que tu aplicación nunca nota la interrupción del servicio. Este es el núcleo de la alta disponibilidad y depende de la redundancia de la infraestructura: ejecutar más de un nodo para que siempre haya una copia de seguridad lista. Descubre qué es la conmutación por error para ver cómo funciona en la práctica esta transición sin interrupciones.
¿Deberías gestionar tu propio nodo o recurrir a un proveedor?
Gestionar tu propio nodo te ofrece un control total, pero hace que toda la responsabilidad en materia de fiabilidad recaiga sobre ti equipe: hardware, redundancia, supervisión, actualizaciones y cobertura de guardia las 24 horas del día, los 7 días de la semana. Un proveedor gestionado asume esa carga operativa y te ofrece un conjunto de nodos distribuidos y redundantes desde la primera solicitud. La elección adecuada depende de tu escala, presupuesto y tolerancia al riesgo operativo, y puede variar según la carga de trabajo, ya que un nodo de archivo es mucho más pesado de alojar por cuenta propia que un nodo completo. Consulta «crear o comprar» para obtener un marco de referencia que te ayude a tomar la decisión.
Cómo garantiza la fiabilidad « Quicknode »
QuicknodeLa infraestructura de está diseñada específicamente para garantizar la fiabilidad de la producción a gran escala. La plataforma procesa miles de millones de solicitudes de API a diario en más de 80 redes blockchain con un acuerdo de nivel de servicio (SLA) que garantiza un tiempo de actividad del 99,99 %. Esta fiabilidad se debe a una arquitectura distribuida a nivel mundial que abarca más de 14 regiones y más de 5 proveedores de servicios en la nube y de servidores físicos, múltiples implementaciones de clientes por cadena, conmutación automática ante fallos y equilibrio de carga, así como una supervisión ininterrumpida a cargo de un equipo dedicado a las operaciones de blockchain equipe.
Quicknode utiliza nodos específicos para cada tipo de uso Clústeres, lo que significa que el tráfico se redirige a nodos optimizados para el tipo de solicitud que se realiza. Las cargas de trabajo con un uso intensivo de lectura, las consultas a archivos y la difusión de transacciones se dirigen a una infraestructura ajustada a cada patrón específico. Este enfoque ofrece un rendimiento constante bajo cargas variables, en lugar de deteriorarse cuando se producen picos de tráfico.
Para los equipos con los requisitos de fiabilidad más exigentes, los clústeres de nodos de Dedicated Clústeres de Quicknode ofrecen una infraestructura de nodos privada y totalmente aislada. Cada clúster ejecuta nodos redundantes dentro de una región, con rutas de distribución independientes, por lo que ningún tráfico compartido de otros clientes puede afectar a tu rendimiento. Los clústeres de nodos de Dedicated Clústeres incluyen acuerdos de nivel de servicio (SLA) con tiempo de actividad garantizado, compatibilidad con Prometheus Exporter para la monitorización personalizada y una retención de registros de 14 días para una visibilidad operativa completa. Este nivel de infraestructura es el que da servicio a algunas de las carteras, plataformas de intercambio y protocolos DeFi más grandes de Web3.
Preguntas frecuentes
¿Qué es la fiabilidad de los nodos en una cadena de bloques?
La fiabilidad de un nodo se refiere a la consistencia y precisión con las que un nodo de la cadena de bloques responde a las solicitudes sin tiempos de inactividad, errores ni datos obsoletos. Un nodo fiable se mantiene sincronizado con la punta de la cadena, responde rápidamente y permanece disponible para que tu aplicación pueda leer y escribir datos de la cadena de bloques sin interrupciones.
¿Cuál es un buen acuerdo de nivel de servicio (SLA) en cuanto a tiempo de actividad para un nodo de blockchain?
Las aplicaciones de producción deben tener como objetivo un tiempo de actividad del 99,9 % o superior, lo que permite un tiempo de inactividad de menos de unas 9 horas al año. Las cargas de trabajo exigentes, como las plataformas de intercambio y los protocolos DeFi, suelen requerir un SLA del 99,99 %, lo que deja menos de una hora de tiempo de inactividad al año.
¿Cómo se supervisa la fiabilidad de los nodos?
Realiza un seguimiento continuo de la variación en la altura de los bloques, la tasa de error, la latencia de respuesta y el número de pares, y envía una alerta cuando alguno de estos parámetros supere un umbral. Al combinar estas métricas con los registros y los rastros, no solo se observa que un nodo está experimentando un deterioro, sino también el motivo, lo que te permite aplicar una conmutación por error o solucionarlo antes de que los usuarios se den cuenta.
¿Cuál es la diferencia entre la fiabilidad de un nodo y el rendimiento de un nodo?
El rendimiento tiene que ver con la velocidad, es decir, con la rapidez con la que responde un nodo. La fiabilidad tiene que ver con la consistencia, es decir, con si el nodo responde correctamente y se mantiene disponible a lo largo del tiempo. Un nodo puede ser rápido pero poco fiable si se cuelga a menudo, y fiable pero lento si carece de la potencia necesaria. La infraestructura de producción necesita ambas cosas.
¿El uso de varios nodos mejora la fiabilidad?
Sí. El uso de nodos redundantes con conmutación automática en caso de fallo elimina los puntos únicos de fallo, por lo que el fallo de un nodo no provoca que la aplicación deje de estar disponible. Esta redundancia es la base de la alta disponibilidad en la infraestructura de blockchain.