Respuestas>Más información sobre fiabilidad y tiempo de actividad>Por qué es importante la redundancia de la infraestructura
Por qué es importante la redundancia de las infraestructuras
// Tags
redundancia de la infraestructura
En resumen: La redundancia consiste en disponer de componentes de respaldo en cada capa de la infraestructura, de modo que, cuando algo falla, un duplicado toma el relevo automáticamente. En la cadena de bloques, la redundancia entre nodos, regiones, proveedores de nube e implementaciones de clientes es lo que distingue a los sistemas aptos para producción de los que son frágiles.
Qué significa realmente la redundancia
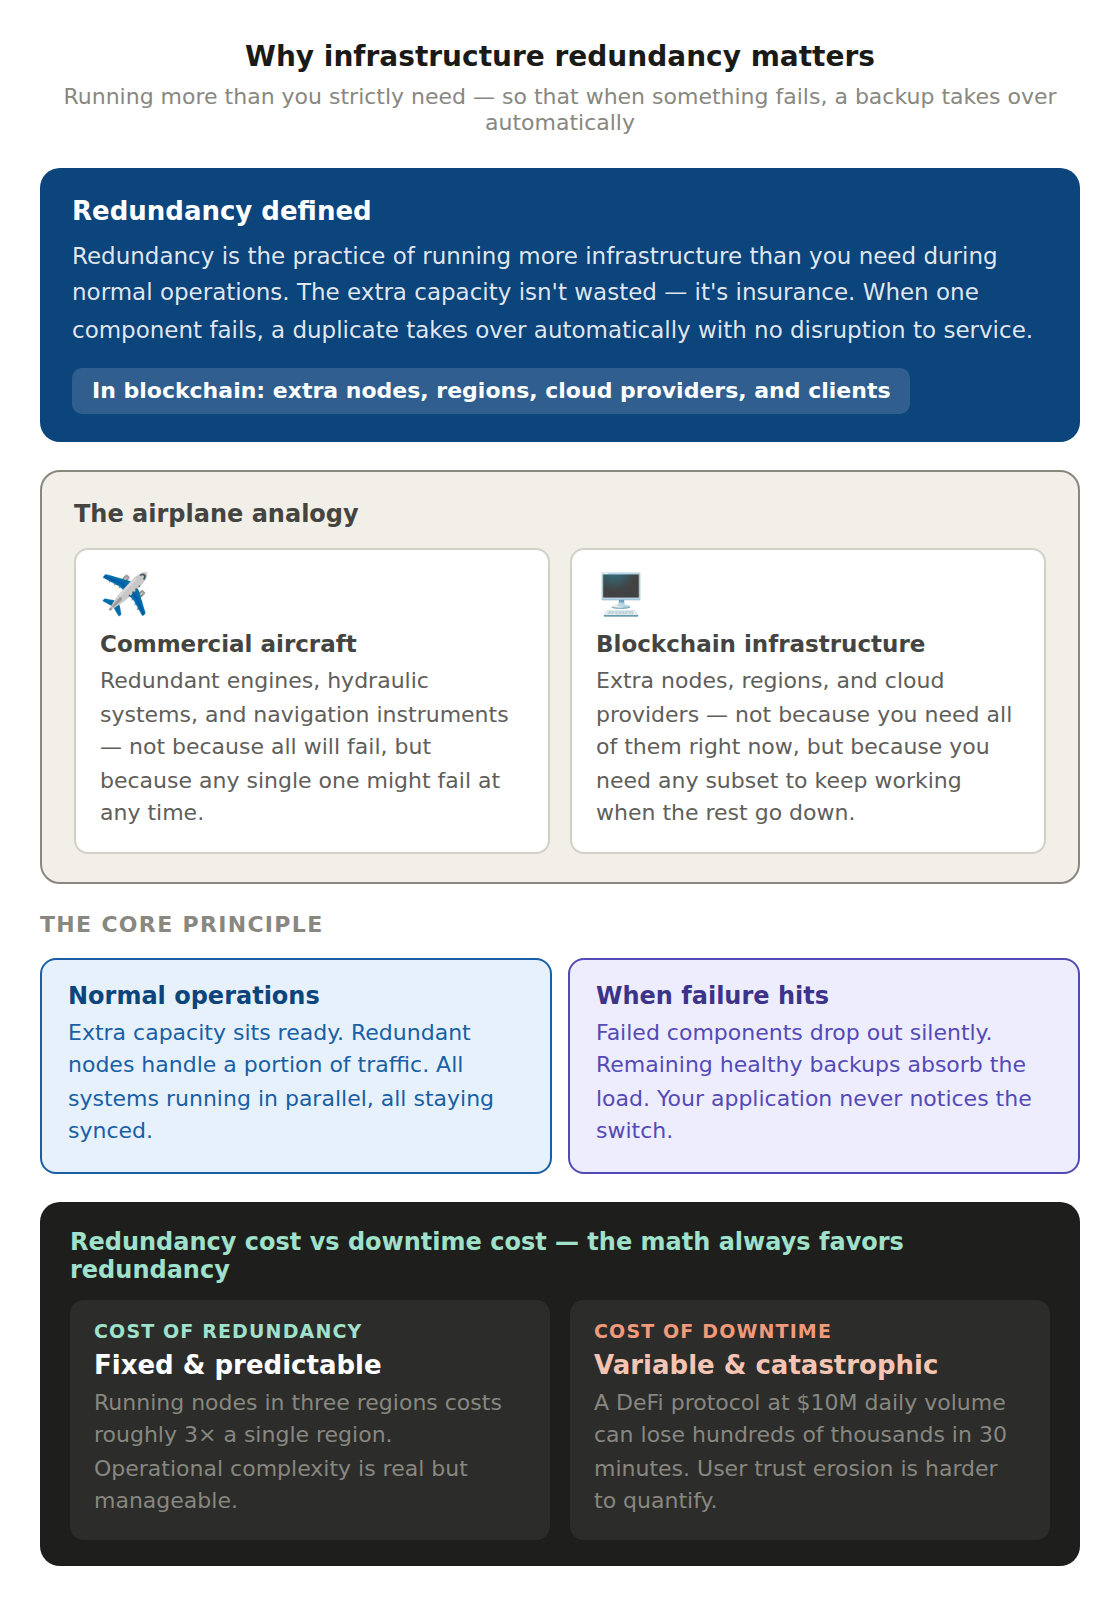
La redundancia consiste en disponer de más recursos de los estrictamente necesarios durante el funcionamiento normal. Esa capacidad adicional no se desperdicia, sino que sirve de garantía.
Piensa en ello como si fuera un avión. Los aviones comerciales cuentan con motores redundantes, sistemas hidráulicos redundantes e instrumentos de navegación redundantes. No porque se espere que todos fallen a la vez, sino porque cualquiera de ellos podría fallar en cualquier momento. Los sistemas redundantes garantizan que el avión siga volando incluso si algo falla.
La redundancia de la infraestructura se rige por el mismo principio. Se gestionan nodos adicionales, en regiones adicionales y en proveedores de nube adicionales, no porque se necesiten todos ellos en este momento, sino porque se necesita que cualquier subconjunto de ellos siga funcionando cuando el resto deje de hacerlo.
Los niveles de redundancia
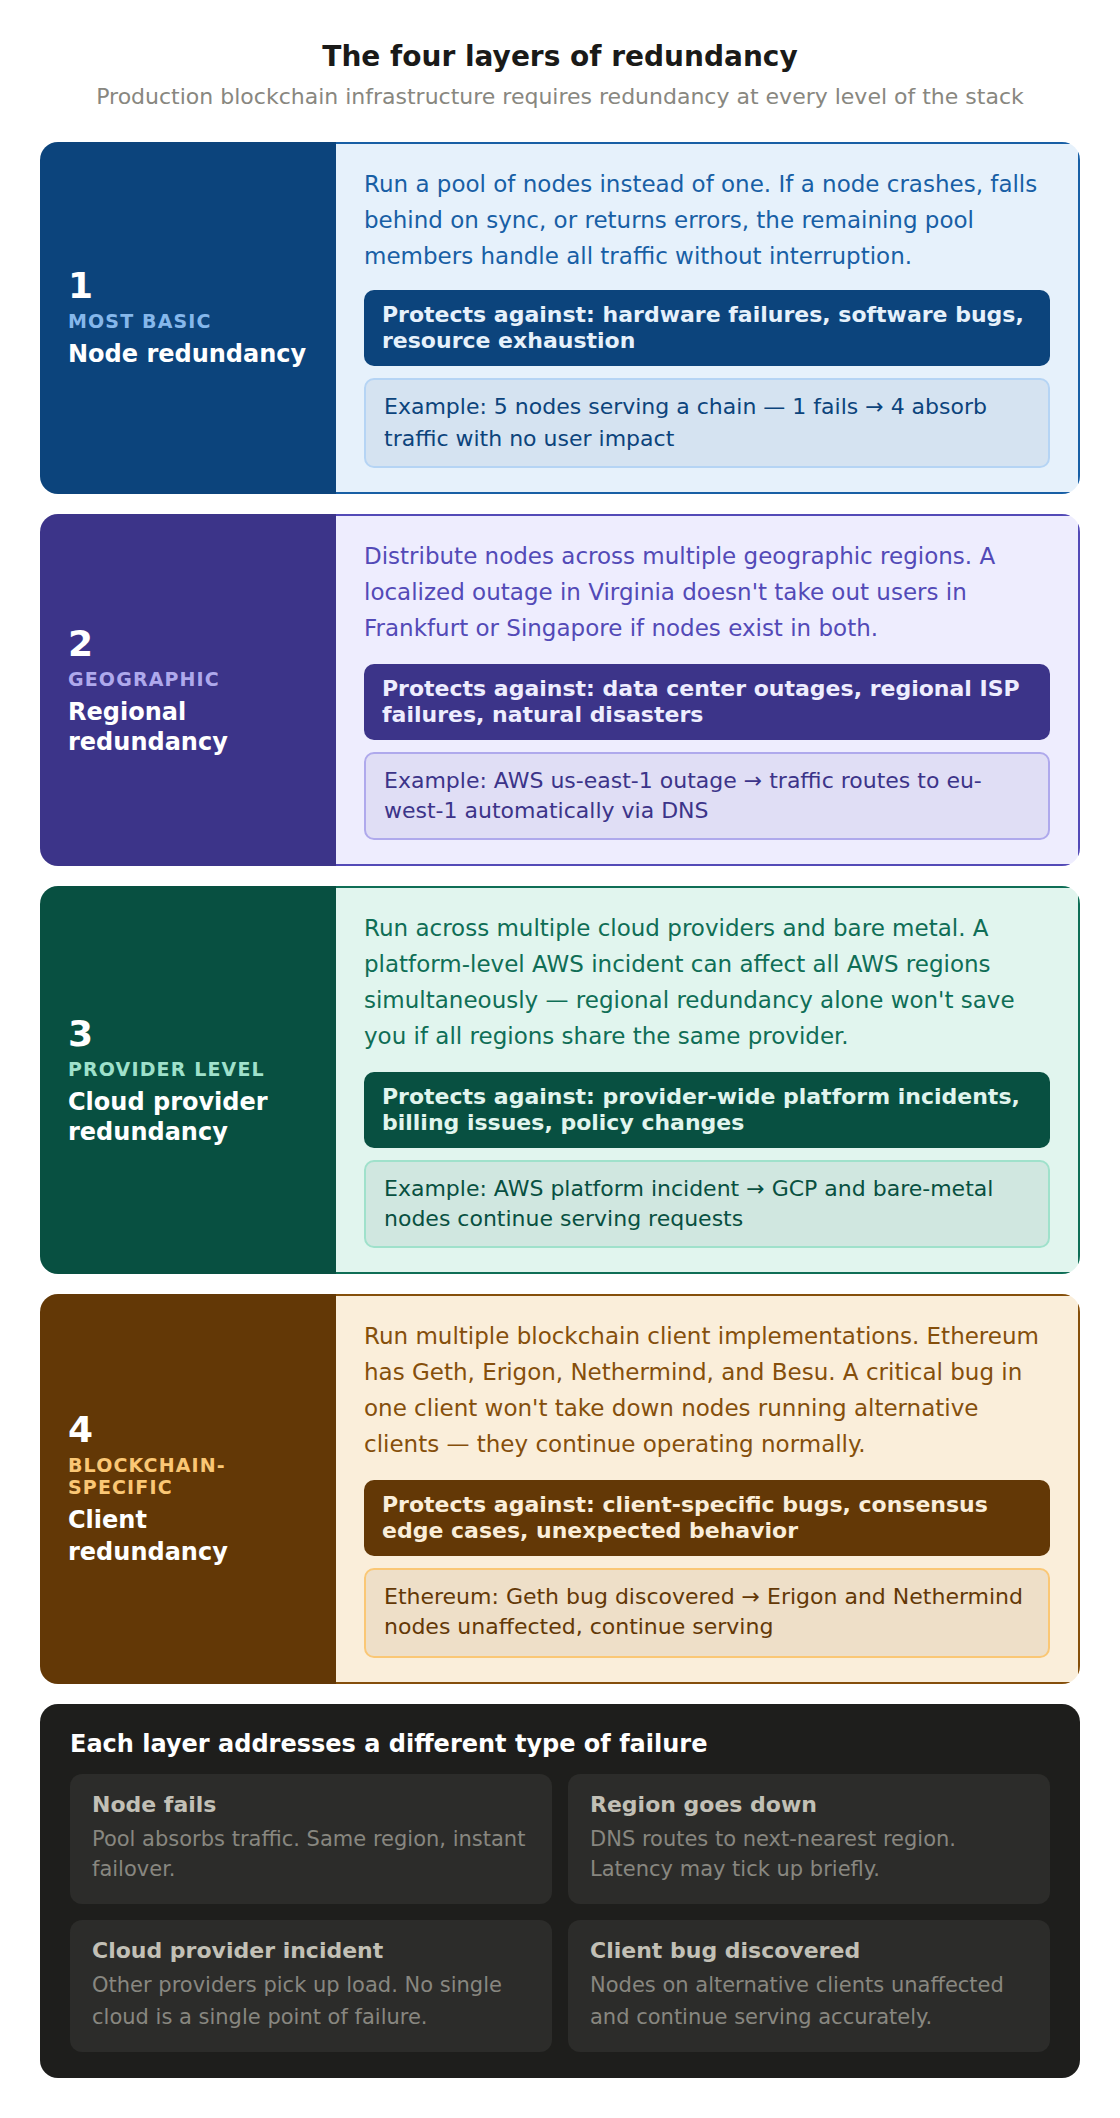
La infraestructura de blockchain en producción requiere redundancia en varios niveles. Cada capa se encarga de un tipo diferente de fallo.
La redundancia de nodos es la forma más básica. En lugar de depender de un único nodo para una cadena de bloques determinada, se gestiona un conjunto de nodos. Si un nodo falla, se queda rezagado en la sincronización o empieza a devolver errores, los nodos restantes del conjunto se encargan de gestionar el tráfico. Esto protege frente a fallos de hardware puntuales, errores de software en un proceso específico del nodo o el agotamiento de recursos en una sola máquina.
La redundancia regional protege frente a fallos de mayor envergadura. Si todos tus nodos se ejecutan en una única región de AWS y esa región sufre una interrupción del servicio (algo que ocurre con más frecuencia de lo que la mayoría de la gente cree), todo deja de funcionar al mismo tiempo. Distribuir los nodos entre varias regiones geográficas garantiza que un incidente localizado en Virginia no afecte a tus usuarios de Fráncfort o Singapur.
La redundancia de los proveedores de servicios en la nube va un paso más allá. Si toda tu infraestructura se ejecuta en un único proveedor de servicios en la nube y ese proveedor sufre una incidencia a nivel de plataforma, la redundancia regional por sí sola no te salvará. Utilizar varios proveedores (AWS, GCP, servidores físicos, etc.) significa que una interrupción específica de un proveedor no se convierte en tu propia interrupción.
La redundancia de clientes es una característica específica de las cadenas de bloques. La mayoría de las principales cadenas de bloques cuentan con múltiples implementaciones de clientes de nodo. Ethereum cuenta con Geth, Erigon, Nethermind y Besu. Solana cuenta con el cliente validador y Firedancer. Si aparece un error crítico en un cliente, los nodos que ejecutan clientes alternativos siguen funcionando con normalidad. Los proveedores que ejecutan un conjunto diverso de clientes son más resistentes a los fallos a nivel de software.
¿Qué ocurre si no hay redundancia?
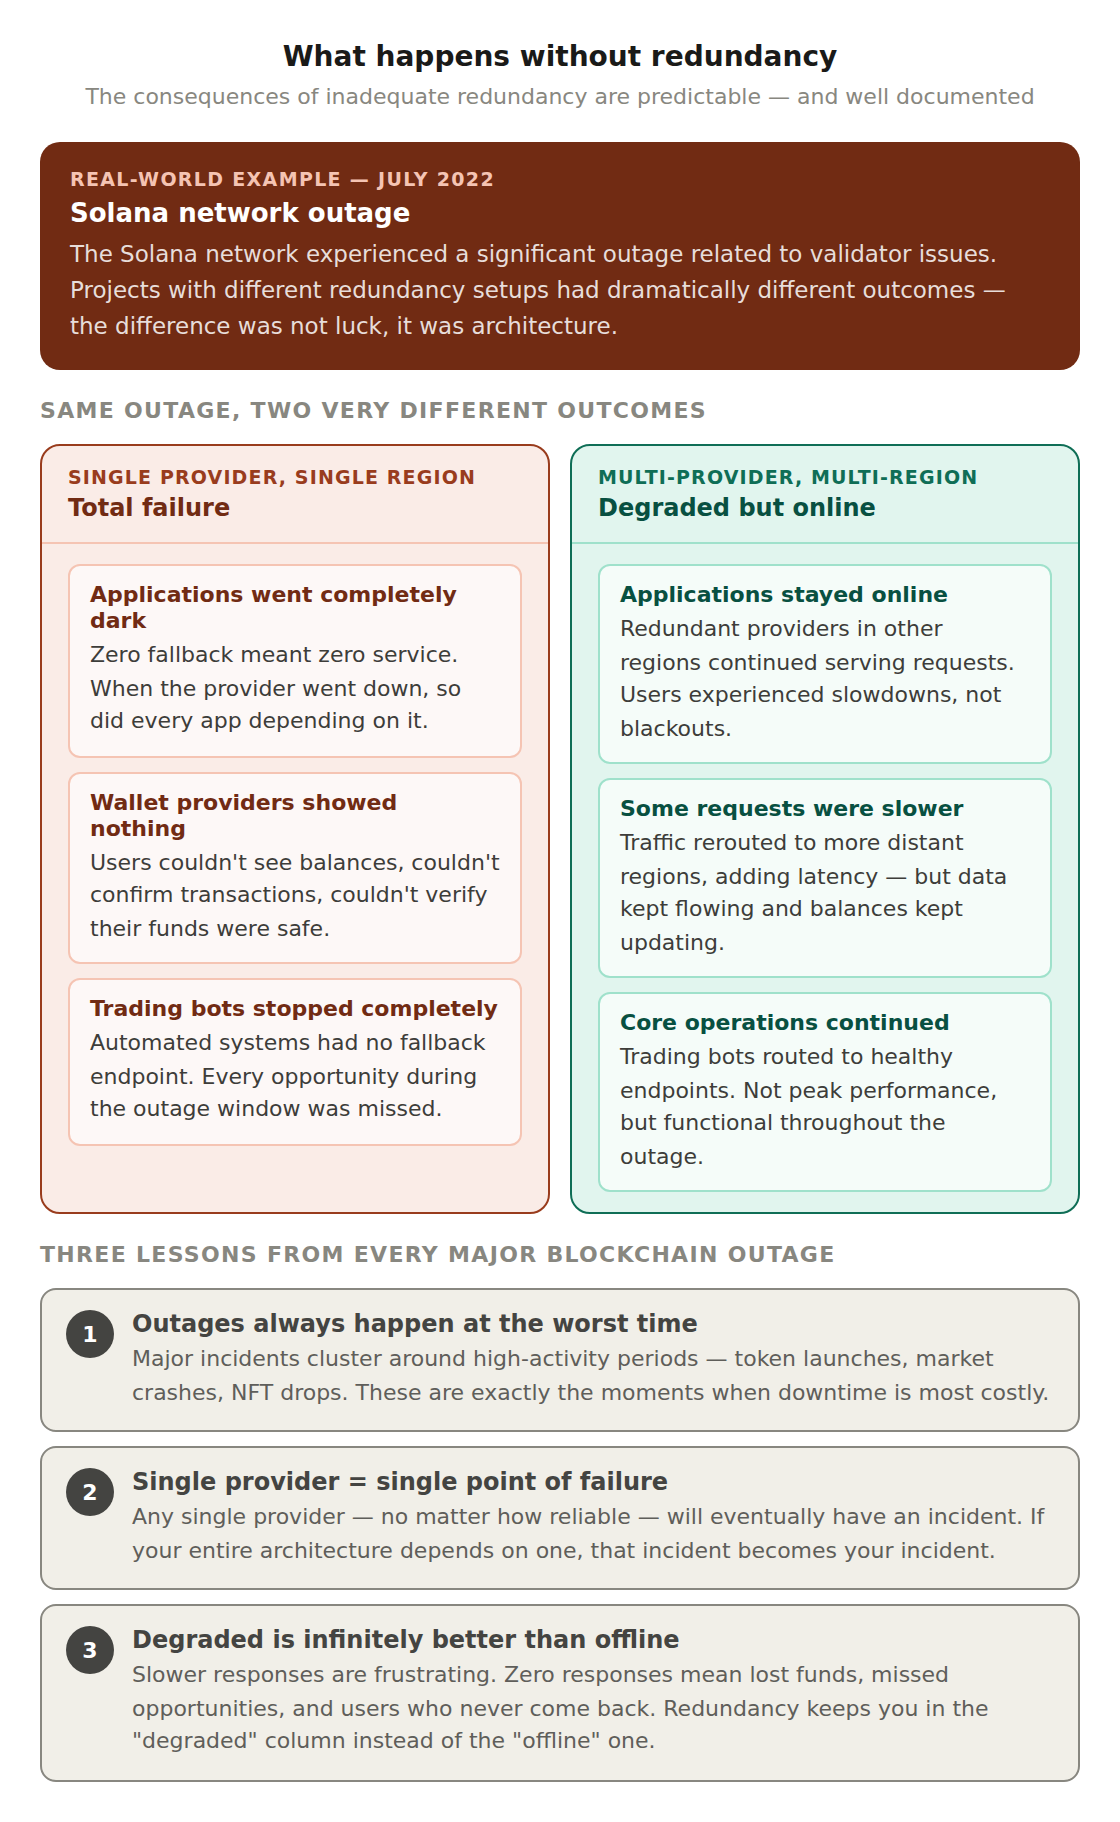
Las consecuencias de una redundancia insuficiente son previsibles y están bien documentadas. En julio de 2022, la red Solana sufrió una interrupción significativa relacionada, en parte, con problemas en los validadores. Los proyectos que dependían de un único proveedor de RPC en una sola región carecían por completo de un plan de contingencia. Sus aplicaciones dejaron de funcionar por completo. Los proveedores de carteras no podían mostrar los saldos. Los bots de negociación dejaron de funcionar. Los paneles de control no mostraban nada.
Compárese esto con proyectos que cuentan con configuraciones con varios proveedores y en varias regiones. En ellos se produjo una disminución del rendimiento, pero no un fallo total. Algunas solicitudes tardaron más en procesarse, pero las aplicaciones se mantuvieron en línea. La diferencia no fue cuestión de suerte. Fue la redundancia.
El coste de la redundancia frente al coste del tiempo de inactividad
Una objeción habitual a la redundancia es el coste. Mantener nodos en tres regiones cuesta aproximadamente tres veces más que mantenerlos en una sola. Operar con dos proveedores de nube añade otra capa de complejidad operativa y de gastos.
Pero hay que tener en cuenta el coste del tiempo de inactividad. Para un protocolo DeFi que procesa un volumen diario de 10 millones de dólares, incluso 30 minutos de inactividad durante las horas punta pueden suponer cientos de miles en operaciones perdidas, fallos en las liquidaciones y una merma de la confianza de los usuarios. Para un mercado de NFT durante una caída importante, unos pocos minutos fuera de línea pueden significar perder a todo un grupo de usuarios a favor de un competidor que se haya mantenido operativo.
Las cifras casi siempre favorecen la redundancia en las aplicaciones de producción. El coste de la infraestructura es fijo y predecible. El coste del tiempo de inactividad es variable y, a menudo, catastrófico.
¿Cuál es la diferencia entre redundancia y conmutación por error?
La redundancia y la conmutación por error funcionan conjuntamente, pero no son lo mismo. La redundancia consiste en disponer de capacidad de reserva: nodos, regiones y proveedores adicionales que estén listos para entrar en acción. La conmutación por error es el mecanismo que detecta realmente un fallo y desvía el tráfico hacia esa capacidad de reserva. La redundancia sin conmutación por error significa que tienes copias de seguridad a las que nadie recurre; la conmutación por error sin redundancia significa que tienes un mecanismo de conmutación sin nada a lo que conmutar. Se necesitan ambas cosas para lograr una verdadera resiliencia.
¿Cómo mejora la redundancia el tiempo de actividad?
Cada capa de redundancia elimina un punto único de fallo distinto, por lo que cuantas más capas independientes se apilen, menor será la probabilidad de que un solo fallo provoque una interrupción total del servicio. En la tabla siguiente se indica a qué fallo protege cada capa de redundancia.
Capa de redundancia
Protege contra
Ejemplo de fallo
Redundancia de nodos
Fallo de un único nodo
Fallos, retrasos en la sincronización o errores
Redundancia regional
Toda una región se va al garete
Interrupción del servicio en la región de la nube
Redundancia de los proveedores de servicios en la nube
No hay una única respuesta correcta; el objetivo es ajustar la redundancia al coste que supone una interrupción del servicio. Un proyecto de aficionado puede tolerar interrupciones ocasionales y quizá solo necesite algo más que un dominio de respaldo endpoint, mientras que un protocolo DeFi o una plataforma de intercambio que maneje valor real necesita una cobertura multirregional y con múltiples proveedores, con conmutación automática en caso de fallo. Toma la decisión sopesando el coste fijo y predecible de la redundancia frente al coste variable y potencialmente catastrófico de una interrupción del servicio. Se trata, fundamentalmente, de una decisión entre «construir» o «comprar», y solo sale a cuenta si puedes prever los fallos, así que combínala con una sólida observabilidad y supervisión de tu infraestructura.
Preguntas frecuentes
¿Qué es la redundancia de infraestructura?
La redundancia de la infraestructura consiste en utilizar más componentes de los estrictamente necesarios durante el funcionamiento normal, de modo que un sistema de respaldo pueda tomar el relevo en caso de que algo falle. En el caso de la cadena de bloques, esto se traduce en nodos duplicados en varias regiones, proveedores de servicios en la nube e implementaciones de clientes.
¿La redundancia es lo mismo que una copia de seguridad?
No del todo. Una copia de seguridad suele ser una copia de los datos que se restauran tras un fallo, mientras que la redundancia es una capacidad de reserva activa que sigue gestionando el tráfico durante un fallo con poca o ninguna interrupción. La redundancia tiene que ver con mantenerse en línea, no con recuperarse después.
¿Por qué utilizar varios clientes de nodo?
La diversidad de clientes protege contra los errores de software. Si aparece un error crítico en la implementación de un cliente, los nodos que ejecutan un cliente diferente siguen funcionando con normalidad, por lo que una sola versión con errores no deja fuera de servicio a toda tu flota.
¿La redundancia elimina por completo el tiempo de inactividad?
Ningún sistema alcanza un tiempo de actividad perfecto, pero la redundancia por capas convierte la mayoría de los fallos aislados en una disminución del rendimiento, en lugar de en interrupciones totales del servicio. El objetivo es eliminar los puntos únicos de fallo, de modo que ningún evento concreto provoque la interrupción total del servicio.
¿Merece la pena el coste adicional que supone la redundancia?
En el caso de las aplicaciones de producción, casi siempre. La redundancia conlleva un coste fijo y predecible, mientras que el tiempo de inactividad conlleva un coste variable que puede ascender a cientos de miles de dólares en operaciones no realizadas y usuarios perdidos durante una sola interrupción del servicio en hora punta.
Cómo « Quicknode » incorpora la redundancia en
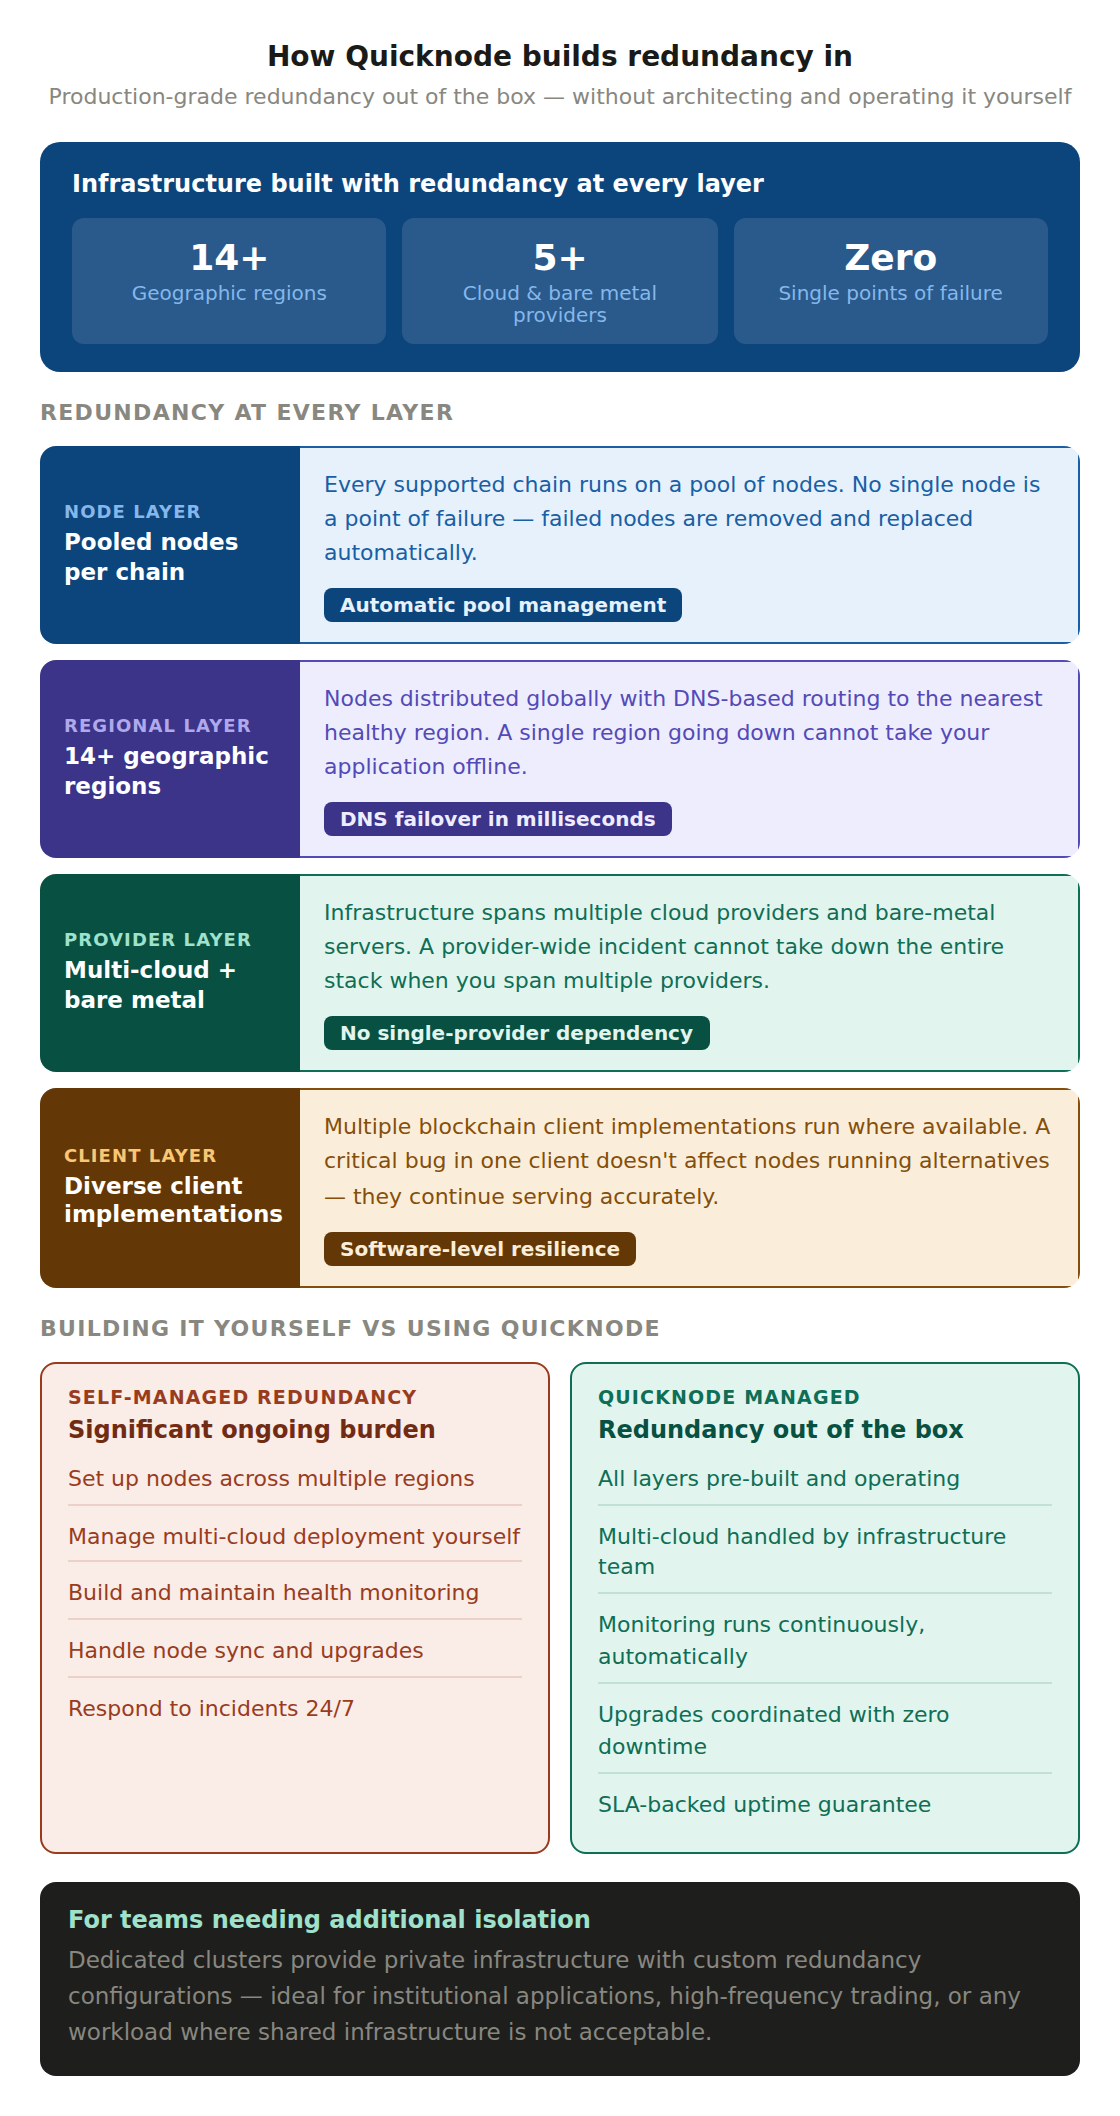
Quicknode gestiona una infraestructura de blockchain en más de 14 regiones a través de múltiples proveedores de servicios en la nube y de servidores físicos. Cada cadena compatible se ejecuta en un conjunto de nodos con diversas implementaciones de cliente, siempre que sea posible. El sistema está diseñado de tal forma que ningún nodo, región o proveedor de servicios en la nube constituya un punto único de fallo.
Esto significa que los desarrolladores disponen de redundancia de nivel de producción desde el primer momento, sin tener que diseñarla ni gestionarla ellos mismos. Para los equipos que necesiten un mayor aislamiento, Clústeres ofrecen infraestructura privada con configuraciones de redundancia personalizadas.