Respuestas>Descubre los fundamentos de la seguridad de la cadena de bloques>Modos de fallo habituales de la cadena de bloques
Modos de fallo habituales en las cadenas de bloques
// Tags
fallo de la cadena de bloquesataques a la cadena de bloques
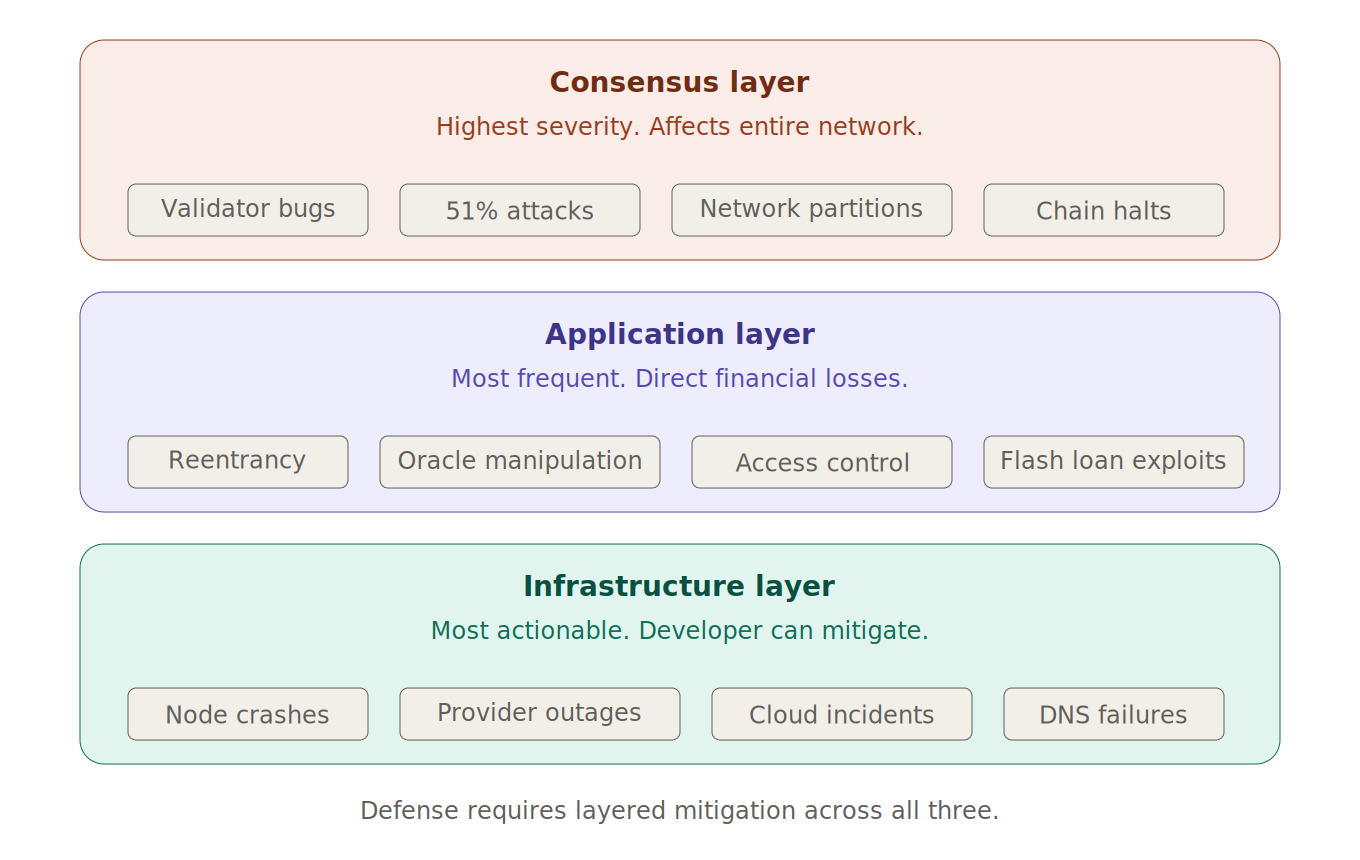
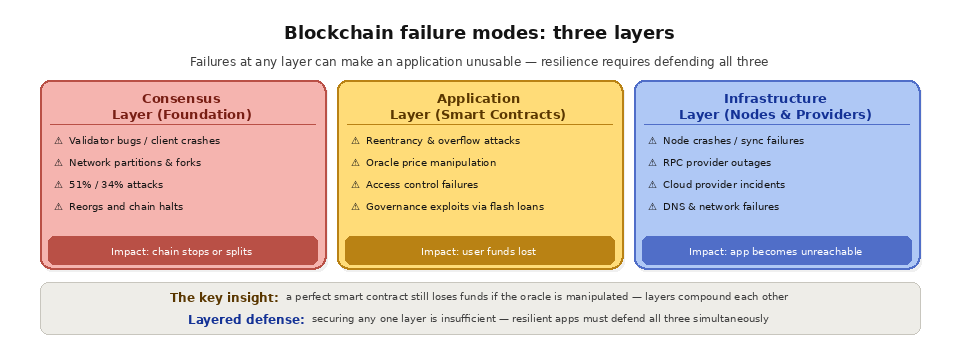
En resumen: Las cadenas de bloques fallan en tres capas. Los fallos en la capa de consenso incluyen errores en los validadores, particiones de red y ataques del 51 %. Los fallos en la capa de aplicación incluyen errores en los contratos inteligentes, manipulación de oráculos y vulnerabilidades en la gobernanza. Los fallos en la capa de infraestructura incluyen caídas de nodos, interrupciones en los proveedores e incidentes en la nube. Cada capa necesita sus propias defensas. Estos fallos son importantes porque las aplicaciones de cadena de bloques manejan dinero real, por lo que un fallo cuesta mucho más de lo que costaría en un software convencional.
La explicación sencilla
A menudo se dice que las cadenas de bloques son «sin necesidad de confianza» y « immutable ». Eso no significa que no puedan fallar. Al igual que cualquier sistema distribuido complejo, una cadena de bloques puede fallar de muchas formas y a muchos niveles.
Lo más importante para los desarrolladores es que los fallos se acumulan por capas. Un contrato inteligente seguro puede perder igualmente los fondos de los usuarios si alguien manipula el oráculo que le proporciona datos. Una aplicación bien programada puede dejar de funcionar si los nodos que la sustentan dejan de estar operativos.
Piensa en ello como si fuera un edificio. Los cimientos (capa de consenso) podrían agrietarse. Las tuberías y el cableado (capa de aplicación) podrían tener fugas o cortocircuitos. El administrador de la finca (capa de infraestructura) podría declararse en quiebra. Cada fallo requiere un tipo diferente de protección, y un sistema resiliente protege contra los tres a la vez.
Fallos en la capa de consenso
La capa de consenso es la base de toda cadena de bloques. Es el mecanismo mediante el cual los validadores acuerdan qué transacciones son válidas y qué bloques se incorporan a la cadena. Cuando falla el consenso, el daño es mayor que en cualquier otra capa: la cadena puede detenerse, reorganizarse o generar bloques contradictorios.
Los errores de los validadores son uno de los fallos de consenso más habituales. El software cliente de la cadena de bloques es complejo. Un error en la producción de bloques, en la lógica de certificación o en las transiciones de estado puede hacer que los validadores generen bloques no válidos, se cuelguen en mitad de una ronda o no se pongan de acuerdo sobre cuál es el estado correcto.
El riesgo aumenta cuando un único cliente domina la red. Si el 70 % de los validadores utilizan el mismo cliente y este presenta un error, el 70 % de la red deja de funcionar de golpe. Por eso la diversidad de clientes —es decir, la existencia de varias implementaciones independientes del mismo protocolo— es un tema tan recurrente en la seguridad de las cadenas de bloques.
Las particiones de red se producen cuando grupos de validadores dejan de poder comunicarse entre sí. Las causas más habituales son los cortes de Internet, los ataques DDoS selectivos y los fallos de enrutamiento.
Si ninguna de las partes de la escisión alcanza el umbral de consenso (normalmente dos tercios del peso apostado), se detiene la producción de bloques.
Si ambas partes siguen pudiendo alcanzar el umbral, la cadena se bifurca durante un tiempo y cada una genera sus propios bloques.
Cuando la red vuelve a conectarse, una reorganización resuelve la bifurcación. Las transacciones de la bifurcación más corta se revierten.
Los ataques del 51 % (o los ataques del 34 % en cadenas basadas en BFT) permiten a un atacante que cuente con el poder de consenso mayoritario reescribir el historial reciente. Así es como funciona:
El atacante crea una cadena privada que se separa de la pública.
La cadena privada recopila más pruebas de trabajo o certificaciones de validadores que la cadena pública.
El atacante lo difunde. Como tiene más peso, la red lo acepta y descarta los bloques recientes de la cadena pública.
Esto permite el doble gasto. El atacante envía fondos a la cadena pública y espera a que se confirme la transacción. A continuación, publica una cadena privada en la que se omite dicha transacción. De este modo, obtiene los bienes y se queda con los fondos.
Fallos en la capa de aplicación
La capa de aplicación abarca los contratos inteligentes, los protocolos DeFi, los oráculos y la lógica en cadena que gestiona miles de millones de dólares en fondos de los usuarios. Es aquí donde se producen la mayoría de los fallos y donde estos tienen un mayor coste.
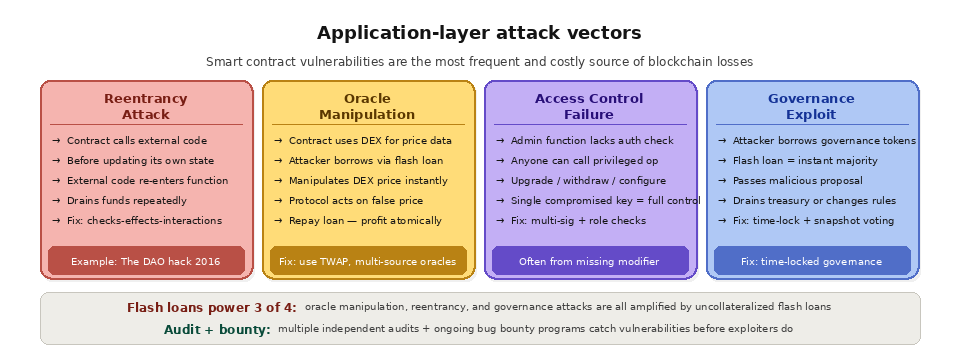
Los ataques de reentrada se dirigen contra un contrato que llama a otro contrato antes de actualizar su propio estado. El contrato al que se llama puede «reentrar» en el original y ejecutar de nuevo la misma función antes de que se aplique la actualización, lo que puede provocar la pérdida de fondos.
El ataque a la DAO de 2016 fue un ataque de reentrada. Provocó pérdidas por valor de unos 60 millones de dólares y dio lugar a la escisión entre Ethereum y Ethereum Classic. La vulnerabilidad se conoce desde hace años, pero sigue apareciendo en nuevos contratos que omiten el patrón «comprobaciones-efectos-interacciones».
El desbordamiento por exceso y por defecto de enteros se produce cuando una operación matemática genera un número que excede el rango que puede albergar su tipo de datos, por lo que el valor se reinicia. Una resta que debería dar un resultado negativo podría, en cambio, devolver un número positivo enorme, lo que permitiría a un atacante reclamar más tokens de los que posee. Solidity 0.8.0 incorporó comprobaciones integradas que revierten la operación en caso de desbordamiento. Los contratos creados con versiones anteriores, o que utilicen bloques matemáticos sin comprobar, siguen estando en riesgo.
Los fallos en el control de acceso se producen cuando las funciones de administración no comprueban quién las invoca. En ese caso, cualquiera puede ejecutar funciones destinadas exclusivamente al propietario del contrato o a un rol específico. Ejemplos habituales:
Funciones de actualización sin protección que permiten a cualquiera modificar la lógica del contrato
Funciones de retirada sin comprobación de titularidad
Acceso basado en roles configurado de forma incorrecta
La manipulación de los oráculos resulta especialmente peligrosa porque ataca el nexo entre los datos en cadena y fuera de cadena. Los contratos que utilizan oráculos de precios para préstamos, liquidaciones o derivados pueden verse engañados y actuar en función de un precio falso.
Los préstamos relámpago son la herramienta más habitual. En una única transacción atómica, el atacante:
Pide prestada una gran cantidad de tokens
Los utiliza para modificar el precio en un DEX que lee el oráculo
Activa una operación rentable en el protocolo de destino al precio ficticio
Paga el préstamo
El contrato en cuestión funcionó exactamente como estaba previsto. El fallo radicaba en el diseño del oráculo, que no tenía en cuenta las fluctuaciones de precios a corto plazo.
Las vulnerabilidades de gobernanza tienen como objetivo los sistemas de votación de las DAO y los protocolos DeFi. Un atacante consigue suficientes tokens de gobernanza, a menudo mediante un préstamo relámpago, para aprobar una propuesta maliciosa. Esa propuesta podría vaciar la tesorería, modificar la configuración del protocolo para crear una vulnerabilidad o otorgar al atacante el control de administrador.
Fallos en la capa de infraestructura
Los fallos en la infraestructura no afectan a la cadena de bloques en sí misma. Lo que impiden es que las aplicaciones y los usuarios puedan acceder a ella. Para un desarrollador o un usuario final, el resultado es el mismo que si se tratara de un fallo de la cadena: la aplicación deja de funcionar.
Los fallos del nodo y los errores de sincronización provocan que los nodos se desconecten o que proporcionen datos obsoletos. Un nodo que se queda varios bloques por detrás de la punta de la cadena muestra saldos antiguos, no registra las transacciones recientes y puede rechazar transacciones válidas que dependan del estado más reciente. Una aplicación que dependa de un único nodo sin conmutación por error dejará de funcionar cuando ese nodo deje de hacerlo.
Las interrupciones en el servicio de un proveedor afectan a todos sus clientes al mismo tiempo. Si un proveedor importante de RPC deja de funcionar, todas las aplicaciones que utilizan sus puntos de conexión pierden acceso a la cadena. Esto supone un riesgo de centralización dentro de un sistema que se supone descentralizado: cuando miles de aplicaciones comparten un mismo proveedor, ese proveedor se convierte en un único punto de fallo.
Las incidencias de los proveedores de servicios en la nube afectan a los nodos de blockchain igual que a cualquier otro servicio en la nube. Cuando AWS, GCP u otro proveedor de servicios en la nube sufre una interrupción regional, todos los nodos de esa región quedan fuera de servicio. Una gran parte de los nodos de blockchain se ejecutan en unos pocos proveedores de servicios en la nube, por lo que una interrupción en uno de ellos puede afectar al estado de la red y al tiempo de actividad de las aplicaciones mucho más de lo que cabría esperar.
Los fallos de DNS y de red pueden impedir que las aplicaciones se conecten a sus puntos finales RPC, incluso cuando estos funcionan correctamente. El secuestro de DNS, los problemas de enrutamiento BGP y los problemas con los certificados TLS pueden interrumpir la conexión entre una aplicación y su infraestructura.
Estrategias de mitigación
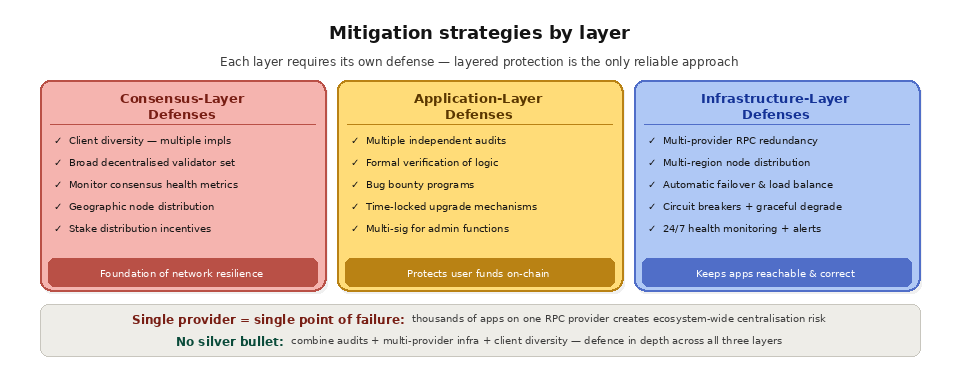
Para protegerse contra estos fallos es necesario adoptar un enfoque por capas que abarque los tres niveles.
En la capa de consenso, la diversidad de clientes es la defensa más eficaz. Al existir varias implementaciones de cliente, un error en una de ellas no provoca la caída de toda la red. La distribución de las participaciones también es importante: un conjunto de validadores amplio y descentralizado reduce el riesgo de fallos coordinados y de ataques del 51 %.
En la capa de aplicación, las principales medidas de defensa son las auditorías de seguridad, la verificación formal y los programas de recompensa por errores:
Encarga a varias empresas independientes que auditen los contratos inteligentes antes de su implementación.
Utiliza la verificación formal para demostrar matemáticamente que el código se ajusta a sus especificaciones. De este modo, se detectan errores que pueden pasar desapercibidos en una revisión manual.
Organiza programas de recompensa por errores en los que se pague a los hackers de «sombrero blanco» por detectar y comunicar de forma responsable las vulnerabilidades.
Las actualizaciones cuentan con un bloqueo temporal para que la comunidad pueda revisar los cambios antes de que entren en vigor. Esto evita que las actualizaciones maliciosas o con errores se publiquen de forma inmediata.
Exigir la aprobación mediante múltiples firmas para las funciones de administración, de modo que ninguna clave robada pueda por sí sola ejecutar operaciones con privilegios.
En el nivel de infraestructura, la redundancia entre proveedores, regiones y nubes es la base. Nunca dependas de un único proveedor de RPC, centro de datos o nube.
Los disyuntores desconectan los componentes defectuosos antes de que provoquen la caída de los sistemas que dependen de ellos.
La degradación elegante garantiza que las funciones principales, como la visualización de saldos, sigan funcionando aunque algunos componentes no estén operativos.
Cómo « Quicknode » fomenta la resiliencia
QuicknodeLa infraestructura está diseñada para absorber los fallos que se produzcan en la capa de infraestructura:
Distribución geográfica en más de 14 regiones y más de 5 proveedores de servicios en la nube y de servidores físicos
Diversidad de clientes, cuando sea posible
Conmutación automática por error que desvía las solicitudes de los nodos que no funcionan correctamente
Supervisión las 24 horas del día, los 7 días de la semana, a cargo de un equipo especializado en operaciones de blockchain equipe
Quicknode Streams Aumenta la resiliencia de los flujos de datos gracias a la entrega garantizada, el procesamiento en orden de finalidad y la gestión automática de las reorganizaciones. Cuando se produce una reorganización, Streams detecta y corrige por sí mismo los datos afectados. En cuanto a la supervisión en la capa de aplicación, Streams te permite vigilar eventos específicos de los contratos, patrones de transacciones inusuales y cambios de estado que podrían indicar que se está produciendo un ataque.
Para los equipos con las necesidades de disponibilidad más exigentes, Quicknode Dedicated Clústeres de xml-ph-0000@deepl.internal ofrecen una infraestructura aislada con acuerdos de nivel de servicio (SLA) de disponibilidad garantizada, independiente del tráfico compartido. Los picos de tráfico de otros clientes no pueden ralentizar tu servicio, lo que proporciona a las aplicaciones críticas el aislamiento que necesitan.
¿Cuáles son los tipos más habituales de fallos en las cadenas de bloques?
Las fallas mencionadas anteriormente se agrupan según la capa en la que se originan. La capa también indica quién es el responsable de la defensa frente a cada una de ellas. En la tabla siguiente se enumeran las fallas más comunes, un ejemplo de cada una y dónde se encuentra la solución.
Capa
Fallo habitual
Ejemplo
Donde reside la mitigación
Consenso
Ataque del 51 % o reorganización
La mayoría reescribe la historia reciente
Protocolo y conjunto de validadores
Consenso
Partición de red o parada
Los validadores no pueden alcanzar el umbral
Protocolo y diversidad de clientes
Solicitud
Reentrancia o manipulación del oráculo
Un préstamo flash agota un fondo de crédito
Contratos inteligentes y auditorías
Solicitud
Vulnerabilidad relacionada con el control de acceso o la gobernanza
Función de administrador sin protección
Contratos inteligentes y firmas múltiples
Infraestructura
Fallo del nodo o interrupción del servicio del proveedor
La llamada RPC « endpoint » devuelve datos obsoletos
Infraestructura redundante
¿Cómo se detectan los fallos en la cadena de bloques antes de que provoquen pérdidas?
La detección marca la diferencia entre un incidente controlado y una catástrofe. La supervisión continua de la infraestructura de la cadena de bloques muestra en tiempo real el retraso de los nodos, los picos de errores y las asincronías. Una observabilidad más amplia vincula esas señales con el comportamiento de las aplicaciones, lo que permite detectar un ataque o una interrupción del servicio antes de que los usuarios lo noten.
¿Cuál es la diferencia entre una interrupción de la cadena y una reorganización de la cadena?
Es fácil confundir estos dos tipos de fallos de consenso. Una interrupción de la cadena detiene por completo la producción de bloques porque los validadores no pueden alcanzar el umbral de consenso, por lo que no se confirman nuevas transacciones. Una reorganización de la cadena de bloques sigue produciendo bloques, pero sustituye los más recientes por los de una cadena rival. Esto puede revertir transacciones que parecían confirmadas.
¿Cómo reduce la redundancia de la infraestructura el riesgo de fallos?
La mayoría de las interrupciones en la infraestructura se deben a un único punto de fallo. Una vez que se comprende por qué es importante la redundancia de la infraestructura, el diseño surge de forma natural: múltiples proveedores y regiones, además de una conmutación automática por error que desvía el tráfico alrededor de un nodo defectuoso antes de que las solicitudes empiecen a fallar.
Preguntas frecuentes
¿Cuáles son las tres capas de fallo de la cadena de bloques?
Los fallos se originan en la capa de consenso (errores de los validadores, particiones, ataques del 51 %), en la capa de aplicación (errores en los contratos inteligentes, manipulación de oráculos, vulnerabilidades en la gobernanza) o en la capa de infraestructura (fallos de los nodos, interrupciones en los proveedores y en la nube). Los sistemas resilientes se protegen contra los tres.
¿Cuál es la causa más habitual de las pérdidas en las cadenas de bloques?
Los fallos en la capa de aplicación, especialmente las vulnerabilidades de los contratos inteligentes y la manipulación de los oráculos, son los más frecuentes y los más costosos. La cadena subyacente suele funcionar exactamente según lo previsto, mientras que se aprovecha la lógica defectuosa del contrato o del oráculo.
¿Puede una sola interrupción en el servicio de un proveedor de RPC provocar que mi aplicación deje de funcionar?
Sí. Si tu aplicación depende de un único proveedor, un único centro de datos o una única región en la nube, cualquier interrupción en cualquiera de ellos te dejará sin conexión. Distribuir el tráfico entre proveedores y regiones redundantes con conmutación automática en caso de fallo elimina ese punto único de fallo.
¿Es lo mismo un ataque del 51 % que una partición de red?
No. Un «ataque del 51 %» es un intento deliberado por parte de la mayoría del poder de consenso de reescribir la historia, mientras que una partición de la red es una pérdida accidental de comunicación entre los validadores. Ambos pueden provocar reorganizaciones, pero sus causas y sus defensas son diferentes.
¿Cómo se puede evitar la manipulación de los oráculos?
Utiliza oráculos que agreguen precios de distintas fuentes y a lo largo del tiempo, evita basarte en un único precio al contado de un DEX e incorpora comprobaciones de validez y mecanismos de corte automático. Estas medidas mitigan los ataques de préstamos relámpago que distorsionan momentáneamente una fuente de precios.