Respuestas>Descubre los fundamentos de la seguridad de la cadena de bloques>¿Qué es una interrupción de la cadena?
¿Qué es una parada en cadena?
// Tags
parada de la cadenaparada de la cadena de bloques
En resumen: Se produce una interrupción de la cadena cuando una cadena de bloques deja de generar bloques por completo. A diferencia de la congestión, en la que la red se ralentiza pero sigue funcionando, una interrupción de la cadena significa que no se confirma ninguna transacción nueva y que la red queda, a efectos prácticos, paralizada. Las paradas de cadena se deben a fallos en el consenso, errores críticos en los clientes, ataques DDoS contra los validadores, agotamiento de recursos o actualizaciones fallidas. Se encuentran entre los incidentes más graves que puede sufrir una cadena de bloques, ya que todas las aplicaciones, carteras y protocolos construidos sobre esa cadena quedan inutilizables hasta que la red se restablezca. La recuperación requiere una acción coordinada por parte de todo el conjunto de validadores, lo que suele implicar identificar la causa raíz, implementar un parche y reiniciar el consenso.
La explicación sencilla
Una interrupción de la cadena es el equivalente en una cadena de bloques a una caída total del servidor. Cuando el servidor de una aplicación web tradicional deja de funcionar, nadie puede acceder al servicio. Cuando se interrumpe una cadena de bloques, nadie puede enviar transacciones, reclamar rendimientos, cerrar posiciones ni interactuar con ningún contrato inteligente de la red. La cadena, sencillamente, deja de avanzar.
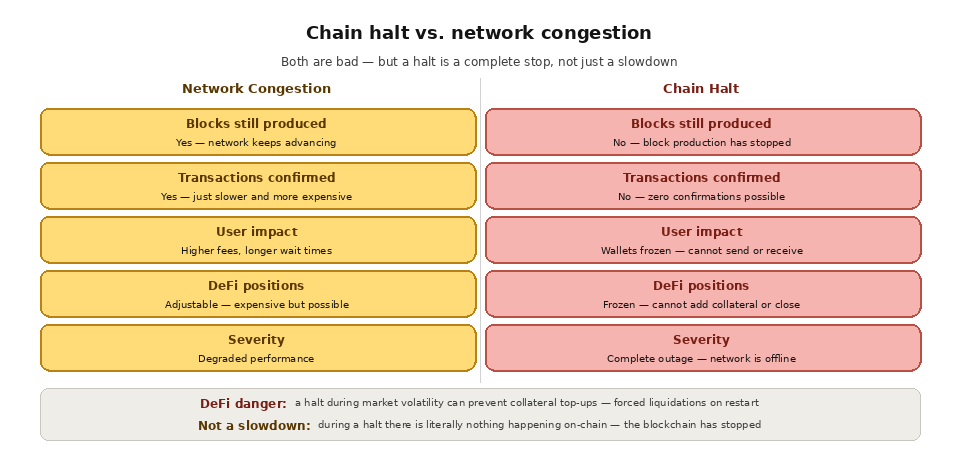
Es importante distinguir entre congestión y paralización. Durante la congestión, se siguen generando bloques y se siguen confirmando transacciones, aunque a un ritmo más lento y con un coste mayor. Los usuarios compiten por un espacio limitado en los bloques, pero la red sigue funcionando. Durante una paralización de la cadena, no se genera ningún bloque. La red se ha detenido. Las transacciones permanecen en el mempool sin posibilidad de confirmación hasta que la cadena se reanude.
Para los usuarios finales, una interrupción de la cadena significa que los monederos muestran los saldos, pero no pueden enviar ni recibir fondos. Las posiciones de DeFi no se pueden ajustar, lo cual resulta especialmente peligroso en condiciones de volatilidad del mercado, cuando los usuarios podrían necesitar añadir garantías o cerrar posiciones apalancadas. Las subastas de NFT se congelan en mitad de la puja. Los puentes dejan de procesar transferencias. Todas las aplicaciones creadas en la cadena quedan, a efectos prácticos, fuera de línea.
Causas habituales de las paradas en cadena
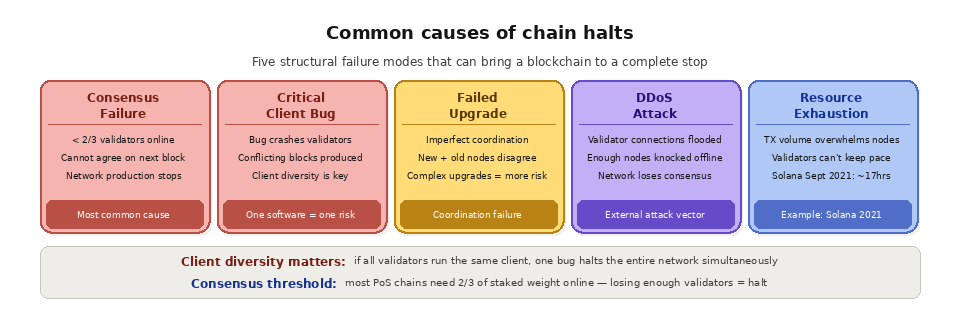
Los fallos de consenso son la causa más frecuente de las interrupciones en la cadena. Una cadena de bloques genera nuevos bloques a través de su mecanismo de consenso, que requiere un umbral mínimo de validadores que estén de acuerdo en el siguiente bloque. En muchas cadenas de «Proof of Stake», este umbral es de dos tercios del peso de los validadores que han apostado sus tokens. Si un número suficiente de validadores se desconecta, sufre un fallo o no puede comunicarse entre sí, la red no puede alcanzar el consenso y la producción de bloques se detiene.
Los errores críticos en los clientes pueden paralizar una cadena si provocan que los validadores se cuelguen, generen bloques no válidos o discrepen sobre el estado correcto. Si un error en la implementación del cliente dominante hace que la mayoría de los validadores generen bloques contradictorios, la red puede entrar en un estado en el que ningún bloque reciba suficientes atestaciones para ser finalizado. Este escenario pone de relieve la importancia de la diversidad de clientes: si todos los validadores ejecutan el mismo software, un solo error afecta a toda la red de forma simultánea.
Las actualizaciones fallidas son otro factor desencadenante habitual. Las actualizaciones de la red exigen que los validadores actualicen su software antes de un bloque o un momento concretos. Si la actualización presenta un error, o si la coordinación no es perfecta y algunos validadores actualizan mientras que otros no, la cadena puede dividirse o quedarse estancada. El riesgo aumenta con la complejidad de la actualización y el número de cambios que se implementan simultáneamente.
Los ataques DDoS dirigidos contra los validadores pueden saturar sus conexiones de red o su capacidad de procesamiento, lo que les impide participar en el consenso. Si un ataque coordinado deja fuera de servicio a un número suficiente de validadores, la cadena se detiene hasta que el ataque remita o los validadores pongan en marcha contramedidas.
El agotamiento de recursos se produce cuando el volumen de transacciones o la complejidad de los contratos inteligentes supera la capacidad de procesamiento de la red hasta el punto de que los validadores no pueden seguir el ritmo. Solana lo sufrió en septiembre de 2021, cuando una avalancha de actividad de bots desbordó la capacidad de procesamiento de los validadores, lo que acabó provocando que la red se paralizara durante aproximadamente 17 horas.
El proceso de recuperación
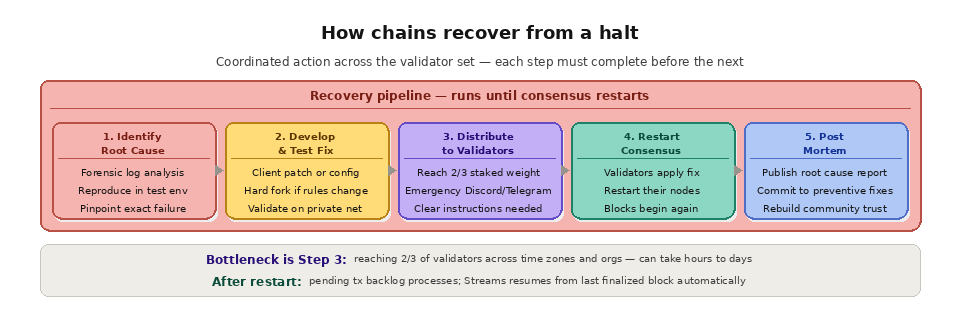
La recuperación tras una interrupción de la cadena sigue un patrón general, aunque los detalles varían en función de la cadena y de la causa de la interrupción.
En primer lugar, el equipo de ingeniería equipe identifica la causa raíz. Esto suele requerir un análisis forense de los registros de los validadores, el estado del consenso y las condiciones de la red en el momento de la interrupción. En el caso de los errores, es esencial reproducir el problema en un entorno de pruebas antes de poder implementar una corrección.
En segundo lugar, se desarrolla y se prueba una solución. Dependiendo de la gravedad y la naturaleza del error, esto puede llevar horas o días. La solución puede consistir en un parche de software para el cliente, un cambio de configuración o, en casos extremos, un «hard fork» que modifique las reglas de consenso.
En tercer lugar, la solución se distribuye entre los validadores. Este es el reto de coordinación. Los validadores son operadores independientes repartidos por diferentes zonas horarias y organizaciones. Para llegar a un número suficiente de validadores que permita reiniciar el consenso (normalmente dos tercios del peso apostado) se necesitan canales de comunicación, instrucciones claras y paciencia. La mayoría de las cadenas cuentan con canales de comunicación de emergencia (Discord, Telegram o sistemas de alerta específicos) precisamente para este fin.
En cuarto lugar, se reinicia el consenso. Los validadores aplican la corrección, reinician sus nodos y vuelven a producir y certificar bloques. La cadena se reanuda a partir del último bloque finalizado y se empieza a procesar la cola de transacciones pendientes.
En quinto lugar, se lleva a cabo un análisis a posteriori. El equipo de ingeniería equipe publica un análisis detallado de qué falló, por qué ocurrió, qué medidas se tomaron para solucionarlo y qué cambios se implementarán para evitar que vuelva a suceder. Estos análisis a posteriori son esenciales para mantener la confianza de la comunidad y para mejorar la resiliencia de la red.
¿Cuál es la diferencia entre una interrupción en cadena y la congestión de la red?
A menudo se confunden estos dos modos de fallo, pero su gravedad es muy diferente. La congestión significa que la red está sobrecargada, pero sigue produciendo bloques, mientras que una paralización significa que la producción de bloques se ha detenido por completo. En la tabla siguiente se comparan ambos casos.
Aspecto
Congestión de la red
Parada en cadena
Producción en bloque
Sigue igual, pero más despacio
Se detiene por completo
Transacciones
Se ha confirmado que las tarifas serán más elevadas
¿Qué ocurre con mis transacciones durante una interrupción de la cadena?
Las transacciones pendientes permanecen sin confirmar en el mempool porque ningún validador puede incluirlas en un bloque. No se pierden: una vez que la cadena se reanuda, se procesa el volumen de transacciones acumuladas, aunque algunas pueden caducar o tener que volver a enviarse con parámetros actualizados. Dado que no se generan nuevos bloques, ninguna transacción alcanza la finalidad durante la interrupción, por lo que los saldos parecen estáticos aunque una transacción aparezca como pendiente.
Cuando la red se reinicia, los validadores convergen en el último estado canónico, lo que puede implicar una breve reorganización a medida que se resuelven los bloques en conflicto. Las aplicaciones deben actuar con cautela durante el periodo inmediatamente posterior al reinicio y esperar a que se alcance la finalidad antes de procesar las transacciones recién confirmadas.
¿Cuánto duran las paradas en cadena?
Las interrupciones de la cadena han durado desde menos de una hora hasta casi todo un día, dependiendo de la causa y de la rapidez con la que los validadores puedan coordinar una solución. En la tabla siguiente se enumeran varias interrupciones de las que se ha informado ampliamente. Las duraciones son aproximadas y se basan en análisis posteriores públicos.
Red
Cuando
Duración aproximada
Causa declarada
Solana
Septiembre de 2021
Unas 17 horas
Agotamiento de recursos provocado por bots
Solana
Febrero de 2024
Unas 5 horas
Error en un cargador heredado
BNB Smart Chain
Octubre de 2022
Unas 8 horas
Pausa del validador tras un ataque a un puente
Arbitrum
Enero de 2024
Entre 1 y 2 horas aproximadamente
Interrupción del funcionamiento del secuenciador
Las interrupciones provocadas por un error claro y reproducible suelen resolverse más rápido que aquellas que requieren un análisis forense exhaustivo. Las redes que cuentan con una sólida planificación de la gestión de fallos (mode ) y con procedimientos de reinicio ensayados se recuperan más rápidamente.
¿Cómo pueden los desarrolladores proteger las aplicaciones frente a las interrupciones en la cadena?
No se puede evitar una interrupción en cadena, pero sí se pueden diseñar aplicaciones que se adapten de forma fluida a las situaciones adversas y se recuperen sin problemas. La base es diseñar con vistas a una alta disponibilidad. La tabla siguiente resume las medidas de protección más eficaces.
Práctica
Para qué sirve
Beneficio
Degradación controlada
Mostrar el estado de la caché y las escrituras en la cola
Los usuarios mantienen una interfaz de usuario operativa
Compatibilidad con múltiples cadenas
Dirigir la actividad a una cadena activa
Reduce la dependencia de una sola cadena
Seguimiento de la salud
Seguimiento de la evolución de la altura de los bloques de vía
Detecta una parada en cuestión de segundos
Redundancia de proveedores
Conmutación por error entre puntos finales
Resiste los problemas relacionados con los nodos y los proveedores
La conmutación automática por error mantiene la ruta de lectura en buen estado cuando un nodo o un proveedor presenta un problema, mientras que Quicknode Streams resincroniza automáticamente tu canal de datos en cuanto se reanuda la producción de bloques.
Preguntas frecuentes
¿Es lo mismo que se produzca una interrupción en la cadena que una caída de la cadena de bloques?
En efecto, sí. Una paralización de la cadena significa que la red ha dejado de generar bloques, por lo que no se confirma ninguna transacción y todas las aplicaciones de esa cadena quedan inutilizables hasta que los validadores restablezcan el consenso. Los datos permanecen intactos, pero la red queda paralizada.
¿Se puede perder dinero durante una interrupción de la cadena?
Los fondos que se encuentran en la cadena no se pierden, pero puedes sufrir pérdidas indirectas, especialmente en el ámbito de las finanzas descentralizadas (DeFi). Si no puedes aportar más garantía o cerrar una posición apalancada durante una interrupción del servicio, podrías enfrentarte a una liquidación o a una cotización desfavorable en el momento en que la cadena se restablezca y se actualicen los precios.
¿Qué cadenas de bloques han sufrido interrupciones en su funcionamiento?
Varias redes de alto rendimiento se han detenido al menos una vez, entre ellas Solana, BNB Smart Chain, Polygon y algunos rollups de capa 2 debido a interrupciones en el secuenciador. Las interrupciones son más habituales en cadenas más nuevas o altamente optimizadas que llevan al límite el rendimiento.
¿Cómo se repara un eslabón roto?
Los ingenieros identifican la causa raíz, desarrollan y prueban una solución, la distribuyen a los validadores y coordinan un reinicio una vez que se ha recuperado en línea suficiente peso de staking. A continuación, la cadena se reanuda a partir del último bloque finalizado y procesa el trabajo acumulado.
¿Una interrupción en la cadena provoca una reorganización?
Sí, es posible. Cuando los validadores se reinician, deben converger en una única cadena canónica, lo que a veces implica descartar bloques contradictorios generados near la interrupción. Esperar a que se alcance la finalidad tras un reinicio protege a tu aplicación de actuar sobre datos que puedan quedar excluidos tras una reorganización.
Cómo gestiona « Quicknode » las interrupciones en cadena
QuicknodeLa infraestructura de equipe supervisa el estado y la producción de bloques de todas las cadenas compatibles las 24 horas del día, los 7 días de la semana. Cuando se produce una interrupción en una cadena, los sistemas de Quicknode la detectan de inmediato y comunican las actualizaciones de estado a los clientes afectados. La infraestructura de supervisión realiza un seguimiento de la progresión de la altura de los bloques, las tasas de participación de los validadores y los indicadores de estado del consenso, lo que permite alertar con antelación de posibles interrupciones antes de que afecten a la producción de bloques.
Durante una interrupción de la cadena, los puntos finales RPC de Quicknode siguen proporcionando datos históricos y respondiendo a las solicitudes de lectura basadas en el último estado confirmado. Las operaciones de escritura (envíos de transacciones) fallarán naturalmente o se pondrán en cola hasta que se reanude la cadena, pero las aplicaciones aún pueden consultar saldos, el estado de los contratos y los datos históricos anteriores a la interrupción. Cuando la cadena se reanuda, Quicknode Streams retoma automáticamente a partir del último bloque procesado y entrega cualquier bloque nuevo generado durante y después de la recuperación, lo que garantiza que tu canal de datos permanezca sincronizado con la cadena canónica sin necesidad de intervención manual. La gestión integrada de reorganizaciones en Streams resulta especialmente valiosa durante los reinicios de la cadena, que pueden implicar bifurcaciones temporales mientras los validadores convergen en el estado correcto de la cadena.