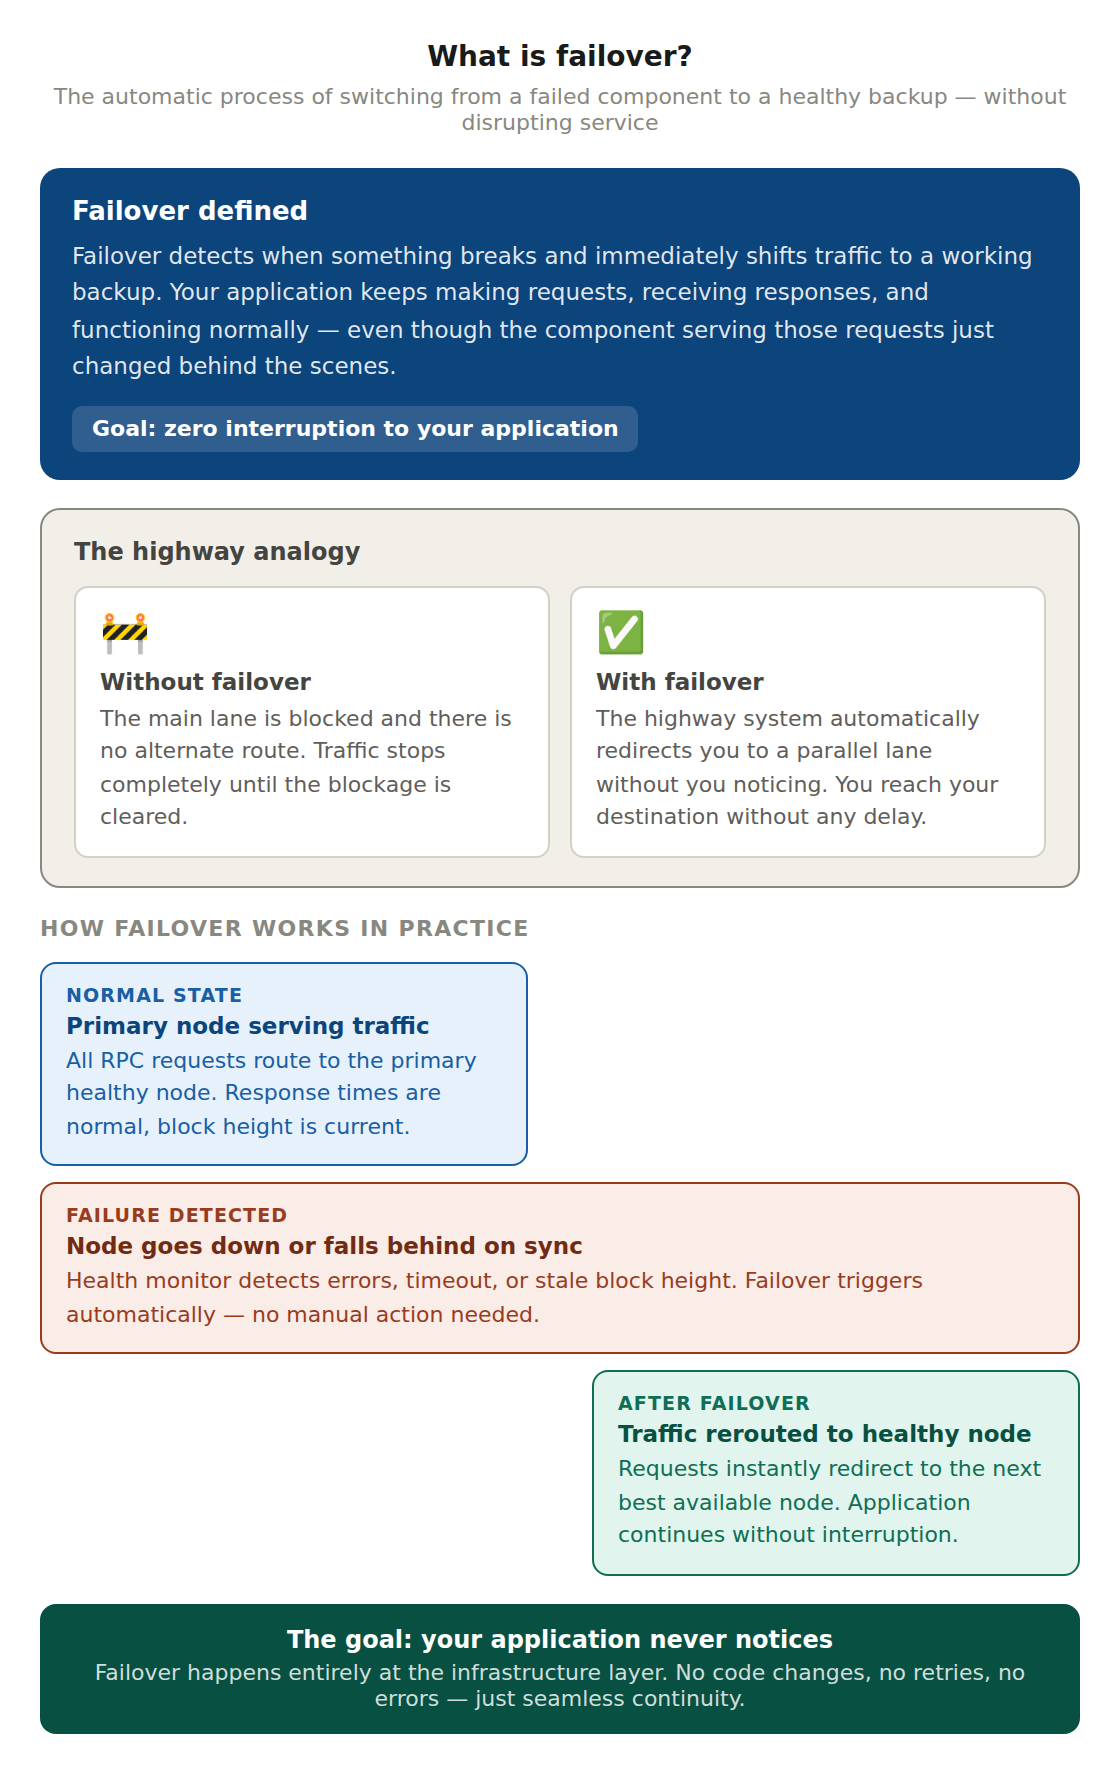
En resumen: La conmutación por error es el proceso automático de pasar de un componente averiado a una copia de seguridad en buen estado sin interrumpir el servicio. En la infraestructura de blockchain, la conmutación por error garantiza que, cuando un nodo, un servidor o un centro de datos deja de funcionar, las solicitudes RPC de tu aplicación se redirijan sin problemas a otro endpoint en funcionamiento.
El concepto básico
Imagina que vas conduciendo por una autopista y, de repente, el carril principal queda bloqueado. Si no hay ninguna ruta alternativa, te quedas atascado. Pero si el sistema de autopistas te desvía automáticamente a un carril paralelo sin que te des cuenta, eso es la conmutación por error en acción.
En términos de infraestructura, la conmutación por error es el mecanismo que detecta cuándo se produce un fallo y desvía inmediatamente el tráfico hacia un sistema de respaldo. El objetivo es lograr una interrupción nula (o « near » nula). Tu aplicación sigue realizando solicitudes, recibiendo respuestas y funcionando con normalidad, aunque el componente que atiende esas solicitudes acabe de cambiar entre bastidores.
Cómo funciona la conmutación por error en la infraestructura de blockchain
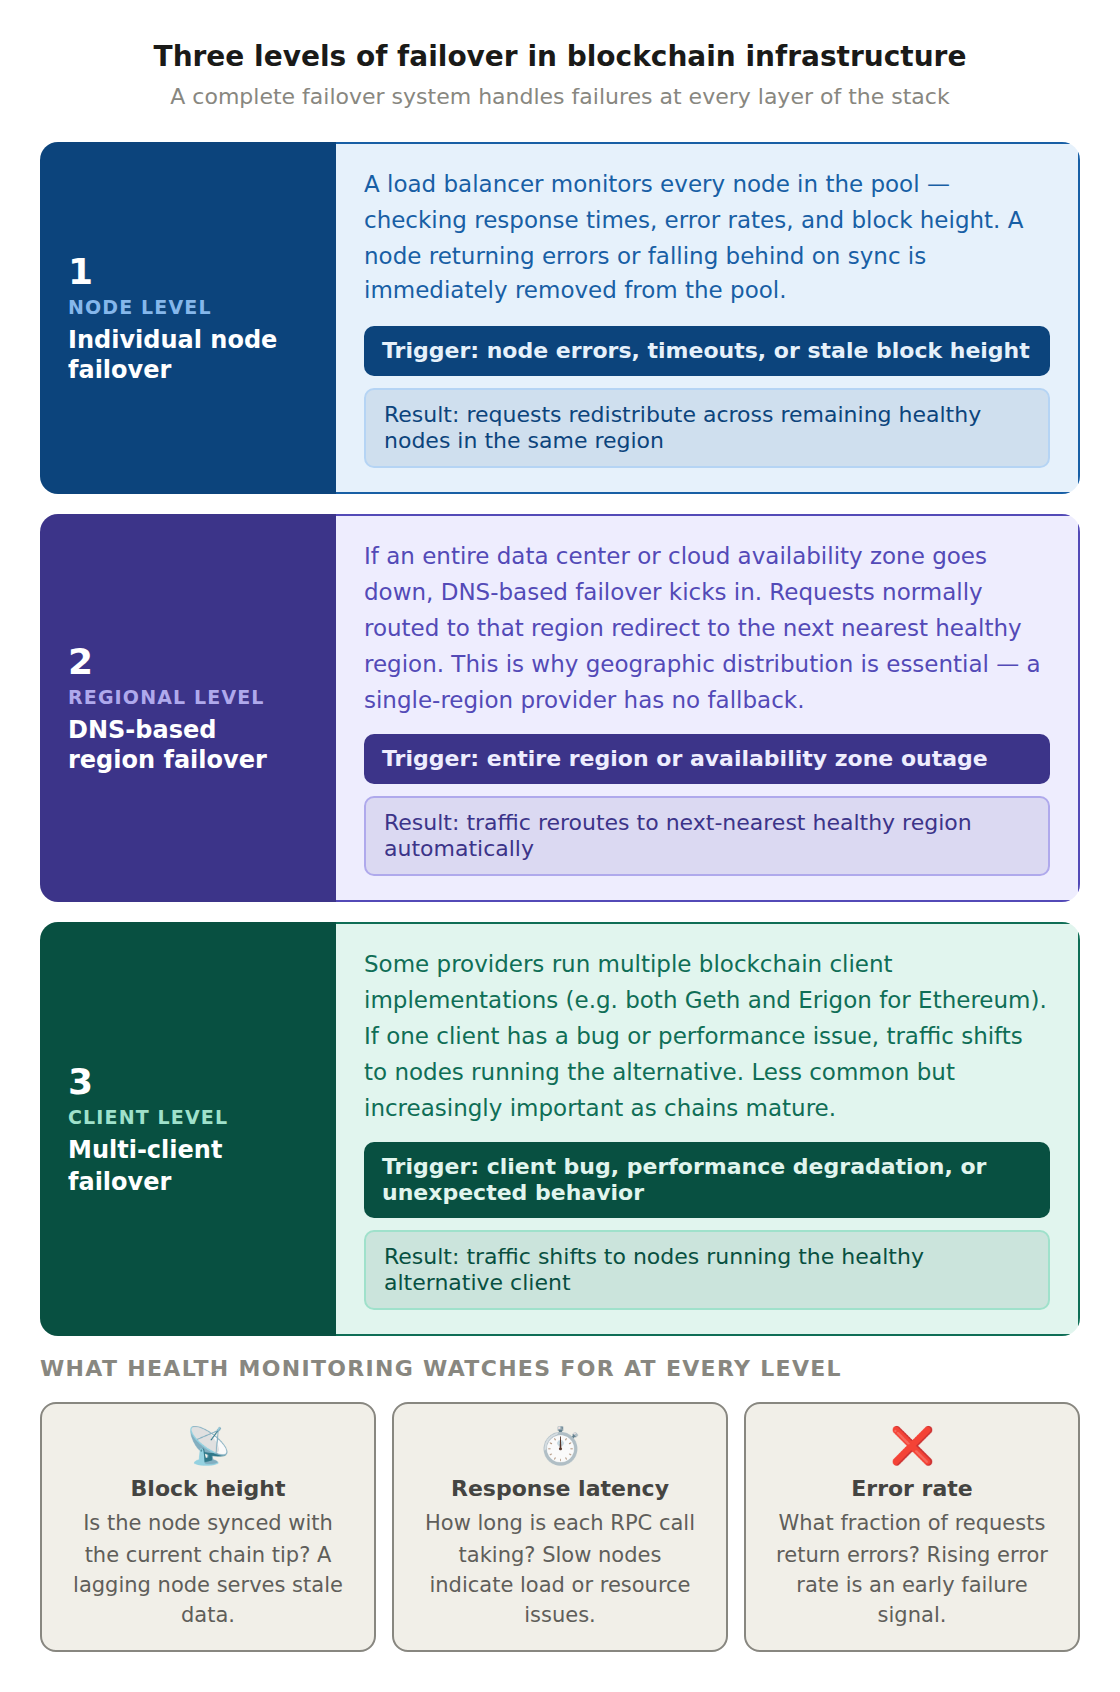
La infraestructura de blockchain cuenta con un conjunto específico de componentes que pueden fallar. Los más habituales son los nodos individuales, regiones enteras o centros de datos, y determinadas implementaciones de clientes de blockchain. Un buen sistema de conmutación por error gestiona estos tres aspectos.
A nivel de nodo, la conmutación por error es relativamente sencilla. Un equilibrador de carga supervisa continuamente el estado de cada nodo del grupo, comprobando los tiempos de respuesta, las tasas de error y la altura del bloque. Si un nodo empieza a devolver errores o se queda rezagado en la sincronización, el equilibrador de carga deja de enviarle tráfico y distribuye las solicitudes entre los nodos restantes que se encuentran en buen estado.
A nivel regional, la cosa se pone más interesante. Si se produce una interrupción en todo un centro de datos o en una zona de disponibilidad en la nube, se activa la conmutación por error basada en el DNS. Las solicitudes que normalmente se enrutarían a esa región se redirigen automáticamente a la región operativa más cercana. Por eso es importante la distribución geográfica. Un proveedor que solo tenga nodos en una región no dispone de una solución alternativa cuando esa región deja de funcionar.
A nivel de cliente, algunos proveedores ejecutan varias implementaciones de clientes de cadena de bloques (por ejemplo, tanto Geth como Erigon para Ethereum). Si una implementación de cliente presenta un error o un problema de rendimiento, el tráfico puede desviarse hacia los nodos que ejecutan el cliente alternativo. Esta capa de redundancia es menos habitual, pero cada vez más importante.
Conmutación por error activa frente a pasiva
Existen dos enfoques generales para la conmutación por error, y esta distinción es importante para el rendimiento.
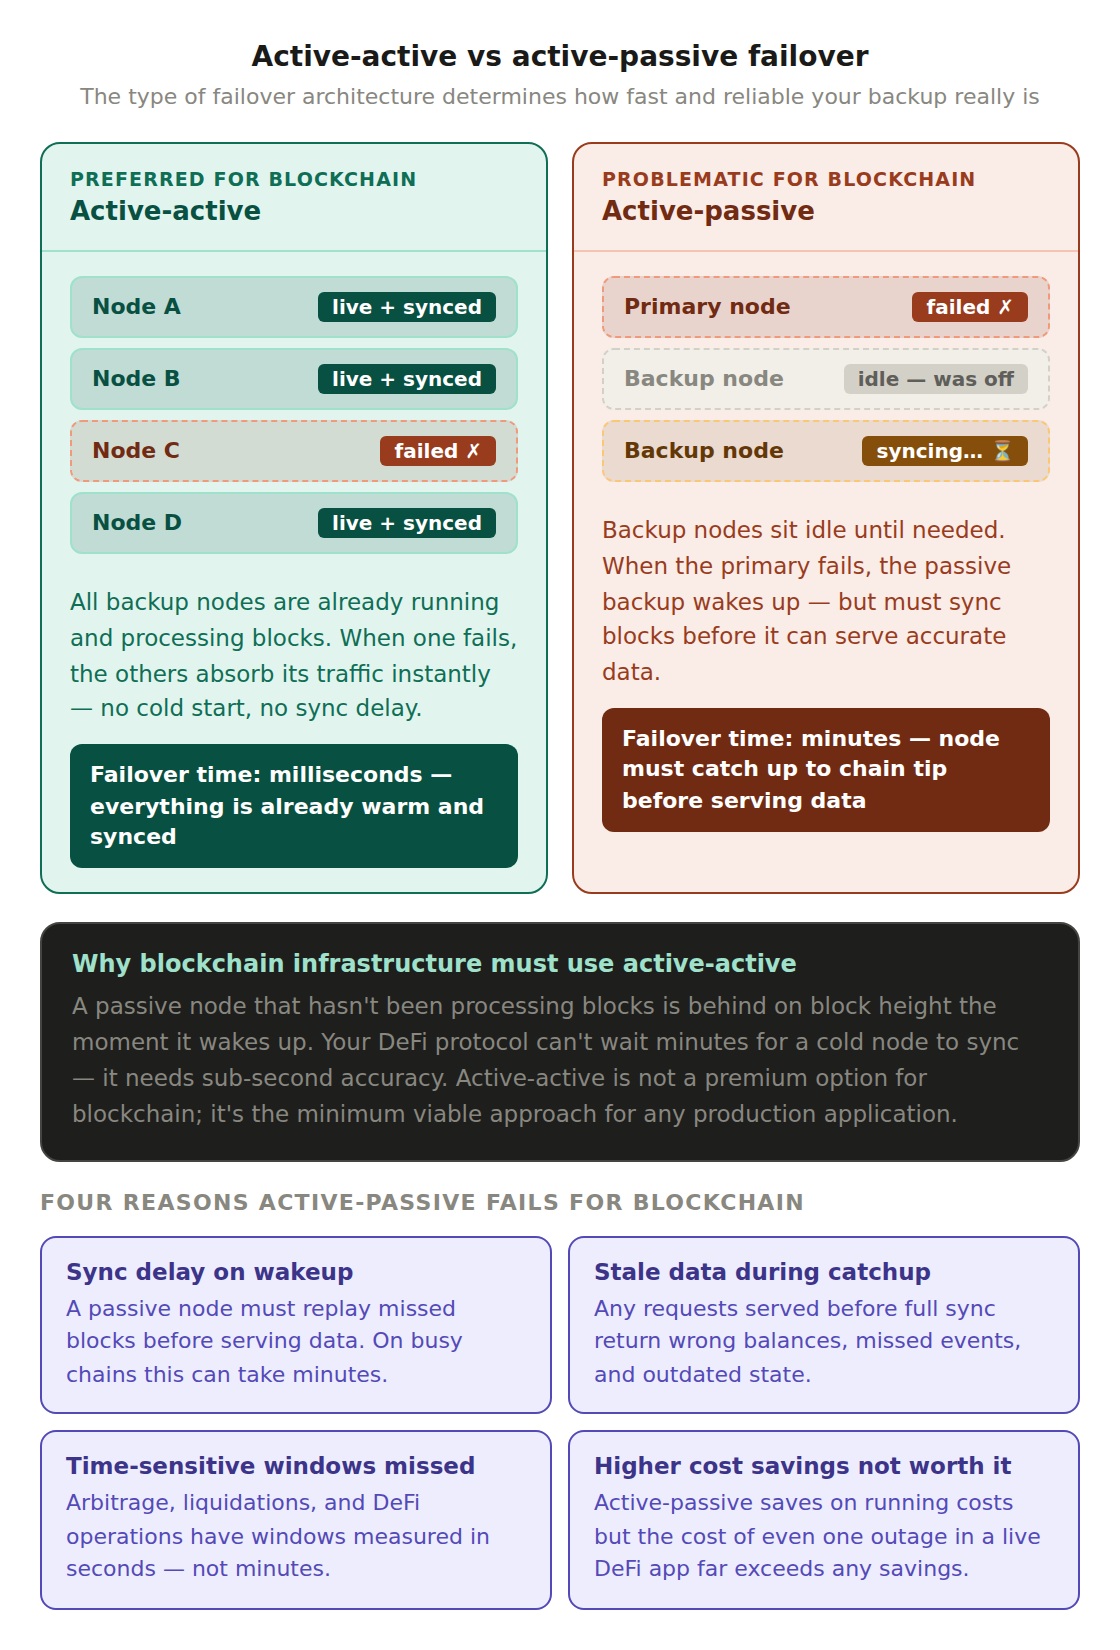
En las configuraciones «activo-activo», todos los componentes de respaldo ya están en funcionamiento y gestionando el tráfico. Cuando uno falla, los demás simplemente absorben su parte de la carga. No hay retraso por «arranque en frío», ya que todo está ya en funcionamiento. Este es el modelo preferido para la infraestructura de blockchain, ya que los nodos deben mantenerse sincronizados con la cadena. Un nodo que no esté procesando bloques de forma activa se quedará rezagado en cuanto a la altura del bloque y será inútil hasta que se ponga al día.
En las configuraciones activas-pasivas, los componentes de respaldo permanecen inactivos hasta que se necesitan. Cuando el nodo principal falla, el nodo pasivo de respaldo se activa y toma el relevo. Este sistema resulta más económico, pero conlleva un retraso. En el caso de los nodos de cadena de bloques, este retraso puede ser significativo, ya que es posible que el nodo pasivo tenga que sincronizar los bloques antes de poder proporcionar datos precisos.
La mayor parte de la infraestructura de blockchain en producción utiliza la conmutación por error «activo-activo» precisamente por este motivo. No te puedes permitir esperar a que un nodo «en frío» se ponga al día cuando tu protocolo DeFi necesita una precisión de datos inferior a un segundo.
La siguiente tabla resume las diferencias entre los dos modelos de conmutación por error para cargas de trabajo de cadena de bloques:
Aspecto | Activo-Activo | Activo-pasivo |
|---|---|---|
Estado de la copia de seguridad | Todos los nodos están en funcionamiento y gestionan el tráfico | Los nodos en espera permanecen inactivos hasta que se les necesita |
Retraso en la conmutación por error | Near cero, sin arranque en frío | Cabe destacar que la copia de seguridad debe iniciarse y sincronizarse. |
Costes de explotación | Cuanto mayor sea, más pagas por la capacidad total | Cuanto menor sea, menos recursos consume en modo de espera |
Por qué la conmutación por error es imprescindible para las aplicaciones de blockchain
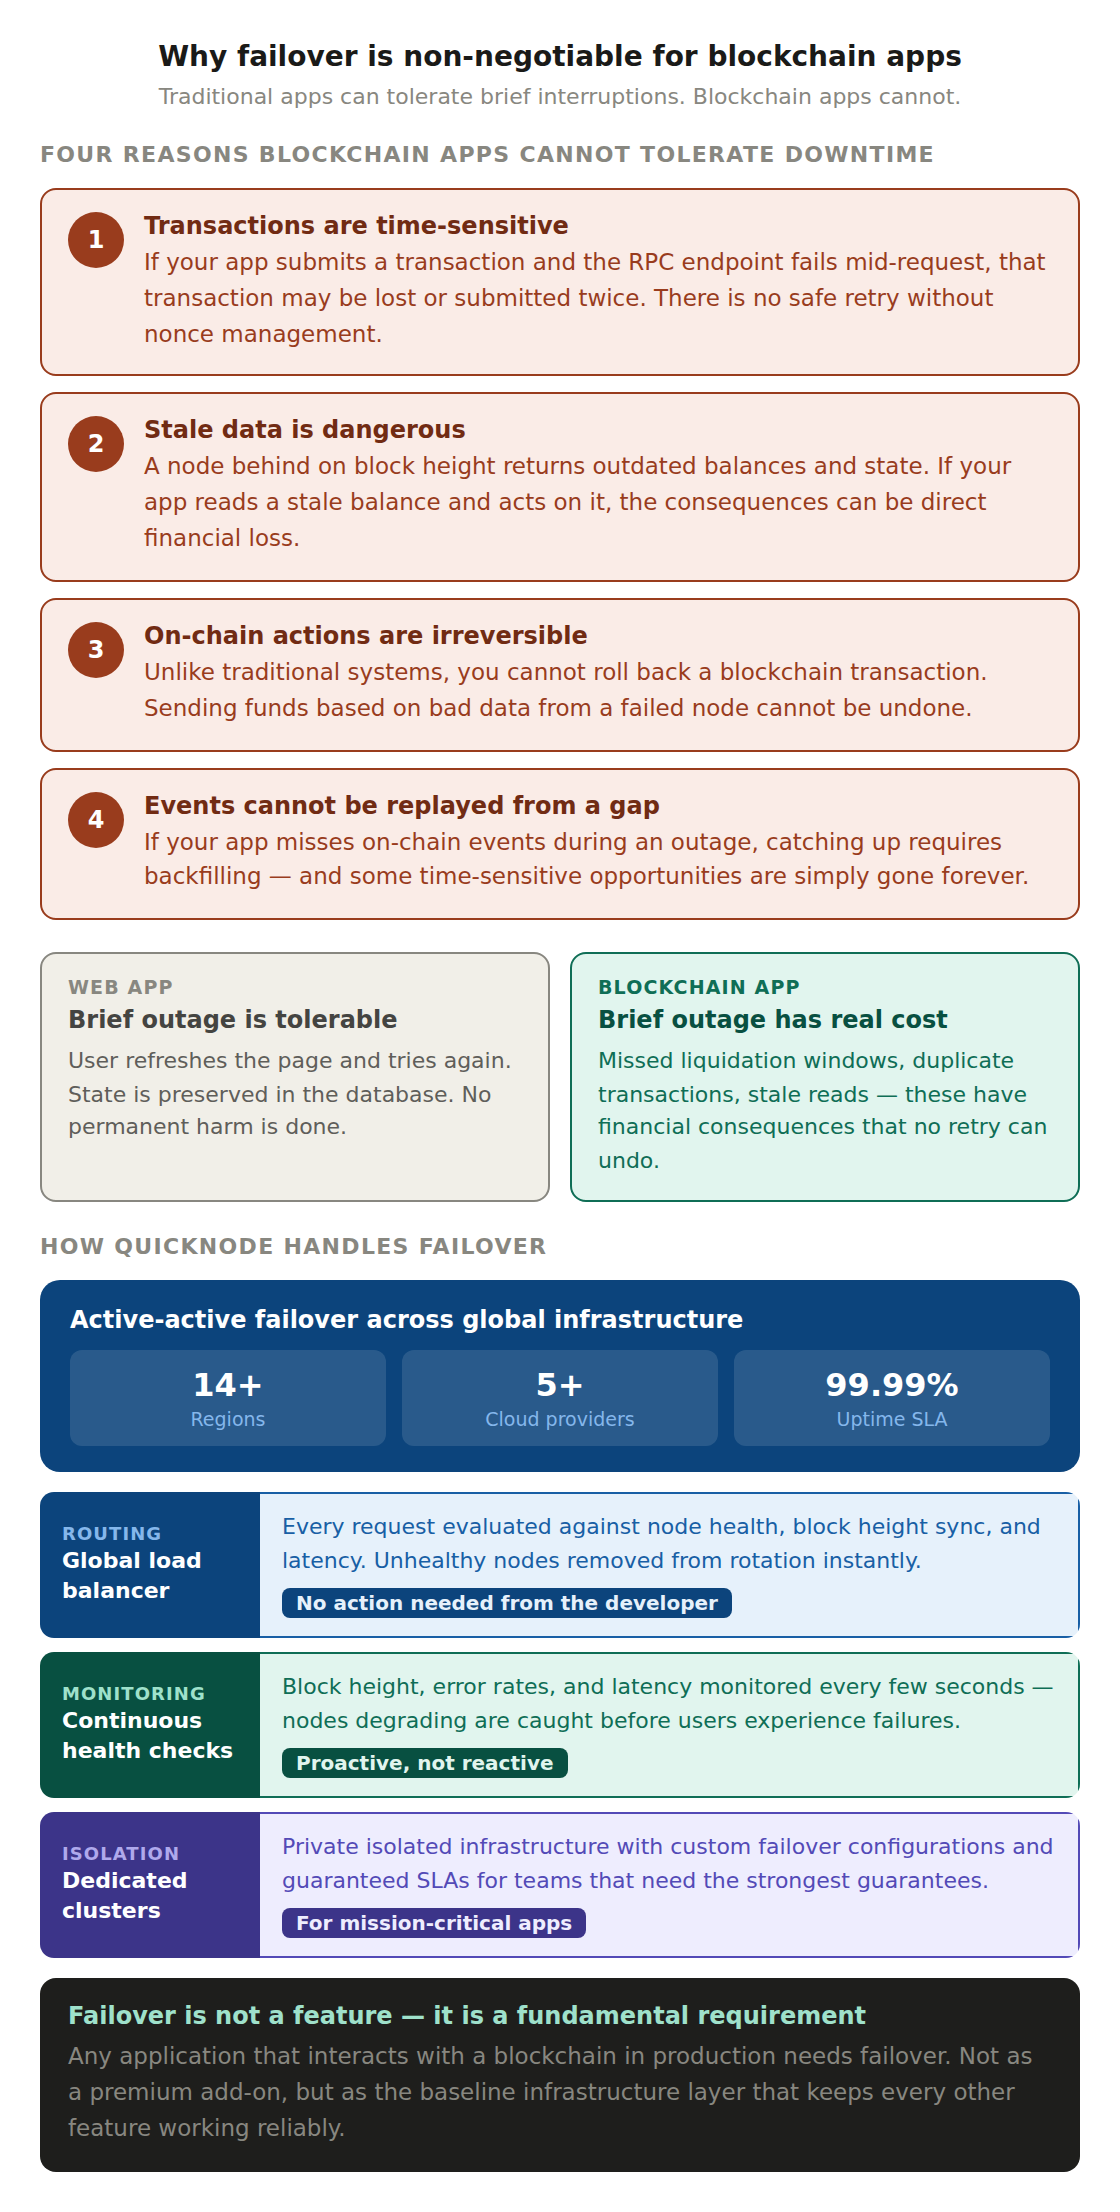
Las aplicaciones web tradicionales suelen poder soportar breves interrupciones. El usuario actualiza la página y todo vuelve a funcionar. Las aplicaciones basadas en blockchain no pueden permitirse ese lujo por varias razones.
Las transacciones son sensibles al tiempo. Si tu aplicación envía una transacción y el RPC endpoint falla en mitad de la solicitud, esa transacción podría perderse o enviarse dos veces. Los datos obsoletos son peligrosos. Un nodo que va retrasado en la altura del bloque devuelve información desactualizada. Si tu aplicación lee un saldo desactualizado y actúa en consecuencia, las consecuencias pueden ser económicas. Los eventos son irreversibles. A diferencia de los sistemas tradicionales, en los que se puede reintentar o revertir una acción, las acciones en la cadena son permanentes. Enviar fondos basándose en datos erróneos procedentes de un nodo que ha fallado no es algo que se pueda deshacer.
Por eso la conmutación por error no es una característica opcional. Es un requisito fundamental para cualquier aplicación que interactúe con una cadena de bloques en entorno de producción.
Cómo gestiona « Quicknode » la conmutación por error
QuicknodeLa infraestructura de [nombre] utiliza una conmutación por error «activo-activo» en más de 14 regiones y múltiples proveedores de nube. Cada solicitud se enruta a través de una capa de equilibrio de carga global que evalúa continuamente el estado de los nodos, incluyendo el estado de sincronización de la altura del bloque, la latencia de respuesta y las tasas de error. Si se produce un deterioro en algún nodo o región, el tráfico se desvía automáticamente a la siguiente mejor opción sin que el desarrollador tenga que realizar ninguna acción.
Para los equipos que necesitan las mayores garantías, ofrecemos Clústeres ofrecen una infraestructura aislada con configuraciones de conmutación por error personalizadas y acuerdos de nivel de servicio (SLA) que garantizan el tiempo de actividad.
¿Cuál es la diferencia entre la conmutación por error y el equilibrio de carga?
La conmutación por error y el equilibrio de carga están estrechamente relacionados, pero resuelven problemas distintos. El equilibrio de carga distribuye las solicitudes entrantes entre un conjunto de nodos operativos, de modo que ningún nodo se vea sobrecargado. La conmutación por error es lo que ocurre cuando uno de esos nodos deja de estar operativo: el tráfico se retira del nodo que ha fallado y se redistribuye entre el resto. En la práctica, ambos mecanismos funcionan conjuntamente, y una configuración sólida de alta disponibilidad requiere que ambos funcionen en paralelo.
Capacidad | Equilibrio de carga | Conmutación por error |
|---|---|---|
Trabajo principal | Distribuir el tráfico de manera uniforme | Desviar el tráfico para evitar los fallos |
Cuando actúa | De forma continua, en cada solicitud | Solo cuando un componente se deteriora o falla |
Objetivo principal | Rendimiento y uniformidad en la utilización | Continuidad y disponibilidad |
¿Qué se considera un único punto de fallo?
Un punto único de fallo es cualquier componente que, al fallar, provoque la caída de todo el sistema. Un nodo aislado, una única región en la nube o una implementación de cliente pueden convertirse, cada uno de ellos, en un punto único de fallo. La conmutación por error elimina estos eslabones débiles al mantener siempre lista una alternativa en buen estado para tomar el relevo. Analizar los modos de fallo habituales de las cadenas de bloques es la forma más rápida de detectar los puntos únicos de fallo que se esconden en tu pila.
¿Cómo se comprueba si la conmutación por error funciona correctamente?
La conmutación por error se mide mediante una serie de indicadores concretos. El tiempo de actividad muestra con qué frecuencia se ha podido acceder al servicio; el tiempo de recuperación indica cuánto tardó el tráfico en redirigirse tras un fallo; y la tasa de errores durante un incidente refleja cuántas solicitudes se vieron afectadas antes de que se completara la conmutación. La supervisión continua de tu infraestructura de cadena de bloques es lo que permite obtener estas cifras, de modo que puedas confirmar que la conmutación por error está funcionando correctamente.
¿Cómo se puede probar la conmutación por error antes de que se produzca una interrupción real del servicio?
La única forma de confiar en la conmutación por error es ensayarla. Los equipos desconectan deliberadamente un nodo o una región durante un intervalo de tiempo controlado y comprueban que el tráfico se redirija sin errores, un enfoque que a menudo se denomina «pruebas de caos». Si gestionas tus propios nodos, puedes detener un proceso y observar adónde se dirigen las solicitudes. Si recurres a un proveedor gestionado, como laAPI Core de Quicknode , la conmutación por error se gestiona automáticamente, aunque puedes validarla mediante pruebas de carga entre regiones.
Preguntas frecuentes
¿Qué es la conmutación por error en términos sencillos?
La conmutación por error es el cambio automático de un componente averiado a una copia de seguridad operativa para que un servicio siga funcionando. La mayoría de las veces, el usuario ni siquiera se da cuenta de que se ha producido el cambio.
¿El conmutación por error es lo mismo que la redundancia?
No. La redundancia consiste en disponer de componentes de repuesto, mientras que la conmutación por error es el proceso mediante el cual el tráfico se redirige a dichos componentes de repuesto cuando se produce un fallo. Para que la conmutación por error funcione, es necesario contar con una infraestructura redundante.
¿Cuánto tiempo tarda la conmutación por error?
En los sistemas activo-activo, la conmutación por error suele ser instantá near , ya que los servidores de respaldo ya están gestionando el tráfico. En los sistemas activo-pasivo, puede tardar desde unos segundos hasta varios minutos, mientras el servidor en espera se pone en marcha y se sincroniza.
¿El failover evita todo el tiempo de inactividad?
La conmutación por error reduce drásticamente el tiempo de inactividad, pero no puede garantizar una interrupción nula en todas las situaciones. Una infraestructura activa-activa bien diseñada y distribuida por varias regiones se acerca mucho a ese objetivo, por lo que es el estándar para las aplicaciones de blockchain en producción.
¿Por qué es tan importante la conmutación por error para las aplicaciones de blockchain?
Las operaciones en la cadena de bloques son sensibles al tiempo y, a menudo, irreversibles, por lo que un fallo en endpoint puede provocar la pérdida de una transacción o la devolución de datos obsoletos. La conmutación automática por error protege tanto la fiabilidad como los fondos de los usuarios, lo cual es fundamental para los servicios basados en datos en tiempo real streams.
Lecturas recomendadas
¿Qué es la alta disponibilidad en la infraestructura de blockchain?
Por qué es importante la redundancia de la infraestructura
¿Cómo se producen las interrupciones en la cadena de bloques?
¿Qué es la latencia RPC?
Quicknode Documentación