En resumen: La supervisión de la infraestructura de blockchain implica realizar un seguimiento continuo del estado, el rendimiento y la precisión de los nodos, los puntos finales RPC y los flujos de datos de los que depende tu aplicación. A diferencia de la supervisión de un servidor web tradicional, la supervisión de blockchain debe tener en cuenta comportamientos específicos de la cadena, como las tasas de producción de bloques, el estado de sincronización, los puntos de control de finalidad, la congestión del mempool y la dinámica de los precios del gas. Las métricas fundamentales que hay que supervisar son la altura del bloque (¿está tu nodo actualizado?), la latencia RPC (¿son rápidas las solicitudes?), las tasas de error (¿se procesan correctamente las solicitudes?) y la actualidad de los datos (¿tu aplicación muestra el estado más reciente?). Una supervisión eficaz combina alertas automatizadas para problemas inmediatos con paneles de control para el análisis de tendencias y la planificación de la capacidad.
La explicación sencilla
Si tu aplicación depende de una cadena de bloques, su buen funcionamiento depende en exclusiva de la infraestructura que la conecta a dicha cadena. Un contrato inteligente perfectamente escrito y una interfaz de usuario magníficamente diseñada no sirven de nada si el endpoint RPC que aloja tus datos deja de funcionar, se retrasa o empieza a devolver errores. La monitorización te permite detectar los fallos antes de que los usuarios se den cuenta.
La supervisión tradicional de aplicaciones web se centra en la CPU, la memoria, el disco y la red del servidor. La supervisión de la infraestructura de blockchain incluye todo eso, además de un conjunto de métricas específicas de la cadena que no existen en los sistemas convencionales. ¿Está el nodo sincronizado con el último bloque? ¿Se encuentra el nodo en la cadena canónica o se ha quedado atascado en una bifurcación? ¿Las respuestas RPC devuelven datos de la altura de bloque correcta? ¿Está el mempool lo suficientemente congestionado como para afectar a los tiempos de confirmación de las transacciones? Estas señales específicas de blockchain son las que distinguen una configuración de supervisión robusta de otra que pasa por alto modos de fallo críticos.
Qué hay que supervisar
Estado del nodo
La métrica más fundamental es la altura del bloque: ¿cuál es el último bloque que ha procesado tu nodo y cómo se compara con la punta real de la cadena? Un nodo que se queda rezagado respecto a la punta (aunque sea por unos pocos bloques) proporciona datos obsoletos. Tu aplicación podría mostrar saldos desactualizados, pasar por alto transacciones recientes o no detectar eventos confirmados. En cadenas rápidas como Solana (tiempos de bloque de 400 ms), incluso un pequeño retraso en la sincronización significa que tu aplicación va varios bloques por detrás de la realidad.
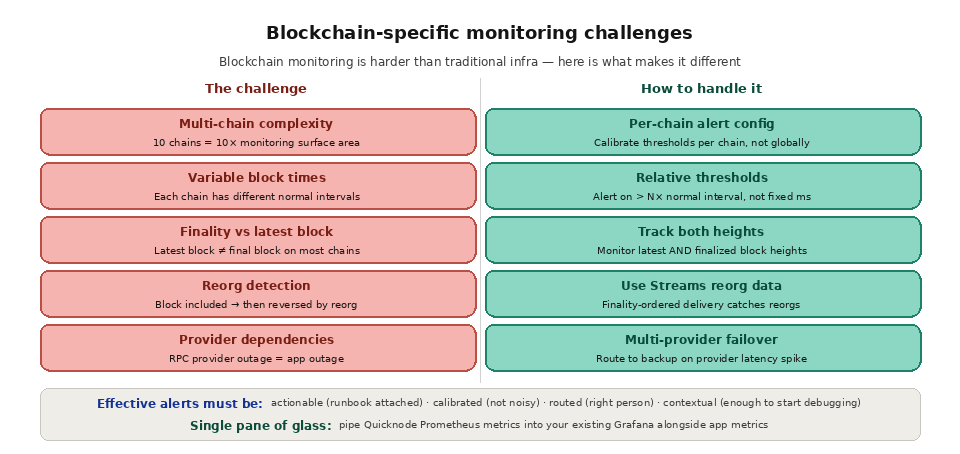
Supervisa la diferencia entre la altura del bloque de tu nodo y la punta de la cadena. Un nodo en buen estado debería mantenerse en todo momento a una distancia de entre 0 y 1 bloque de la punta. Una diferencia de 2 o más bloques es una señal de alerta. Una diferencia de 10 o más bloques significa que tu nodo tiene un problema de sincronización que debe investigarse de inmediato.
El estado de sincronización indica si tu nodo se está sincronizando activamente, está totalmente sincronizado o se ha atascado. Un nodo que está «sincronizando» pero avanza de forma constante se considera en buen estado. Un nodo que indica que está «sincronizando» pero no ha aumentado su altura de bloque en varios minutos se ha atascado y requiere atención.
El recuento de pares indica a cuántos otros nodos está conectado tu nodo. Un nodo en buen estado mantiene conexiones con varios pares para la propagación de datos y la participación en el consenso. Una disminución en el recuento de pares puede indicar problemas de conectividad de red o de configuración.
Rendimiento de RPC
La latencia de respuesta es el tiempo que transcurre entre el envío de una solicitud RPC y la recepción de la respuesta. Realiza un seguimiento de este dato en forma de percentiles (p50, p95, p99) en lugar de medias, ya que las medias ocultan el peor rendimiento que experimentan tus usuarios. Una latencia p50 de 50 ms con un p99 de 2.000 ms significa que la mayoría de las solicitudes son rápidas, pero que 1 de cada 100 tarda 2 segundos completos. Esas solicitudes lentas son las que frustran a los usuarios.
La tasa de error es el porcentaje de solicitudes RPC que devuelven errores (códigos de estado HTTP distintos de 200, respuestas de error JSON-RPC o tiempos de espera agotados). Un servicio « endpoint » en buen estado debería tener una tasa de error inferior al 0,1 %. Las tasas superiores al 1 % indican un problema que requiere una investigación inmediata. Entre los tipos de error más comunes se incluyen el 429 (limitación de frecuencia), el 502/503 (nodo no disponible) y errores JSON-RPC como «missing trie node» (datos del archivo no disponibles) o «nonce too low» (conflicto en el envío de la transacción).
El desglose por método clasifica las métricas según el método RPC (eth_call, eth_getBalance, eth_sendRawTransaction, etc.), ya que cada método presenta perfiles de rendimiento y modos de fallo distintos. Un pico en la latencia de eth_getLogs podría indicar que un nodo tiene dificultades con el filtrado de registros, mientras que un pico en los errores de eth_sendRawTransaction podría indicar una congestión en el mempool.
Condiciones de la cadena
El seguimiento del precio del gas es esencial para cualquier aplicación que envíe transacciones. Supervisar las tendencias de la tarifa base y la tarifa de prioridad ayuda a tu aplicación a calcular los precios adecuados del gas, a evitar pagar de más durante los periodos de menor actividad y a avisar a los usuarios cuando la congestión de la red haga que las transacciones resulten caras.
La profundidad del mempool indica cuántas transacciones pendientes están a la espera de ser incluidas. Un mempool cada vez más lleno es señal de una congestión creciente, lo que se traduce en comisiones más elevadas y tiempos de confirmación más largos. Las aplicaciones que necesiten una confirmación predecible de las transacciones deben supervisar la profundidad del mempool y ajustar su comportamiento en consecuencia.
La velocidad de generación de bloques varía según la cadena y puede fluctuar cuando se producen problemas en la red. Supervisar los intervalos de generación de bloques ayuda a detectar ralentizaciones o paradas en la cadena antes de que afecten al funcionamiento de tu aplicación.
Configuración de la supervisión
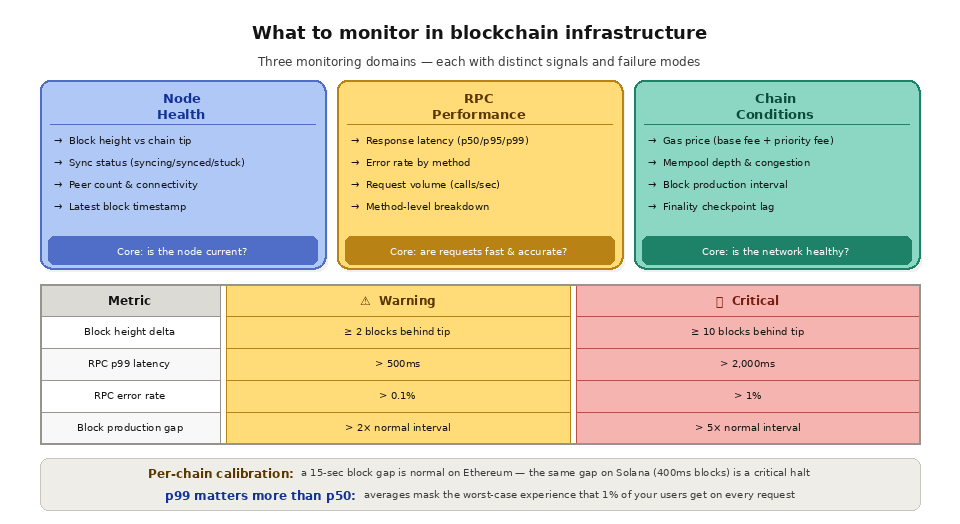
Una pila estándar de supervisión de la infraestructura de blockchain consta de una capa de recopilación, una capa de almacenamiento, una capa de visualización y una capa de alertas.
La capa de recopilación recoge métricas de tu infraestructura. En el caso de los nodos autohospedados, herramientas como Prometheus Node Exporter y los exportadores de métricas personalizados recopilan métricas del sistema y específicas de la cadena de bloques. En cuanto a los puntos finales gestionados, la mayoría de los proveedores ofrecen acceso a las métricas a través de una API o mediante webhooks. Las métricas a nivel de aplicación se pueden recopilar utilizando OpenTelemetry, StatsD o los SDK específicos de cada proveedor.
La capa de almacenamiento es una base de datos de series temporales optimizada para datos de métricas. Prometheus, InfluxDB y Datadog son las opciones más habituales. Las bases de datos de series temporales están diseñadas para el elevado volumen de escrituras y la naturaleza ordenada cronológicamente de los datos de métricas, y cuentan con soporte integrado para la agregación, el submuestreo y las políticas de retención.
La capa de visualización transforma las métricas en bruto en paneles de control útiles. Grafana es el estándar del sector en materia de visualización de monitorización de código abierto, con compatibilidad nativa con Prometheus, InfluxDB y docenas de otras fuentes de datos. Datadog, New Relic y AWS CloudWatch ofrecen visualización integrada como parte de sus plataformas de monitorización.
La capa de alertas evalúa las métricas en función de los umbrales y avisa a las personas adecuadas cuando surge algún problema que requiere atención. Las alertas eficaces deben ser procesables (cada alerta debe tener un manual de procedimientos correspondiente), ajustadas (ni tan sensibles que se activen constantemente, ni tan laxas que pasen por alto problemas reales), redirigidas (enviadas a la persona de guardia a través de PagerDuty, Slack o similares) y contextuales (que incluyan información suficiente para empezar a diagnosticar el problema sin necesidad de abrir un panel de control).
Retos de supervisión específicos de la cadena de bloques
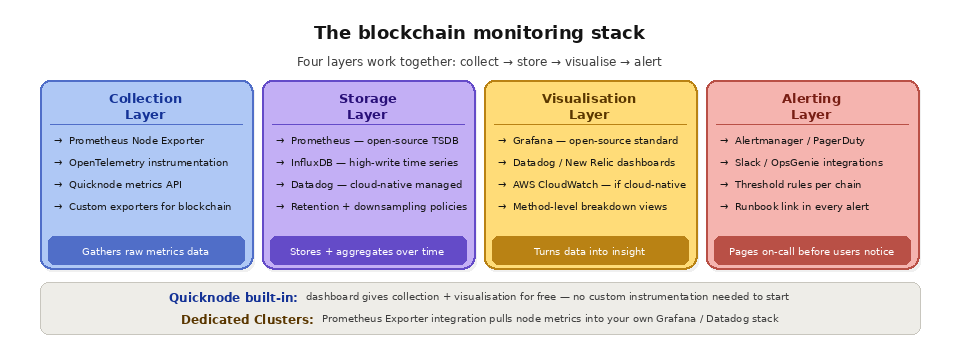
Los entornos con múltiples cadenas multiplican la complejidad de la monitorización. Si tu aplicación admite 10 cadenas, debes supervisar el estado de los nodos, el rendimiento de RPC y las condiciones de cada una de ellas. Cada cadena tiene tiempos de bloqueo distintos, modelos de finalidad diferentes y modos de fallo distintos. Una configuración de monitorización que funcione a la perfección para Ethereum puede pasar por alto señales críticas en Solana, y viceversa.
Los tiempos de bloqueo variables dificultan el establecimiento de umbrales de alerta fijos. Un intervalo de 15 segundos entre los bloqueos de Ethereum es normal. Sin embargo, un intervalo de 15 segundos en Solana (donde los bloqueos deberían producirse cada 400 ms) constituye un problema grave. Las alertas deben calibrarse por cadena, no establecerse de forma universal.
Es importante tener en cuenta la finalidad a la hora de supervisar los flujos de datos. La supervisión no solo debe registrar el último bloque que haya visto tu nodo, sino también el último bloque finalizado. Los datos de los bloques que aún no han alcanzado la finalidad pueden revertirse mediante una reorganización, por lo que las aplicaciones que dependen de datos finalizados necesitan una supervisión que distinga entre la altura del bloque más reciente y la del bloque finalizado.
¿Cuáles son las métricas de supervisión de la cadena de bloques más importantes que hay que tener en cuenta?
Unas pocas métricas de señal alta detectan la mayoría de los problemas de la infraestructura de la cadena de bloques. La tabla siguiente resume qué indica cada una de ellas, el rango que indica que la configuración es correcta y el punto en el que debes avisar a un ingeniero de guardia.
Métrico | Qué mide | Rango saludable | Cuándo avisar |
|---|---|---|---|
Diferencia de altura entre bloques | Distancia desde la punta de la cadena | Entre 0 y 1 manzana | 10 o más manzanas más atrás |
Latencia de RPC (p99) | El 1 % de las respuestas más lentas | Menos de 500 ms | Más de 2 segundos |
Realiza un seguimiento de estos datos como series temporales, en lugar de como lecturas aisladas, para poder detectar tendencias antes de que se conviertan en interrupciones del servicio. La latencia, en particular, debería medirse en percentiles: obtén más información sobre los factores que influyen en la latencia de las RPC y cómo encaja esta en el contexto más amplio de la observabilidad de las cadenas de bloques.
¿En qué se diferencia la supervisión de la cadena de bloques de la supervisión tradicional de la infraestructura?
La supervisión estándar de servidores te indica si un equipo está activo, pero un nodo de cadena de bloques puede superar todas las comprobaciones de infraestructura mientras, sin que se note, proporciona datos obsoletos o reorganizados. La supervisión de cadenas de bloques añade señales específicas de la cadena a las métricas habituales del host.
Aspecto | Supervisión tradicional de infraestructuras | Supervisión de la infraestructura de blockchain |
|---|---|---|
Señal de salud primaria | CPU, memoria, disco, red | Altura del bloque, estado de sincronización, finalidad |
Fallo habitual mode | El servidor está caído o sobrecargado | El nodo está conectado, pero ofrece datos obsoletos o reorganizados |
Riesgo de exactitud | Bajo una vez que el servidor responda | Los datos válidos pueden anularse mediante una reorganización. |
La mayor diferencia radica en la exactitud a lo largo del tiempo. Una respuesta puede ser correcta en el momento en que se devuelve y, sin embargo, quedar invalidada segundos después; por eso, la supervisión debe distinguir entre el último bloque y el bloque finalizado. Consulta «finalidad de la cadena de bloques» para saber por qué esa distinción es importante para los flujos de datos.
¿Se puede supervisar la infraestructura de la cadena de bloques sin tener que ejecutar un nodo propio?
Sí. Los proveedores de RPC gestionados ofrecen paneles de control y métricas sobre el volumen de solicitudes, la latencia y las tasas de error sin que tengas que instalar ningún tipo de instrumentación, lo que elimina la mayor parte de la carga operativa que supone la monitorización autohospedada. A menudo, esta es la vía más rápida para alcanzar una alta disponibilidad, ya que el proveedor se encarga por ti del estado de los nodos, el escalado y la redundancia. La API Core de Quicknode incluye de serie análisis porendpoint , por lo que obtienes visibilidad de tu infraestructura desde la primera solicitud.
¿Cómo se supervisa una infraestructura de blockchain multicadena?
La supervisión multicadena implica calibrar los umbrales para cada cadena, ya que un retraso que resulta normal en una cadena de « Ethereum » puede constituir un incidente grave en una cadena de «sub-second». Centraliza las métricas de todas las cadenas en un único panel de control y configura alertas basadas en los valores de referencia de cada cadena. En el caso de los flujos de datos, Quicknode Streams se informa del éxito en la entrega y de la latencia de procesamiento por cadena, para que sepas al instante si una red se queda rezagada.
Preguntas frecuentes
¿Con qué frecuencia se debe supervisar la infraestructura de la cadena de bloques?
De forma continua. Recopila la altura del bloque y la latencia cada pocos segundos y evalúa las reglas de alerta en tiempo real near . Las cadenas rápidas producen varios bloques por segundo, por lo que un intervalo de sondeo de un minuto puede ocultar un nodo que ya se haya quedado muy rezagado. Combina intervalos de recopilación cortos con los tres pilares ( métricas, registros y trazas) para lograr una cobertura completa.
¿Cuál es una buena tasa de errores en RPC?
Un « endpoint » en buen estado se mantiene por debajo del 0,1 % de errores. Cualquier valor superior al 1 % indica un problema real, como una limitación de velocidad, un nodo no disponible o la falta de datos de archivo. Desglosa siempre los errores por método para poder ver qué llamadas fallan y por qué.
¿Cuál es la diferencia entre la supervisión del último bloque y la del bloque finalizado?
El último bloque es el más reciente que ha visto tu nodo, mientras que el bloque finalizado ha llegado a un punto en el que ya no se revertirá. Las aplicaciones que dependen de datos confirmados deben alertar sobre la altura finalizada, ya que los datos de los bloques no finalizados pueden desaparecer en una reorganización.
¿Cómo se supervisa el tiempo de inactividad de los nodos de la cadena de bloques?
Realiza un seguimiento conjunto de la variación de la altura de los bloques, el número de pares y la tasa de errores, y envía las alertas a un canal de guardia. La combinación de la supervisión con prácticas sólidas de fiabilidad de los nodos y la conmutación automática por error garantiza que el tráfico siga fluyendo hacia un nodo en buen estado en el momento en que otro se vea afectado.
¿Qué herramientas se utilizan para supervisar la infraestructura de la cadena de bloques?
La pila de código abierto más habitual es Prometheus para la recopilación y el almacenamiento, Grafana para los paneles de control y Alertmanager para el enrutamiento. Los proveedores gestionados añaden funciones de análisis integradas, y Dedicated Clústeres puede exportar métricas a nivel de nodo directamente a una configuración existente de Prometheus o Datadog.
Cómo ofrece « Quicknode » el servicio de monitorización
Quicknode Incluye funciones integradas de supervisión y análisis para cada endpoint. El panel de control de Quicknode muestra métricas en tiempo real e históricas, como el volumen de solicitudes, la latencia de respuesta, las tasas de error y desgloses por método. Estas métricas están disponibles sin necesidad de ninguna instrumentación personalizada, lo que ofrece a los desarrolladores una visibilidad inmediata del estado de su infraestructura de cadena de bloques.
Para los equipos que ya cuentan con una infraestructura de monitorización, la integración de Quicknode con Dedicated Clústeres admiten la integración con Prometheus Exporter. Esto te permite extraer métricas a nivel de nodo y a nivel de endpoint directamente a tu instancia de Prometheus, a los paneles de Grafana o a Datadog, lo que permite una monitorización unificada de toda tu pila de aplicaciones y tu infraestructura de blockchain en una única plataforma. Dedicated Clústeres también incluyen una retención de registros de 14 días para un análisis detallado a nivel de solicitud.
Quicknode Streams Ofrece supervisión del estado de los flujos de datos, incluyendo las tasas de éxito en la entrega, la latencia en el procesamiento y los registros de errores. Para los equipos que gestionan flujos de datos en varias cadenas, la supervisión de Streams garantiza que sepas cuándo un flujo se retrasa o tiene problemas de entrega, antes de que la pérdida de datos afecte a tu aplicación.
Lecturas recomendadas
Métricas, registros y trazas - Documentación de Quicknode
Supervisión de la infraestructura de blockchain - Quicknode Glosario
Quicknode API principal
Quicknode Dedicado Clústeres