Respuestas>Más información sobre la monitorización y la observabilidad>Métricas, registros y trazas: en qué se diferencian
Métricas, registros y trazas
// Tags
métricas, registros, trazaspilares de la observabilidad
En resumen: las métricas, los registros y los rastros son los tres tipos de datos fundamentales de la observabilidad, y cada uno de ellos cumple una función distinta a la hora de comprender el comportamiento del sistema. Las métricas son mediciones numéricas agregadas de las que se realiza un seguimiento a lo largo del tiempo, ideales para paneles de control, alertas y análisis de tendencias. Los registros son entradas con marca de tiempo de eventos individuales, ideales para depurar incidentes específicos y mantener registros de auditoría. Los rastros siguen el recorrido completo de una única solicitud a través de un sistema distribuido, revelando dónde se invierte tiempo y dónde se producen los cuellos de botella. En la práctica, los tres funcionan conjuntamente: una métrica activa una alerta, los registros proporcionan los detalles del error y un rastro muestra el contexto completo de la ruta de la solicitud fallida. Una observabilidad eficaz para las aplicaciones de cadena de bloques requiere estos tres pilares, ya que la naturaleza distribuida de la infraestructura de la cadena de bloques genera modos de fallo que ningún tipo de datos puede diagnosticar por sí solo.
La explicación sencilla
Piensa en el diagnóstico de una enfermedad. Tus signos vitales (frecuencia cardíaca, tensión arterial, temperatura) son indicadores: te indican que hay algo anormal. Tu historial médico y los resultados de las pruebas son registros: proporcionan los detalles específicos de lo que está ocurriendo. Una resonancia magnética o una tomografía computarizada es una imagen: muestra el panorama interno completo para que el médico pueda localizar con exactitud dónde está el problema.
En la infraestructura de blockchain, te enfrentas al mismo reto de diagnóstico. Tu aplicación está distribuida entre el frontend, el backend, los puntos finales RPC, los nodos de la cadena de bloques y la propia cadena. Cada capa puede fallar o sufrir una degradación de forma independiente. Las métricas te indican que algo va mal (pico de latencia). Los registros te indican qué ha fallado (un método RPC concreto devuelve errores). Los rastros te indican en qué punto de la ruta de la solicitud se originó el problema (el nodo tardó 3 segundos en procesar una llamada eth_call en un contrato complejo).
¿Cuál es la diferencia entre la monitorización y la observabilidad?
La monitorización y la observabilidad están relacionadas, pero son conceptos distintos. La monitorización supervisa señales conocidas y te avisa cuando se supera un umbral predefinido. La observabilidad es la capacidad más amplia de plantear nuevas preguntas sobre tu sistema utilizando los datos que este genera, incluso en el caso de problemas que no habías previsto. Las métricas, los registros y los rastros son la materia prima de la observabilidad: juntos te permiten pasar de «algo va mal» a «esta es exactamente la razón». Para una introducción más detallada, consulta nuestra descripción general de
¿En qué se diferencian las métricas, los registros y los rastros?
Cada pilar responde a una pregunta diferente y conlleva un coste distinto. La tabla siguiente resume cuándo conviene recurrir a cada uno de ellos.
Dimensión
Métricas
Registros
Huellas
Tipo de datos
Cifras agregadas
Eventos con marca de tiempo
Intervalos de solicitudes vinculadas
La mejor pregunta
¿Pasa algo?
¿Qué ha salido mal?
¿En qué punto se torció todo?
Coste de almacenamiento
Bajo
Alto
Medio, normalmente muestreado
Ideal para
Cuadros de mando y alertas
Depuración de la causa raíz
Análisis de la latencia y los cuellos de botella
Ejemplos de herramientas
Prometheus, Grafana
ELK, Loki, Splunk
OpenTelemetry, Jaeger
En el caso de los sistemas blockchain, estos pilares se suman a una supervisión más amplia de la infraestructura, que controla el estado de los nodos, el estado de sincronización y el comportamiento de las RPC.
Las métricas en detalle
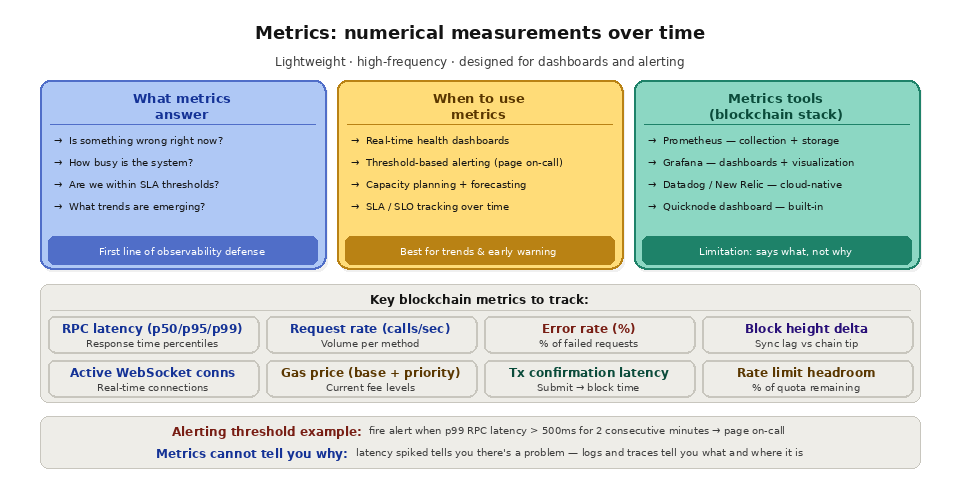
Las métricas son valores numéricos que se recogen a intervalos regulares y se agregan a lo largo del tiempo. Son ligeras, eficientes de almacenar y están diseñadas para una recopilación de alta frecuencia. Una aplicación típica de cadena de bloques realiza un seguimiento de métricas como la tasa de solicitudes RPC (solicitudes por segundo por método), la latencia de respuesta (percentiles p50, p95, p99), la tasa de error (porcentaje de solicitudes que devuelven códigos de estado distintos de 200), el delta de altura de bloque (diferencia entre el último bloque de tu nodo y la punta de la cadena), las conexiones WebSocket activas, el precio del gas (niveles actuales de la tarifa base y la tarifa de prioridad) y la latencia en la confirmación de transacciones.
Las métricas son la primera línea de defensa en materia de observabilidad. Alimentan los paneles de control en tiempo real que permiten comprobar de un vistazo si tus sistemas funcionan correctamente. Actúan como base de las reglas de alerta que avisan al ingeniero de guardia cuando algo supera un umbral. Además, facilitan la planificación de la capacidad al mostrar las tendencias a largo plazo en el uso de los recursos y los patrones de tráfico.
El conjunto estándar de métricas en el ecosistema blockchain suele incluir Prometheus para la recopilación y el almacenamiento, Grafana para la visualización y la creación de paneles, y Alertmanager o PagerDuty para el enrutamiento de alertas. Entre las alternativas nativas de la nube se encuentran Datadog, New Relic y AWS CloudWatch. Todas estas herramientas están diseñadas para gestionar el gran volumen y la naturaleza de series temporales de los datos de métricas.
La limitación de las métricas radica en su carácter agregado. Una métrica te indica que la latencia p99 de RPC superó los 500 ms, pero no te dice qué peticiones concretas fueron lentas, qué parámetros tenían ni qué estaba haciendo el nodo en el momento en que se produjo la ralentización. Para obtener ese nivel de detalle, necesitas registros y trazas.
Registros en detalle
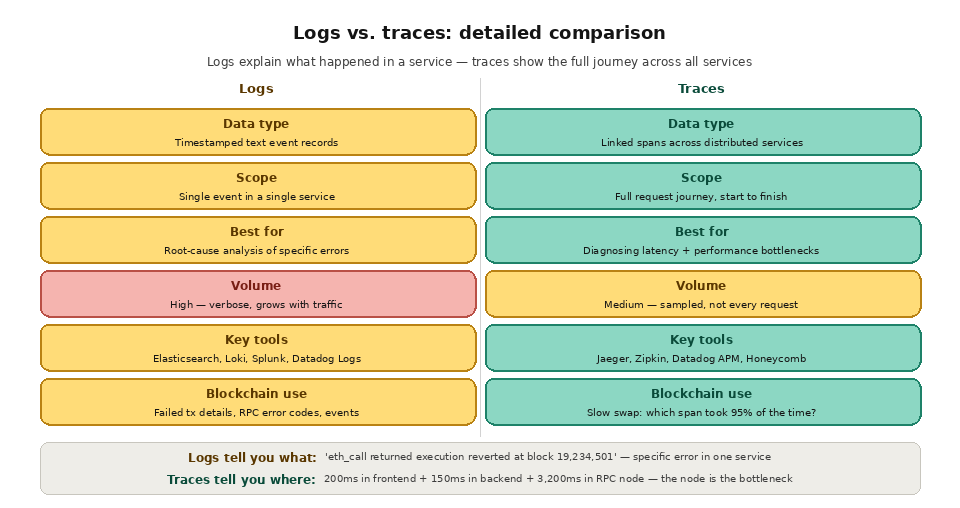
Los registros son entradas de texto con marca de tiempo que recogen eventos individuales. Cada vez que tu aplicación realiza una llamada RPC, procesa una transacción, detecta un error o gestiona una acción del usuario, una entrada de registro recoge los detalles. A diferencia de las métricas (que son cifras agregadas a lo largo de intervalos), los registros son entradas individuales con un contexto muy completo: los parámetros completos de la solicitud, el mensaje de error exacto, el seguimiento de la pila, el ID de usuario y el hash de la transacción.
En las aplicaciones de cadena de bloques, las categorías de registros críticos incluyen los registros de solicitudes RPC (método, parámetros, código de respuesta, latencia por solicitud), los registros del ciclo de vida de las transacciones (hash, transiciones de estado de «pendiente» a «confirmada» y a «finalizada»), los registros de eventos de contratos inteligentes (eventos descodificados de tus contratos con datos completos de los parámetros), los registros de errores (errores RPC, excepciones por tiempo de espera agotado, conflictos de nonce, fallos en la estimación de gas) y los registros de la aplicación (eventos de autenticación de usuarios, decisiones de lógica de negocio, cambios de estado).
Los registros son la herramienta principal para el análisis de las causas raíz. Cuando una métrica te avisa de que las tasas de error han aumentado, consultas los registros en busca de entradas recientes relacionadas con errores, las filtras por tipo de error e identificas el patrón. Quizás un método RPC concreto haya empezado a devolver errores del tipo «nodo trie ausente» porque el nodo ha eliminado datos de estado. Quizás los envíos de transacciones estén fallando debido a conflictos de nonces provocados por un error de procesamiento simultáneo. Los registros contienen los detalles que las métricas no pueden ofrecer.
Entre las herramientas de gestión de registros se incluyen Elasticsearch con Kibana (el «ELK stack»), Grafana Loki, Splunk, Datadog Logs y AWS CloudWatch Logs. Estas herramientas almacenan, indexan y buscan entradas de registro a gran escala, lo que permite la búsqueda de texto completo, las consultas estructuradas y la correlación entre servicios.
La contrapartida de los registros es el volumen y el coste de almacenamiento. Registrar cada solicitud RPC de una aplicación con mucho tráfico genera gigabytes de datos al día. El registro estructurado (en el que las entradas de registro tienen formato JSON con nombres de campos coherentes) permite una indexación y una consulta más eficientes que los registros de texto no estructurados, y el muestreo de registros (que consiste en registrar solo una parte de los eventos rutinarios) puede reducir el volumen sin perder visibilidad sobre los errores y las anomalías.
Las huellas en detalle
Los rastros recogen el recorrido completo de una solicitud concreta a lo largo de un sistema distribuido. Un rastro se compone de varios tramos, cada uno de los cuales representa una unidad de trabajo en un servicio específico. Los tramos se anidan jerárquicamente (un tramo principal para la solicitud global y tramos secundarios para cada suboperación) y están vinculados mediante un identificador de rastro compartido.
En una aplicación de cadena de bloques, una sola traza podría capturar los siguientes intervalos: el usuario hace clic en «swap» en el navegador (intervalo de front-end, 50 ms), el front-end envía una solicitud de API al back-end (intervalo de red, 20 ms), el back-end llama a la RPC endpoint para estimar el gas (intervalo de RPC, 150 ms), el backend llama a la RPC endpoint para enviar la transacción (intervalo de RPC, 200 ms), el backend comprueba si se ha recibido la transacción (varios intervalos de RPC, 12 000 ms en total), el backend envía la confirmación al frontend (intervalo de red, 15 ms) y el frontend actualiza la interfaz de usuario (intervalo de frontend, 30 ms). El rastreo muestra que el 95 % del tiempo total se dedicó a esperar la confirmación en cadena, y no en ningún código propio de la aplicación.
El rastreo distribuido se implementa inyectando el contexto de rastreo (un ID de rastreo y un ID de tramo) en cada solicitud a medida que esta recorre el sistema. Cada servicio crea tramos para su propio trabajo y propaga el contexto de rastreo a los servicios posteriores. Las bibliotecas de rastreo, como OpenTelemetry, proporcionan instrumentación estandarizada para la mayoría de los lenguajes de programación y marcos de trabajo. Las herramientas de visualización, como Jaeger, Zipkin y Datadog APM, muestran los rastreos en forma de diagramas en cascada que reflejan la duración y el anidamiento de cada tramo.
Los rastros son muy valiosos para diagnosticar problemas de latencia en arquitecturas distribuidas. Cuando un usuario informa de que una transacción tardó 30 segundos en confirmarse, un rastro te muestra exactamente en qué se invirtieron esos 30 segundos: 25 segundos esperando la inclusión en el bloque, 3 segundos en llamadas RPC, 1,5 segundos en el procesamiento del backend y 500 ms en la representación del frontend. Te das cuenta de inmediato de que optimizar el código del backend no servirá de nada; el cuello de botella es el tiempo de confirmación a nivel de cadena.
Cómo utilizarlos los tres juntos
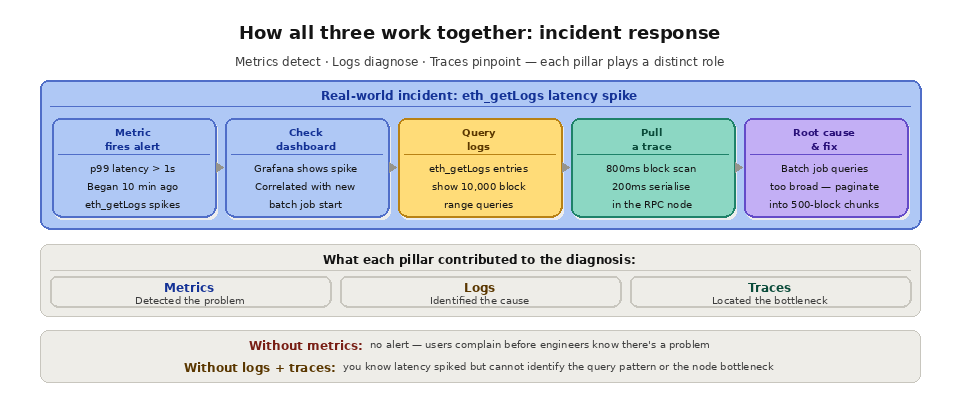
Los tres pilares son complementarios, no competitivos. Un flujo de trabajo típico de respuesta ante incidentes utiliza los tres.
Se activa una alerta de métricas: la latencia RPC p99 ha superado 1 segundo. Abres tu panel de Grafana y ves que el pico de latencia comenzó hace 10 minutos y está correlacionado con un pico en las llamadas a eth_getLogs. Consultas tus registros en busca de solicitudes recientes de eth_getLogs y descubres que, al mismo tiempo, se inició un nuevo trabajo por lotes que realiza consultas de registros de amplio alcance que abarcan 10 000 bloques cada una. Obtienes un seguimiento de una de estas solicitudes y ves que el nodo RPC tardó 800 ms en escanear los bloques y 200 ms en serializar la respuesta. La causa raíz está clara: las consultas de registros excesivamente amplias del trabajo por lotes están consumiendo una cantidad desproporcionada de recursos del nodo. La solución consiste en paginar las consultas en rangos de bloques más pequeños.
Sin métricas, no sabrías que había un problema hasta que los usuarios se quejaran. Sin registros, sabrías que la latencia ha aumentado, pero no qué solicitudes la han provocado. Sin trazas, sabrías que eth_getLogs es lento, pero no si el cuello de botella está en tu aplicación, en la red o en el escaneo de bloques del nodo.
¿Por qué pilar deberías empezar?
Si estás poniendo en marcha la observabilidad desde cero, empieza por las métricas, ya que su recopilación resulta económica y permiten detectar problemas de forma inmediata a través de paneles de control y alertas. A continuación, añade registros estructurados para poder investigar los problemas que revelan las métricas. Incorpora el rastreo distribuido cuando tu sistema abarque varios servicios y necesites identificar con precisión dónde se acumula la latencia. En el caso concreto de la cadena de bloques, combinar esto con el seguimiento de la latencia de RPC te permitirá cubrir la capa que más probabilidades tiene de darte sorpresas en producción.
Cómo « Quicknode » respalda los tres pilares
QuicknodeEl panel de control ofrece métricas integradas para cada endpoint: volumen de solicitudes, latencia de respuesta, índices de error y desgloses por método. Estas métricas proporcionan a los desarrolladores una visibilidad inmediata de su capa de infraestructura de cadena de bloques sin necesidad de instrumentación personalizada.
Para los equipos que integren métricas de blockchain en su pila de observabilidad existente, el servicio «Dedicated» de QuicknodeClústeres es compatible con Prometheus Exporter, lo que permite la ingesta directa de métricas a nivel de nodo en Prometheus, Grafana, Datadog o cualquier sistema compatible. Esto permite crear paneles unificados que abarquen tanto las métricas de las aplicaciones como las de la infraestructura de blockchain.
Quicknode Streams Ofrece observabilidad sobre el estado del flujo de datos, incluyendo métricas de entrega, estado del procesamiento e informes de errores. En combinación con los análisis de RPC y tus propios registros y rastreos a nivel de aplicación, Quicknode proporciona a los desarrolladores una visión completa de la observabilidad necesaria para diagnosticar y resolver problemas en todas las capas de la pila de la cadena de bloques.
Preguntas frecuentes
¿Son lo mismo las métricas, los registros y los rastros que la monitorización?
No. Son los tipos de datos subyacentes. La monitorización consiste en supervisar señales predefinidas y generar alertas sobre ellas, mientras que la observabilidad utiliza estos tres tipos de datos para investigar problemas que no se habían previsto de antemano.
¿Cuál de los tres es el más caro de almacenar?
Los registros suelen ser los más costosos, ya que recogen cada evento individual con todo detalle. Las métricas son las más económicas gracias a la agregación, y los rastros se sitúan en un término medio, ya que normalmente se obtienen mediante muestreo en lugar de capturarse para cada solicitud.
¿Necesito los tres para una aplicación pequeña?
Al principio no. La mayoría de los equipos empiezan con métricas y registros básicos. El rastreo distribuido cobra sentido cuando las solicitudes atraviesan varios servicios y resulta difícil atribuir la latencia a un único componente.
¿Qué es OpenTelemetry?
OpenTelemetry es un estándar abierto y un conjunto de bibliotecas para generar métricas, registros y trazas de forma independiente del proveedor. Permite realizar la instrumentación una sola vez y exportar los datos a múltiples sistemas de gestión, como Prometheus, Jaeger o Datadog.
¿Cómo se aplica esto concretamente al RPC de blockchain?
Las llamadas RPC son una fuente habitual de latencia y errores, por lo que realizar un seguimiento de la tasa de solicitudes, los percentiles de latencia y los códigos de error como métricas, registrar las llamadas fallidas en los registros y rastrear las solicitudes lentas de principio a fin te proporciona una visibilidad completa. Una infraestructura de Node.js fiable, tal y como se explica en nuestra guía sobre la fiabilidad de Node.js, reduce el número de incidencias que tienes que diagnosticar en primer lugar.