En resumen: un sistema de alertas eficaz avisa a las personas adecuadas de problemas reales en el momento oportuno, con suficiente contexto para que puedan actuar de inmediato. Los principios más importantes son: alertar sobre los síntomas (el impacto para el usuario) en lugar de sobre las causas (métricas internas); garantizar que cada alerta sea susceptible de acción (si no hay nada que hacer, no debería ser una alerta); reducir el ruido de forma drástica (la fatiga por alertas hace que se pasen por alto incidentes reales); y proporcionar contexto (qué falla, cuál es la gravedad, quién se ve afectado y qué hacer al respecto). En el caso de las aplicaciones de blockchain, las alertas también deben abarcar condiciones específicas de la cadena, como el retraso en la sincronización de los nodos, los picos en el precio del gas, los retrasos en la confirmación de transacciones y las reorganizaciones de bloques.
La explicación sencilla
Las alertas son el puente entre los datos de monitorización y la acción humana. Los sistemas de monitorización recopilan miles de métricas y millones de entradas de registro. Las alertas determinan cuáles de esas señales merecen que alguien se despierte a las 3 de la madrugada. Si se hacen bien, tu sistema de gestión de incidencias ( equipe ) detecta los problemas antes de que los usuarios se den cuenta. Si se hacen mal, o bien las incidencias reales se pierden entre una avalancha de ruido (demasiadas alertas), o bien los problemas críticos pasan desapercibidos hasta que los usuarios se quejan (demasiadas pocas alertas).
El objetivo de un sistema de alertas bien configurado es que no haya sorpresas: cada incidencia en producción debe ir precedida de una alerta, y cada alerta debe preceder a una incidencia real (o inminente). Las alertas que se activan sin que haya un problema correspondiente hacen que tu equipo de equipe las ignore. Los problemas que se producen sin una alerta previa indican que tu sistema de monitorización tiene una laguna.
¿Cuál es la diferencia entre la supervisión y las alertas?
La monitorización y las alertas están relacionadas, pero son conceptos distintos. La monitorización consiste en la recopilación continua de métricas, registros y trazas que describen el estado de tu sistema. Las alertas son la capa superior que decide cuáles de esas señales merecen una respuesta humana y las remite a la persona adecuada. Se puede realizar una monitorización sin generar alertas, pero no se pueden gestionar bien las alertas sin una buena monitorización subyacente. En cuanto a los datos, consulta la sección sobre la monitorización de la infraestructura de blockchain y la práctica más amplia de la observabilidad de blockchain.
Presta atención a los síntomas, no a las causas
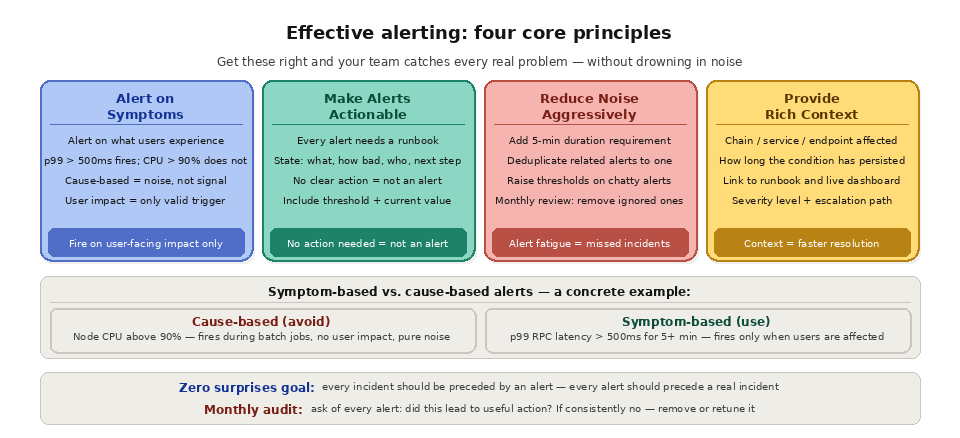
El principio más importante en materia de alertas es basarlas en los síntomas (lo que experimentan los usuarios) en lugar de en las causas (lo que ocurre internamente). Una alerta basada en síntomas se activa cuando algo falla desde la perspectiva del usuario. Una alerta basada en causas se activa cuando una métrica interna supera un umbral, independientemente de si los usuarios se ven afectados o no.
Una alerta basada en la causa, como «Uso de la CPU del nodo superior al 90 %», podría activarse durante un trabajo de procesamiento por lotes normal que consuma mucha CPU, pero que no afecte a la experiencia del usuario. Esta alerta genera ruido y merma la confianza en el sistema de alertas. Una alerta basada en síntomas, como «Tiempo de respuesta RPC p99 superior a 500 ms durante más de 5 minutos», se activa solo cuando los usuarios experimentan realmente respuestas lentas, independientemente de si la causa es un uso elevado de la CPU, un problema de sincronización o una congestión de la red.
Esto no significa que nunca debas supervisar las métricas internas. Las métricas internas son valiosas para los paneles de control, el análisis de tendencias y la investigación tras un incidente. Sin embargo, no deberían generar alertas a menos que estén directamente relacionadas con el impacto que sufren los usuarios. Reserva las alertas para aquellas señales que indiquen que algo no funciona o está a punto de dejar de funcionar para los usuarios reales.
¿Cuál es la diferencia entre las alertas basadas en los síntomas y las basadas en las causas?
Las alertas basadas en síntomas se activan en función de lo que experimentan los usuarios, mientras que las alertas basadas en causas se activan en función de métricas internas que pueden afectar o no a los usuarios. La tabla siguiente compara ambas para que puedas decidir qué señales deben activar una notificación y cuáles deben permanecer en un panel de control.
Aspecto | Alerta basada en síntomas | Alerta basada en la causa |
|---|---|---|
Activadores activados | Repercusión para los usuarios | Umbral métrico interno |
Ejemplo | p99: latencia de RPC superior a 500 ms durante 5 minutos | La CPU del nodo supera el 90 % |
Riesgo de falsos positivos | Bajo | Alto |
Se recomienda utilizarlo como |
Cómo hacer que las alertas sean útiles
Cada alerta debe tener una respuesta clara y documentada. Si se activa una alerta y la primera reacción del ingeniero de guardia es «¿qué se supone que tengo que hacer al respecto?», la alerta no es pasible de acción.
Cada alerta debe incluir cuál es el problema (una descripción clara del síntoma), el contexto cuantitativo (el umbral que se ha superado y el valor actual), el alcance (qué endpoint, cadena o servicio se ve afectado), la duración (cuánto tiempo lleva persistiendo la situación) y un enlace a un manual de procedimientos (instrucciones paso a paso para diagnosticar y resolver el problema).
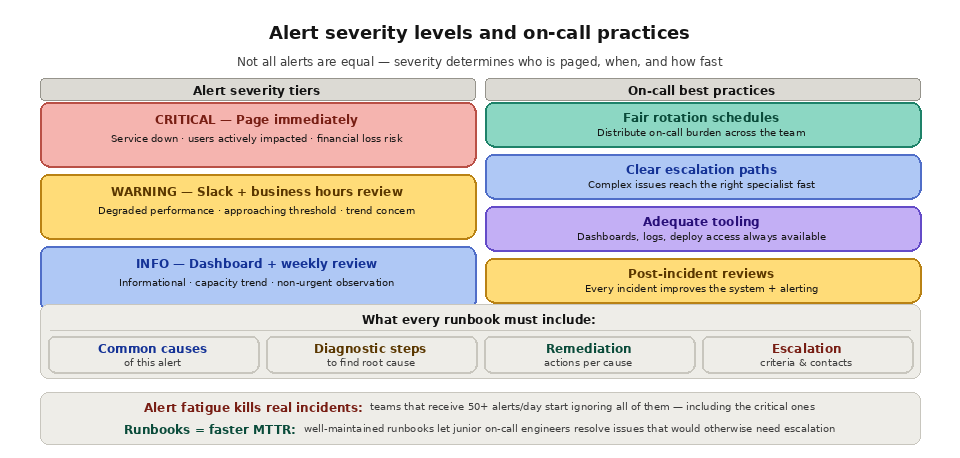
Los manuales de procedimientos son documentación esencial para cada alerta. Un manual de procedimientos debe guiar al responsable de la respuesta a través de las causas habituales de la alerta, los pasos de diagnóstico para identificar la causa raíz, las medidas correctivas para cada causa habitual y los criterios de escalado (cuándo avisar a otra persona). Unos manuales de procedimientos bien mantenidos reducen drásticamente el tiempo de respuesta ante incidentes y permiten a los miembros menos experimentados del equipo de « equipe » gestionar eficazmente sus turnos de guardia.
Reducción del ruido de las alertas
La fatiga por alertas es la mayor amenaza para un sistema de alertas eficaz. Cuando los equipos reciben docenas de alertas al día, la mayoría de las cuales son falsos positivos o de baja prioridad, empiezan a ignorar todas las alertas, incluidas las críticas.
Los estudios en el ámbito sanitario (donde la fatiga por alarmas es un problema reconocido para la seguridad de los pacientes) muestran que hasta el 99 % de las alarmas pueden ser falsos positivos, lo que lleva a los profesionales sanitarios a desactivarlas o ignorarlas.
Las estrategias para reducir el ruido incluyen elevar los umbrales de las alertas que se activan con frecuencia y no requieren acción, añadir requisitos de duración (activar la alerta solo si la condición persiste durante más de 5 minutos, en lugar de activarse ante un pico momentáneo), deduplicar las alertas relacionadas (si cinco terminales del mismo proveedor funcionan lentos, enviar una sola alerta, no cinco), implementar niveles de gravedad (las alertas críticas se envían inmediatamente; las alertas de advertencia se dirigen a un canal de Slack para su revisión en horario laboral) y revisar y retirar periódicamente las alertas que se ignoran sistemáticamente o se resuelven sin necesidad de tomar medidas.
Un ejercicio útil consiste en revisar todas las alertas que se han activado en el último mes y preguntarse: «¿Esta alerta ha dado lugar a una acción útil?». Si la respuesta es sistemáticamente «no», elimínala o reajústala.
Alertas específicas de blockchain
Las aplicaciones basadas en blockchain necesitan alertas que abarquen condiciones a nivel de la cadena, además de las alertas estándar relacionadas con las aplicaciones y la infraestructura.
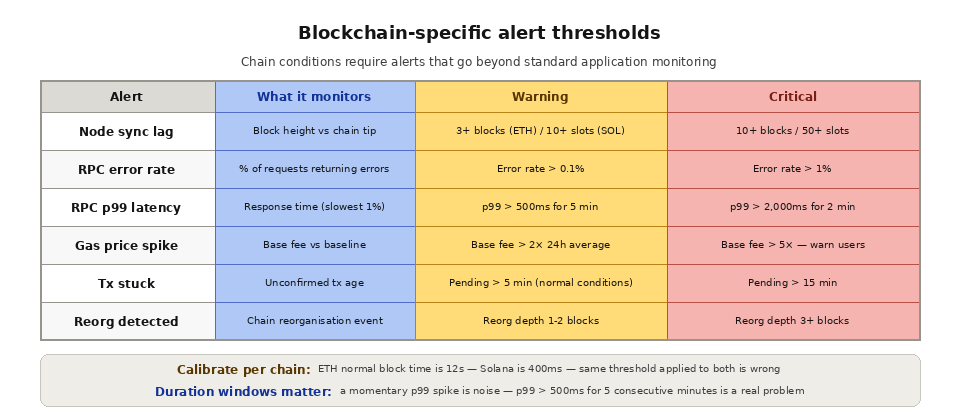
El retraso en la sincronización del nodo debería generar una alerta cuando tu nodo (o el nodo de tu proveedor) se quede rezagado más de un número configurable de bloques respecto a la punta de la cadena. Para Ethereum, se generará una alerta a partir de 3 bloques de retraso. Para Solana, se generará una alerta a partir de 10 slots de retraso. El retraso en la sincronización significa que tu aplicación está proporcionando datos obsoletos.
Las subidas repentinas del precio del gas afectan a cualquier aplicación que envíe transacciones. Activa una alerta cuando la tarifa base supere un umbral que haga que las transacciones resulten económicamente inviables para tu caso de uso. Esto permite que tu aplicación avise a los usuarios, aplace las transacciones no urgentes o ajuste los parámetros del gas de forma proactiva.
Las alertas de «transacción atascada» se activan cuando una transacción enviada no se ha confirmado dentro del plazo previsto. Es probable que una transacción que lleve más de 10 minutos pendiente en Ethereum en condiciones normales tenga un precio de gas insuficiente y deba volver a enviarse con una tarifa más alta.
Las alertas de detección de reorganización te avisan cuando se produce una reorganización de bloques en una cadena de la que depende tu aplicación. Si tu canal de datos procesa bloques en la punta de la cadena sin esperar a que se alcance la finalidad, una reorganización implica que los datos procesados recientemente pueden ser incorrectos y deben corregirse.
Las alertas de estado del proveedor permiten supervisar el estado general de tu proveedor RPC. Si las tasas de error de tu proveedor superan el umbral establecido, tu aplicación debe estar preparada para cambiar a un proveedor de reserva o pasar a un estado de servicio reducido mode.
¿Qué situaciones en la cadena de bloques deberían activar alertas?
Más allá de las alertas estándar de infraestructura, las aplicaciones de blockchain necesitan alertas adaptadas al estado de la cadena. En la tabla siguiente se enumeran condiciones habituales y umbrales de ejemplo. Condiciones como las reorganizaciones merecen un tratamiento especial, que tratamos en el artículo «¿Qué es una reorganización en una cadena de bloques?», y el retraso en la sincronización está directamente relacionado con la fiabilidad de los nodos.
Condición | Umbral de ejemplo | Por qué es importante |
|---|---|---|
Retraso en la sincronización de nodos | 3 o más bloques (Ethereum) o 10 o más ranuras (Solana) | Estás mostrando datos obsoletos |
Aumento del precio de la gasolina | Base cuota superior a tu límite económico | Las transacciones resultan demasiado caras |
Transacción bloqueada | Pendiente desde hace más de 10 minutos | Probablemente esté infravalorado y haya que volver a presentarlo |
Buenas prácticas en materia de guardias
Las alertas solo son eficaces si alguien responde a ellas con rapidez y competencia. Para establecer una práctica de guardias eficaz, es necesario contar con turnos de rotación justos que repartan la carga entre el equipe, vías de escalado claras para que los problemas complejos lleguen rápidamente al especialista adecuado, herramientas adecuadas para que el ingeniero de guardia tenga acceso inmediato a paneles de control, registros y herramientas de implementación, revisiones posteriores a los incidentes que generen mejoras tanto en el sistema como en la configuración de las alertas, y políticas de compensación o tiempo libre que reconozcan el coste real de estar de guardia.
¿Cómo se complementan las alertas y la alta disponibilidad?
Las alertas te avisan cuando algo falla, pero la alta disponibilidad mantiene el servicio en funcionamiento mientras respondes. Ambas cosas se refuerzan mutuamente: las alertas de estado del proveedor resultan más útiles cuando dispones de un sistema de respaldo listo para tomar el relevo. Combina tus alertas con un diseño de alta disponibilidad, una conmutación automática ante fallos y la redundancia de la infraestructura que hace posible una respuesta rápida.
Cómo « Quicknode » permite una gestión eficaz de las alertas
QuicknodeLas funciones de análisis integradas proporcionan la base métrica para las alertas de la infraestructura de blockchain. El volumen de solicitudes, la latencia de respuesta, las tasas de error y los desgloses por método están disponibles en el panel de control y pueden utilizarse para establecer umbrales de alerta. Para los equipos que cuenten con una infraestructura de alertas personalizada, la función «Dedicated» de QuicknodeClústeres exportan métricas compatibles con Prometheus que se integran directamente con Alertmanager, Grafana Alerts, PagerDuty o cualquier sistema de alertas de tu pila.
Quicknode Streams proporciona métricas de estado de las entregas que permiten generar alertas ante problemas en el flujo de datos: entregas fallidas, retrasos en el procesamiento y errores de destino. En combinación con las alertas de la capa RPC, esto ofrece a los equipos una cobertura integral tanto de su acceso a las API en tiempo real como de su infraestructura de datos en streaming.
Lecturas recomendadas
Métricas, registros y trazas - Documentación de Quicknode
Supervisión de la infraestructura de blockchain - Quicknode Glosario
Quicknode API principal
Quicknode Dedicado Clústeres
Preguntas frecuentes
¿Qué hace que una alerta sea susceptible de actuación?
Una alerta se puede gestionar cuando la persona encargada de responder sabe exactamente qué hacer. Debe indicar el síntoma, el umbral superado y el valor actual, el ámbito afectado, cuánto tiempo lleva durando la situación y un enlace a un manual de procedimientos con los pasos de diagnóstico y corrección.
¿Qué es la fatiga por alertas?
La fatiga por alertas se produce cuando un « equipe » recibe tantas alertas, especialmente falsos positivos, que empieza a ignorarlas todas, incluidas las críticas. Aumentar los umbrales, añadir requisitos de duración, eliminar duplicados y utilizar niveles de gravedad son medidas que permiten reducirla.
¿Deberías configurar alertas sobre el uso de la CPU?
Normalmente, no como alerta. La CPU es una métrica basada en causas que a menudo presenta picos durante el funcionamiento normal sin que ello afecte a los usuarios. Manténla en un panel de control y, en su lugar, configura alertas para síntomas perceptibles para los usuarios, como tasas de error elevadas o latencia.
¿Cómo se avisa de las reorganizaciones de la cadena de bloques?
Configura la detección de reorganizaciones en las cadenas de las que dependes y establece una alerta cuando una reorganización sea más profunda que el número de confirmaciones que esperas. Si tu proceso procesa bloques en la punta de la cadena, una reorganización significa que hay que corregir datos recientes. Consulta los modos de fallo habituales de las cadenas de bloques para conocer los riesgos relacionados.
¿Qué niveles de gravedad deben tener las alertas?
Un modelo sencillo y eficaz consta de dos niveles: las alertas críticas activan inmediatamente la notificación a la persona de guardia, mientras que las alertas de advertencia se envían a un canal para su revisión en horario laboral. De este modo, las notificaciones se reservan para los problemas que realmente requieren una respuesta humana urgente.