En resumen: La observabilidad es la capacidad de comprender lo que ocurre en el interior de un sistema mediante el análisis de sus resultados externos. En la infraestructura de blockchain, la observabilidad implica disponer de las métricas, los registros y los rastros necesarios para responder a preguntas como «¿por qué mi dapp va lenta?», «¿por qué ha fallado esta transacción?» y «¿funciona correctamente mi RPC endpoint ?». Va más allá de la simple supervisión (que solo indica que algo va mal), ya que proporciona los datos necesarios para comprender por qué va mal. La observabilidad se sustenta en tres pilares: métricas (mediciones numéricas a lo largo del tiempo), registros (registros de eventos con marca de tiempo) y trazas (recorridos de las solicitudes de extremo a extremo a través de sistemas distribuidos).
La explicación sencilla
La monitorización te indica que se ha encendido la luz del motor de tu coche. La observabilidad te indica que la luz del motor se ha encendido porque el sensor de O₂ del cilindro 3 registra una mezcla pobre a 2.500 rpm, lo cual comenzó tras la sustitución del filtro de fuel la semana pasada, y el patrón coincide con un problema conocido relacionado con los filtros de recambio.
En ingeniería de software, la observabilidad es la práctica de equipar los sistemas con instrumentos de forma tan exhaustiva que permita diagnosticar cualquier problema sin tener que reproducirlo ni añadir nuevos instrumentos a posteriori. No es necesario prever de antemano todos los fallos posibles mode . Lo que se necesita es disponer de suficientes datos brutos (métricas, registros, trazas) para que, cuando ocurra algo inesperado, se pueda rastrear hacia atrás desde el síntoma hasta la causa raíz.
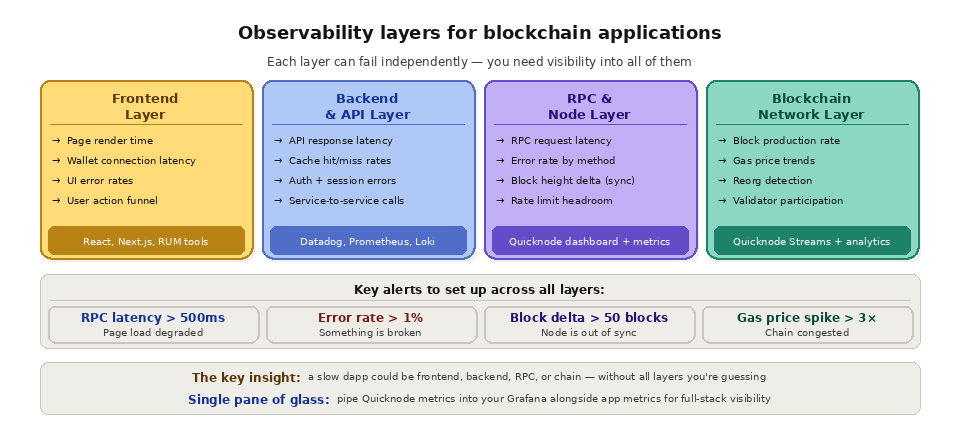
En el caso de las aplicaciones de cadena de bloques, la observabilidad es especialmente crucial, ya que los sistemas están distribuidos en múltiples capas: el front-end, el back-end, el proveedor de RPC, el nodo de la cadena de bloques, la red de consenso y la propia cadena. Si un usuario experimenta una actualización lenta de su saldo, esto podría deberse a una renderización lenta del front-end, un problema de almacenamiento en caché del back-end, latencia en la endpoint de RPC, retraso en la sincronización del nodo o congestión de la cadena. Sin observabilidad en todas las capas, diagnosticar la causa real requiere hacer conjeturas.
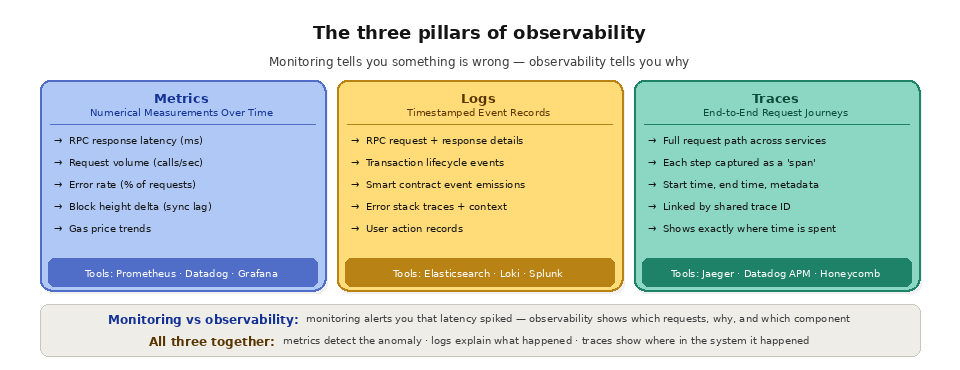
Los tres pilares de la observabilidad
Métricas
Las métricas son mediciones numéricas que se recogen a intervalos regulares a lo largo del tiempo. Constituyen la base de los paneles de control y las alertas. En la infraestructura de blockchain, entre las métricas clave se incluyen la latencia de respuesta del RPC (el tiempo que tarda cada llamada a la API), el volumen de solicitudes (el número de llamadas por segundo que realiza tu aplicación), la tasa de error (el porcentaje de solicitudes que devuelven errores), el delta de altura de bloque (la distancia a la que se encuentra tu nodo respecto a la punta de la cadena), las tendencias del precio del gas (los niveles actuales de las comisiones de la red) y el tiempo de confirmación de la transacción (el tiempo que transcurre desde el envío hasta la inclusión en el bloque).
Las métricas son las más adecuadas para comprender tendencias y detectar anomalías. Un repunte repentino en la latencia de las RPC, un aumento gradual de la tasa de errores o una caída en el rendimiento de las solicitudes son señales de que algo ha cambiado. Las herramientas de métricas como Prometheus, Datadog y Grafana recopilan, almacenan y visualizan las métricas a lo largo del tiempo, lo que permite tanto la creación de paneles en tiempo real como el análisis de tendencias históricas.
La ventaja de las métricas es que son ligeras y agregadas, por lo que pueden recopilarse con gran frecuencia sin generar enormes volúmenes de datos. La limitación es que las métricas indican lo que está ocurriendo, pero no por qué. Sabes que la latencia ha aumentado, pero no sabes qué peticiones concretas fueron lentas ni qué provocó esa lentitud.
Registros
Los registros son entradas con marca de tiempo de eventos concretos. Cada acción relevante que realiza tu sistema, cada error que encuentra y cada decisión que toma puede registrarse como una entrada de registro. En las aplicaciones de cadena de bloques, los registros relevantes incluyen detalles de las solicitudes y respuestas RPC (método, parámetros, tiempo de respuesta, estado), eventos del ciclo de vida de las transacciones (enviadas, pendientes, confirmadas, fallidas), emisiones de eventos de contratos inteligentes (datos de eventos descodificados de tus contratos), detalles de errores (rastreo de pila, códigos de error, contexto de la solicitud) y acciones de los usuarios (conexiones a monederos, aprobaciones de transacciones, navegación por páginas).
Los registros son ideales para proporcionar los detalles necesarios para diagnosticar incidentes concretos. Cuando una métrica te avisa de que las tasas de error se han disparado, los registros te indican qué errores concretos se están produciendo, qué terminales se ven afectados y cuáles eran los parámetros de la solicitud. Las herramientas de análisis de registros, como Elasticsearch, Loki, Splunk y CloudWatch Logs, permiten buscar, filtrar y correlacionar entradas de registro entre distintos servicios y intervalos de tiempo.
La desventaja de los registros es el volumen. El registro detallado de cada llamada RPC, cada evento de transacción y cada acción del usuario genera enormes cantidades de datos. Los costes de almacenamiento de los registros pueden aumentar rápidamente, y buscar un evento concreto entre millones de entradas de registro requiere herramientas eficientes de indexación y consulta.
Huellas
Los rastros siguen el recorrido de una solicitud concreta a través de un sistema distribuido, de principio a fin. Cuando un usuario inicia un intercambio de tokens, el rastro captura cada paso: el tiempo de procesamiento del frontend, la latencia de la llamada a la API del backend, la solicitud RPC al nodo, el tiempo de procesamiento del nodo, el envío de la transacción y la confirmación final del bloque. Cada paso se registra como un «span» con una hora de inicio, una hora de finalización y metadatos. Los spans se enlazan entre sí mediante un identificador de traza, formando así una imagen completa de la ruta de la solicitud.
Los rastros son esenciales para diagnosticar problemas de rendimiento en los sistemas distribuidos
arquitecturas optimizadas. Si una transacción de intercambio tarda 8 segundos desde que el usuario hace clic hasta que aparece la confirmación, un seguimiento te muestra que 200 ms correspondieron a la representación del front-end, 100 ms al procesamiento del back-end, 500 ms a la latencia de la RPC, 12 segundos a la confirmación en cadena (que tu aplicación tuvo que esperar) y el tiempo restante a la entrega de eventos a través de WebSocket. Ahora sabes exactamente en qué se invirtió el tiempo y qué componente debes optimizar.
Las herramientas de rastreo distribuido, como Jaeger, Zipkin, Datadog APM y Honeycomb, están diseñadas para recopilar, almacenar y visualizar trazas entre distintos servicios. Resultan especialmente útiles en arquitecturas de microservicios, en las que una sola solicitud de un usuario afecta a varios servicios, bases de datos y API externas.
Por qué la observabilidad es importante para las aplicaciones de cadena de bloques
Las aplicaciones de cadena de bloques están distribuidas, por naturaleza, entre varios sistemas independientes: tu infraestructura, la infraestructura de tu proveedor de RPC y la propia red de la cadena de bloques. Esto genera un mayor riesgo de fallos y de deterioro del rendimiento que una aplicación tradicional, que solo depende de sus propios servidores y de su propia base de datos.
Los problemas relacionados con el RPC ( endpoint ) se encuentran entre los más habituales a los que se enfrentan los desarrolladores de blockchain. Un endpoint puede estar devolviendo datos obsoletos (porque el nodo subyacente va retrasado en la sincronización), respondiendo con lentitud (debido a la distancia geográfica o a la carga) o devolviendo errores (debido a la limitación de velocidad o a fallos en los nodos). Sin capacidad de observabilidad en la capa RPC, estos problemas pasan desapercibidos hasta que los usuarios se quejan.
Las condiciones de la cadena afectan a tu aplicación aunque estén fuera de tu control. La congestión de la cadena aumenta los precios del gas y los tiempos de confirmación. Las reorganizaciones de bloques pueden invalidar transacciones confirmadas recientemente. El tiempo de inactividad de los validadores en cadenas más pequeñas puede provocar retrasos en la producción de bloques. Las herramientas de observabilidad que realizan un seguimiento de las métricas a nivel de cadena, junto con las métricas de tu aplicación, te ofrecen una visión completa de lo que está afectando a tus usuarios.
¿Cuál es la diferencia entre observabilidad y monitorización?
La monitorización y la observabilidad están relacionadas, pero no son sinónimos. La monitorización supervisa un conjunto conocido de señales y te avisa cuando una de ellas supera un umbral: responde a la pregunta «¿hay algún problema?». La observabilidad es la capacidad más amplia de plantear preguntas abiertas sobre tu sistema utilizando datos detallados, de modo que puedas responder a la pregunta «¿por qué falla?», incluso en el caso de fallos que nunca habías previsto. La monitorización es un subconjunto de la observabilidad; necesitas la monitorización para detectar problemas y la observabilidad para explicarlos.
Aspecto | Seguimiento | Observabilidad |
|---|---|---|
Pregunta fundamental | ¿Pasa algo? | ¿Por qué está mal? |
Ámbito de aplicación | Señales y umbrales predefinidos | Exploración abierta del estado del sistema |
Tipos de fallos | Fallos conocidos y previstos | Fallos conocidos y desconocidos |
Datos primarios | Cuadros de mando y alertas | Métricas, registros y trazas combinados |
En la práctica, se implementan ambas cosas a la vez. En cuanto al aspecto operativo de la supervisión de los sistemas de cadena de bloques, consulta las mejores prácticas sobre supervisión de la infraestructura de cadena de bloques y gestión de alertas.
¿Cómo se complementan entre sí las métricas, los registros y los rastros?
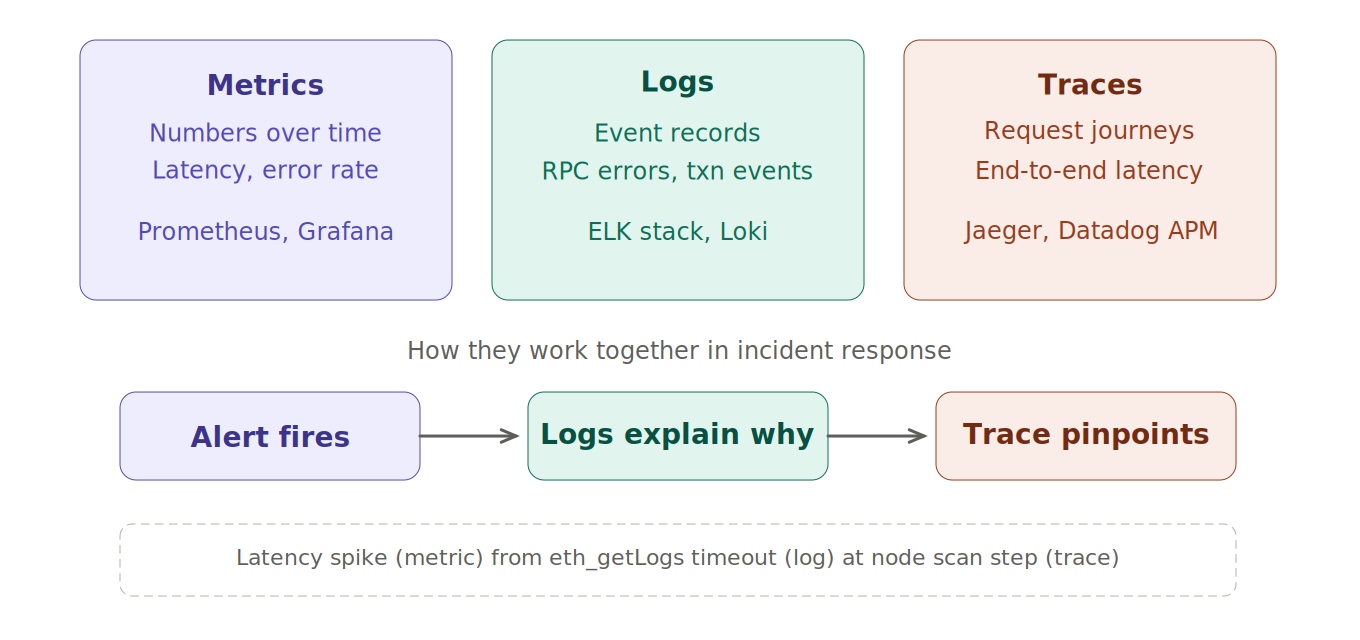
Los tres pilares son complementarios, no rivales. Las métricas indican que algo ha cambiado, los registros muestran qué ha ocurrido concretamente y los rastros señalan en qué punto de una solicitud distribuida se produjo el retraso o el error. Una práctica de observabilidad eficaz utiliza los tres: se activa una alerta basada en una métrica, un rastro delimita el problema a un servicio concreto y los registros revelan el error exacto. La tabla siguiente relaciona cada pilar con la pregunta a la que mejor responde.
Pilar | Respuestas | Ejemplo de blockchain | Herramientas habituales |
|---|---|---|---|
Métricas | ¿Qué cambió y cuándo? | La latencia de RPC se disparó a las 14:02 | Prometheus, Grafana |
Registros | ¿Qué pasó exactamente? | eth_call ha devuelto un error de tiempo de espera | Loki, Splunk |
Huellas | ¿En qué se invirtió ese tiempo? | 500 ms en el intervalo RPC | Jaeger, APM de Datadog |
Para una comparación más detallada de los pilares, consulta «Métricas, registros y trazas». El seguimiento de la latencia de las llamadas RPC como métrica de primer orden es una de las señales de mayor valor para una aplicación de cadena de bloques.
¿Cómo se consigue que la infraestructura de la cadena de bloques sea observable?
Empieza por implementar la capa RPC, ya que se encuentra entre tu aplicación y la cadena: registra el volumen de solicitudes, los percentiles de latencia y las tasas de error por método. Añade comprobaciones de estado que comparen la altura del bloque de tu nodo con la punta de la cadena para detectar a tiempo cualquier retraso en la sincronización. A continuación, vincula las alertas a las señales que realmente predicen problemas para los usuarios y diseña el sistema pensando en la resiliencia, de modo que un único fallo no te impida ver el panorama general. Combina la observabilidad con nodos fiables, alta disponibilidad y una ruta de conmutación por error probada, para que, cuando algo falle, puedas detectarlo y desviar el tráfico por otra vía.
Preguntas frecuentes
¿La observabilidad es lo mismo que la monitorización?
No. La monitorización supervisa señales predefinidas y te avisa cuando algo supera un umbral, mientras que la observabilidad te proporciona datos suficientes para investigar cualquier problema, incluidos los fallos que no habías previsto. La monitorización es solo una parte de una práctica más amplia de observabilidad.
¿Cuáles son los tres pilares de la observabilidad?
Métricas, registros y trazas. Las métricas son mediciones numéricas a lo largo del tiempo; los registros son entradas con marca de tiempo de eventos concretos; y las trazas siguen el recorrido de una única solicitud a través de un sistema distribuido. En conjunto, te permiten detectar, explicar y localizar problemas.
¿Por qué resulta más difícil la observabilidad en las aplicaciones de cadena de bloques?
Las aplicaciones de blockchain abarcan tu propia infraestructura, un proveedor de RPC externo y la propia cadena, por lo que los fallos pueden tener su origen en capas que no controlas. Esa mayor superficie de exposición implica que necesitas visibilidad en todas las capas, incluidas las condiciones a nivel de la cadena, como la congestión y las reorganizaciones.
¿Qué métricas son las más importantes para la infraestructura RPC?
La latencia de respuesta, el volumen de solicitudes, la tasa de errores y la diferencia en la altura del bloque son los indicadores clave. La latencia y los errores revelan el estado de un endpoint , el volumen de solicitudes muestra la carga y la diferencia en la altura del bloque indica si el nodo se mantiene al día con la punta de la cadena.
¿Necesito herramientas distintas para cada pilar?
No necesariamente. Muchas plataformas abarcan más de un pilar, y los proveedores suelen ofrecer exportadores de métricas y análisis RPC que se pueden integrar en una infraestructura ya existente. El objetivo es lograr una visibilidad unificada en todas las capas de la aplicación y de la cadena de bloques, más que contar con un número concreto de herramientas.
Cómo « Quicknode » contribuye a la observabilidad
Quicknode Ofrece funciones de observabilidad integradas para la capa de infraestructura de la cadena de bloques. El panel de control de Quicknode incluye análisis en tiempo real que muestran el volumen de solicitudes, la latencia de respuesta, las tasas de error y desgloses por métodos para cada endpoint. Esto proporciona a los desarrolladores una visibilidad inmediata de sus patrones de uso de RPC sin necesidad de implementar su propio sistema de monitorización.
Para los equipos que ya cuentan con soluciones de observabilidad stacks, Quicknode ofrece Clústeres de xml-ph-0001@deepl.internal son compatibles con Prometheus Exporter, lo que te permite extraer métricas a nivel de nodo directamente a tus paneles de Grafana, Datadog o cualquier sistema de monitorización compatible con Prometheus. Esto permite una observabilidad unificada de tu infraestructura de aplicaciones y tu infraestructura de blockchain en un único panel de control.
Quicknode Streams Aporta observabilidad a tu capa de canalización de datos, proporcionando información sobre el estado de entrega, métricas de procesamiento e informes de errores para cada Stream. En combinación con el panel de análisis de RPC, esto ofrece a los desarrolladores una visibilidad completa tanto de su acceso a la API en tiempo real como de la ingesta de datos en streaming.
Lecturas recomendadas
Métricas, registros y trazas - Documentación de Quicknode
Supervisión de la infraestructura de blockchain - Quicknode Glosario
Quicknode API principal
Quicknode Dedicado Clústeres