En resumen: Las cadenas de bloques se ralentizan cuando la demanda de espacio en los bloques supera la capacidad de procesamiento de la red. Las causas más comunes son la congestión de la red (demasiadas transacciones que compiten por una capacidad limitada de los bloques), el «estado inflado» (requisitos de almacenamiento cada vez mayores que aumentan el coste computacional del procesamiento de cada bloque), la sobrecarga del consenso (costes de comunicación que aumentan proporcionalmente al número de validadores) y las limitaciones de la infraestructura (nodos lentos, puntos finales RPC de alta latencia y flujos de datos ineficientes). Las ralentizaciones se manifiestan en forma de tiempos de confirmación más largos, comisiones más elevadas, datos obsoletos en las aplicaciones y una experiencia de usuario deteriorada. Algunas causas son inherentes al diseño de la cadena de bloques, mientras que otras pueden mitigarse con una mejor infraestructura.
La explicación sencilla
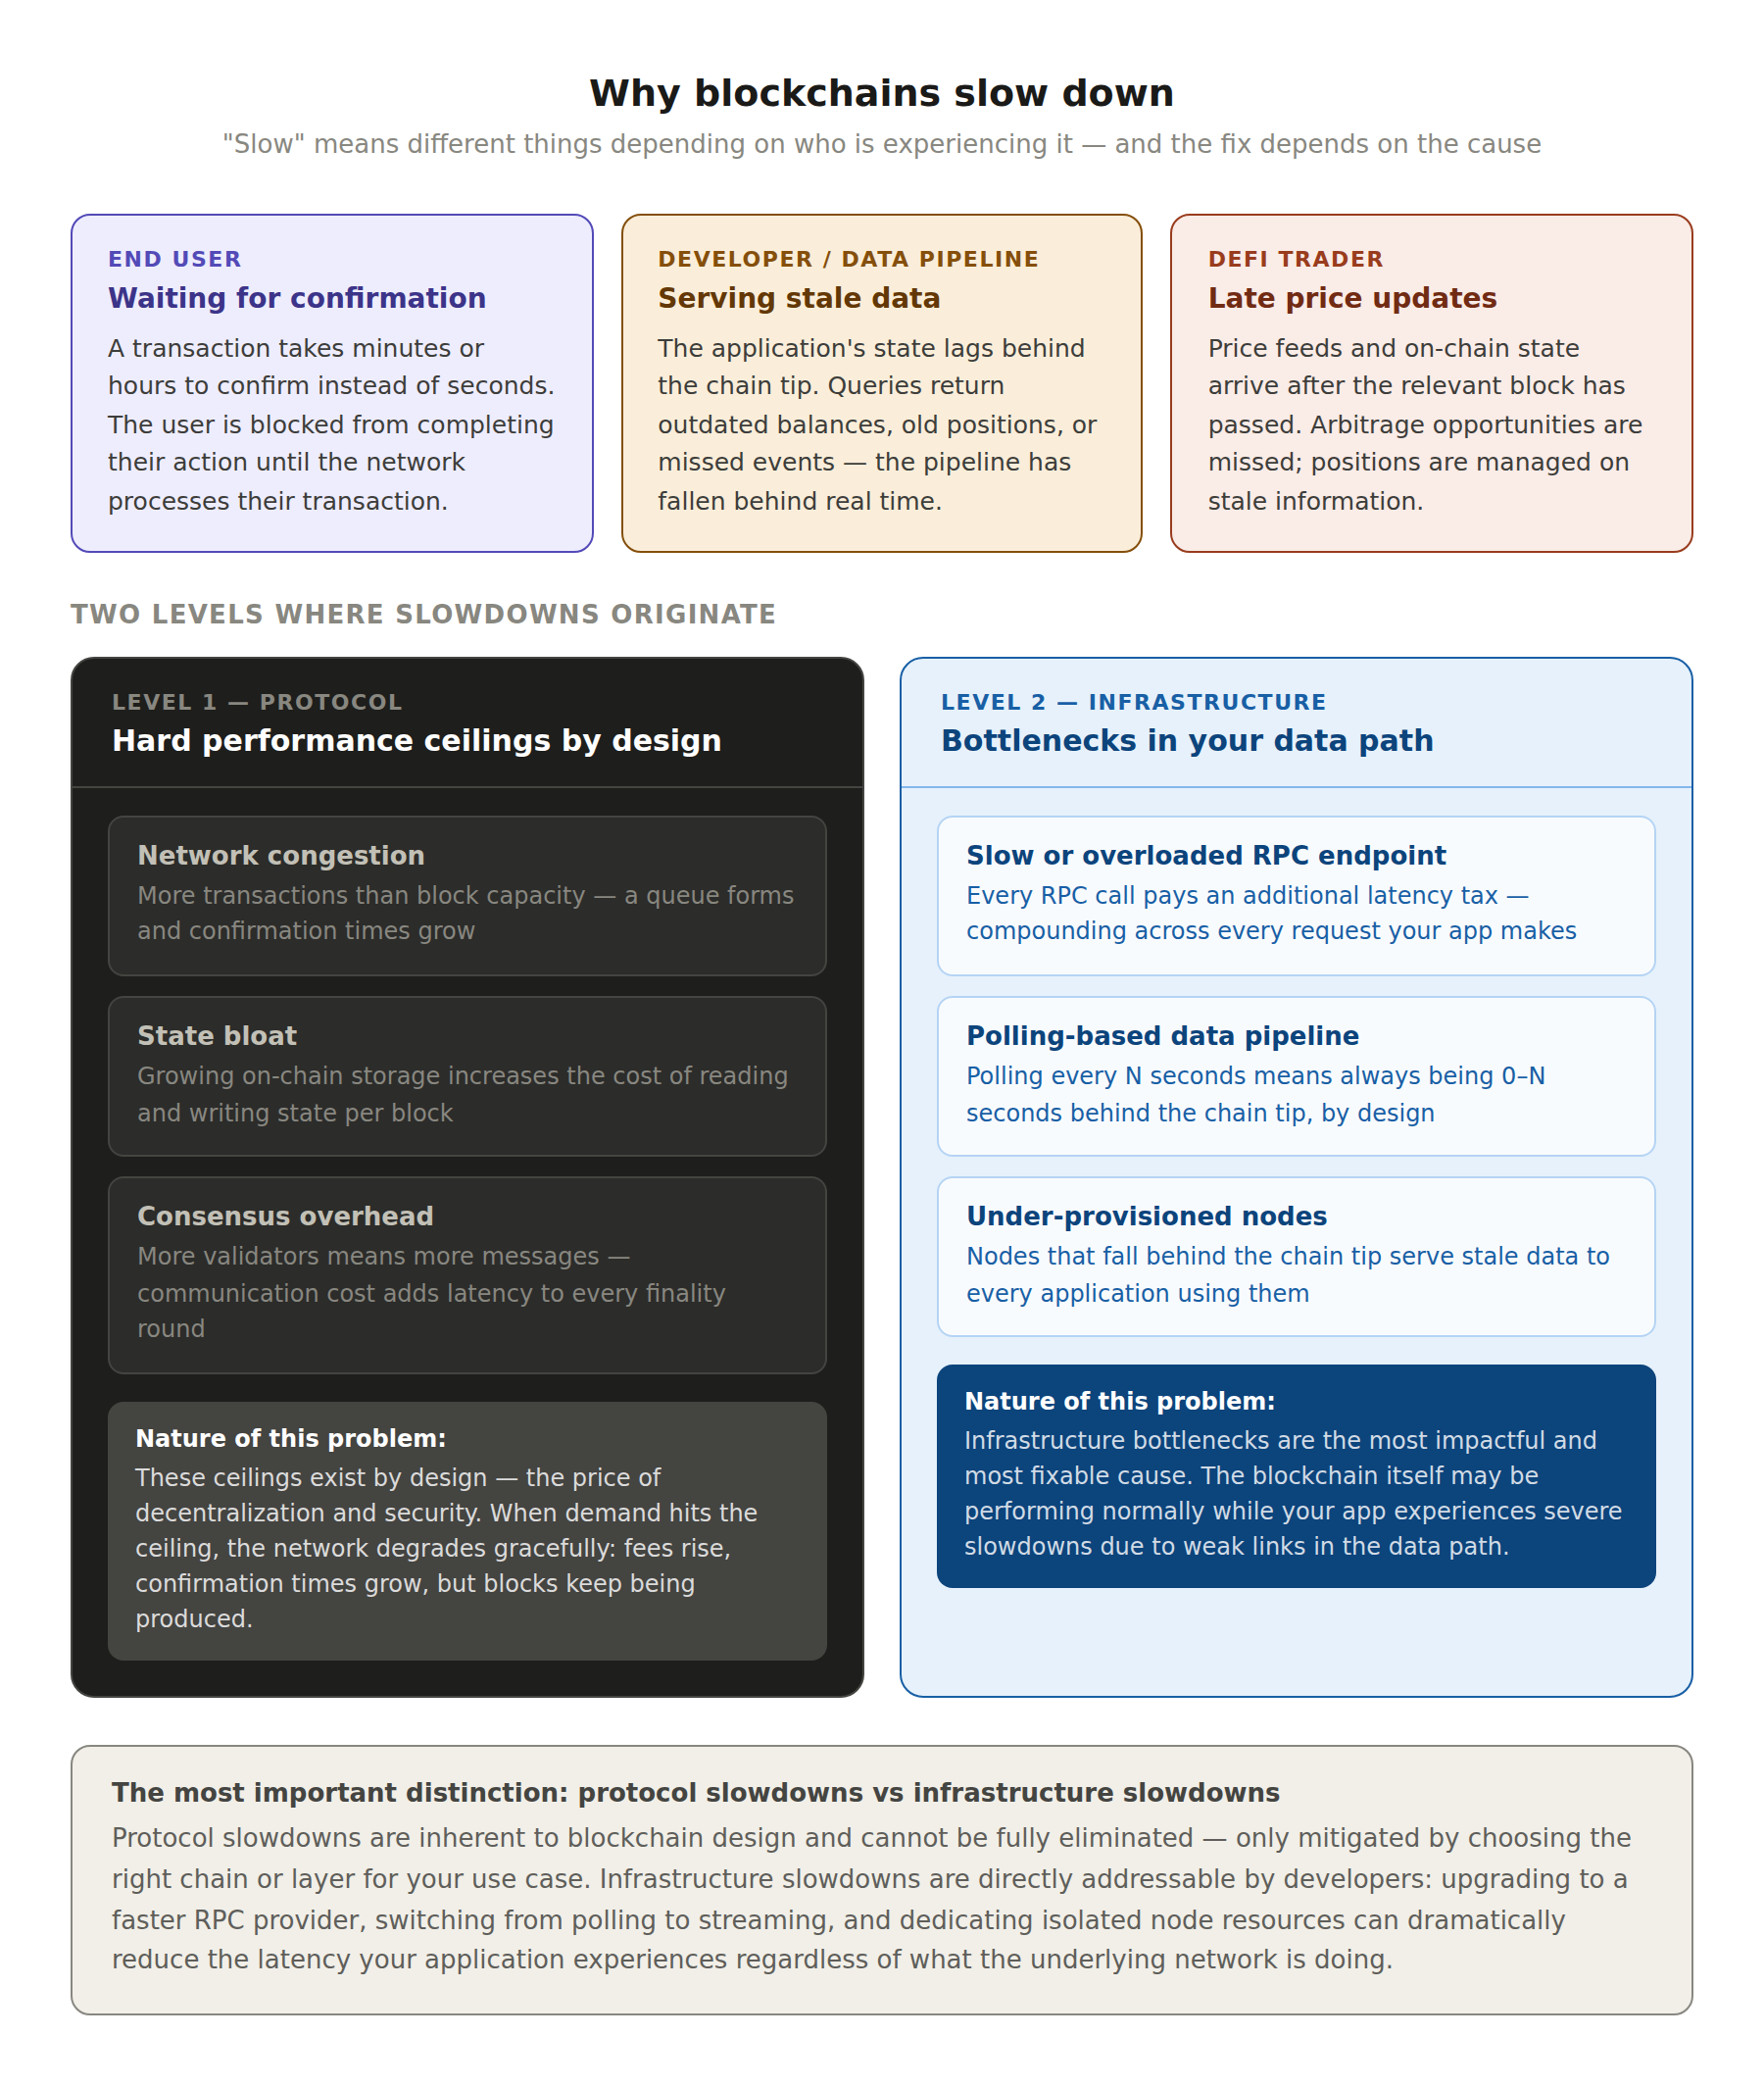
«Lento» significa cosas diferentes según quién lo pregunte. Para un usuario final que envía una transacción, «lento» significa tener que esperar minutos u horas para obtener la confirmación, en lugar de segundos. Para un desarrollador que gestiona un flujo de datos, «lento» significa quedarse rezagado respecto a la punta de la cadena y proporcionar datos obsoletos. Para un operador de DeFi, «lento» significa recibir las actualizaciones de precios con retraso y perder oportunidades de arbitraje. Cada tipo de ralentización tiene causas fundamentales y soluciones diferentes.
A nivel de protocolo, las cadenas de bloques tienen límites máximos de rendimiento fijos determinados por su mecanismo de consenso, los parámetros de los bloques y el entorno de ejecución. Estos límites existen por diseño, no por casualidad. Son el precio que hay que pagar por la descentralización y la seguridad. Cuando la demanda se topa con estos límites, la red no se colapsa. Se degrada de forma controlada aumentando las comisiones (lo que excluye a las transacciones de menor valor) y alargando los tiempos de confirmación (lo que hace que los usuarios tengan que esperar más). Pero desde la perspectiva del usuario, esa «degradación gradual» sigue pareciendo lenta.
A nivel de infraestructura, es posible que la propia cadena de bloques funcione con normalidad, pero las herramientas que utiliza tu aplicación para interactuar con ella pueden constituir el cuello de botella. Un RPC endpoint lento o sobrecargado añade latencia a cada solicitud. Un canal de datos basado en sondeos introduce retrasos entre la producción de bloques y la disponibilidad de los datos. Un nodo con recursos insuficientes se queda rezagado respecto a la punta de la cadena. Estas ralentizaciones a nivel de infraestructura suelen tener un mayor impacto (y son más fáciles de solucionar) que las que se producen a nivel de protocolo.
Causa | ¿Qué ocurre? | ¿Quién puede ocuparse de ello? |
|---|---|---|
Congestión de la red | La demanda supera la capacidad de los bloques, por lo que aumentan las comisiones y los tiempos de espera | Usuarios (tarifas) y diseño de la aplicación |
Exceso de gasto público | El aumento del tamaño del estado eleva el coste de procesar cada bloque | Desarrolladores del protocolo y del núcleo |
Coste adicional del consenso | La comunicación con los validadores añade una latencia inevitable | Diseño del protocolo |
Cuellos de botella en las infraestructuras | El RPC lento, el sondeo y los nodos distantes aumentan el retraso | Desarrolladores, directamente |
Congestión de la red
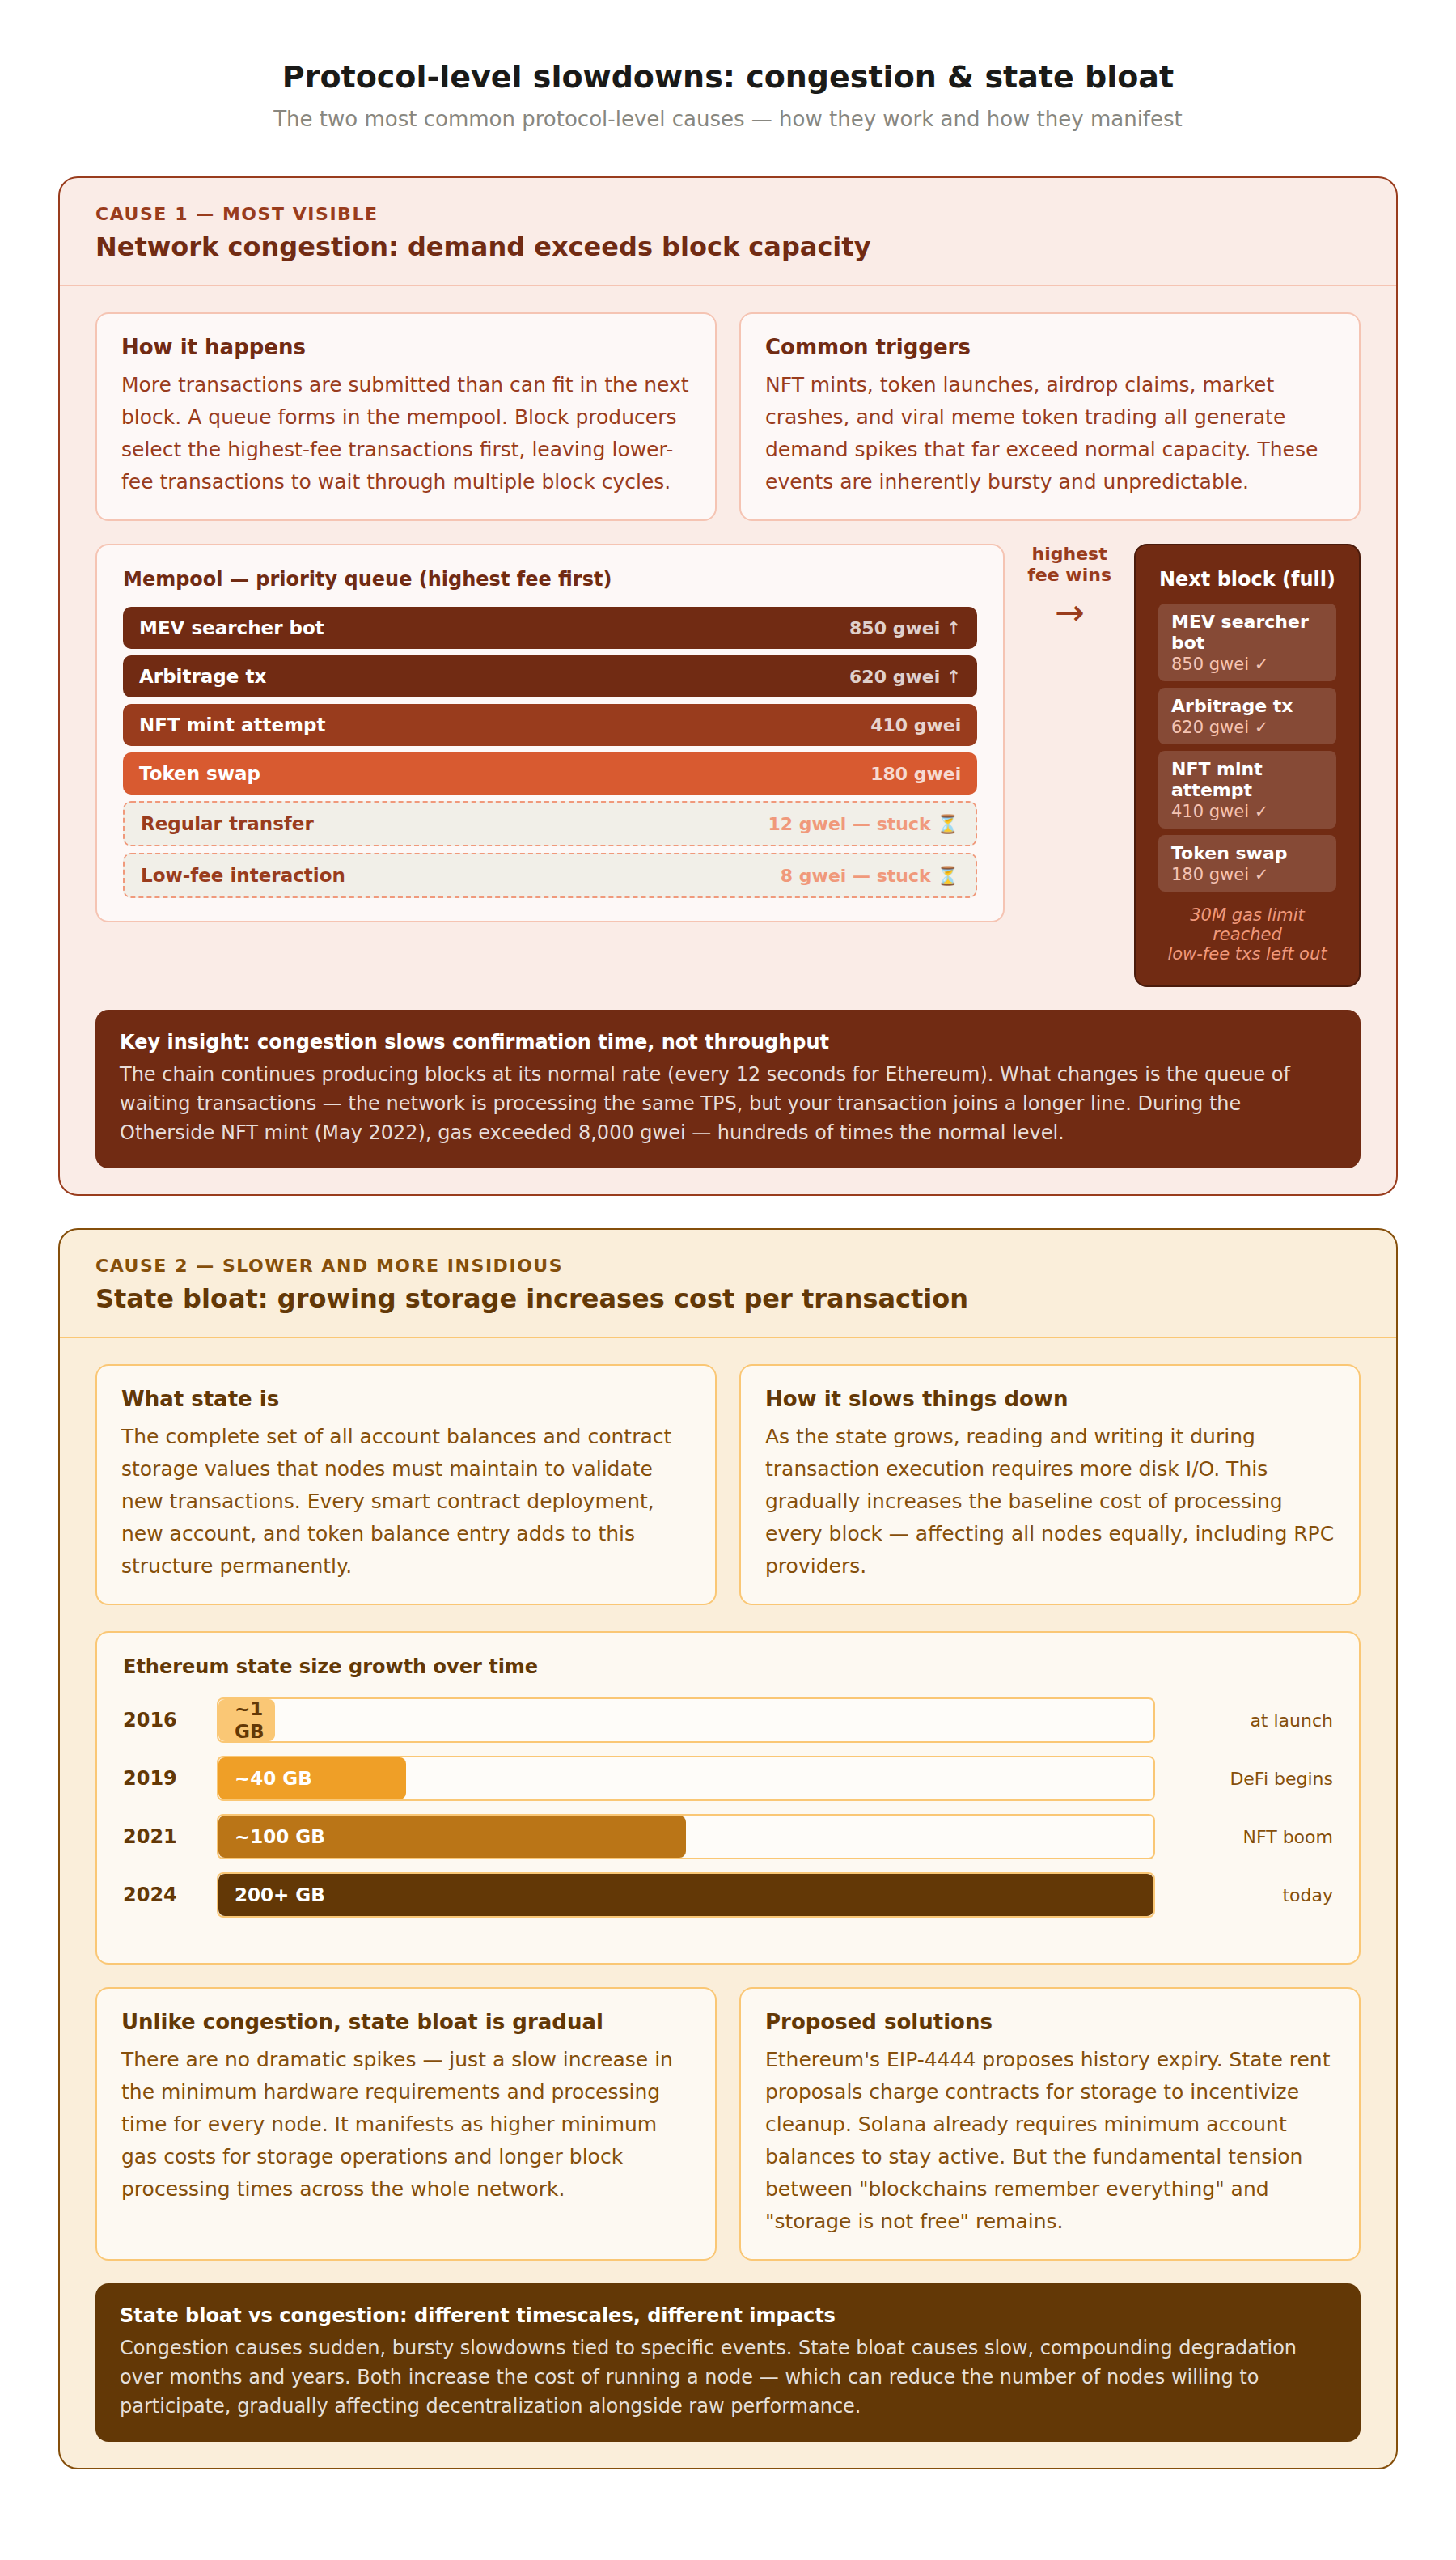
La congestión de la red es la causa más habitual y más visible de las ralentizaciones de la cadena de bloques. Cuando se envían más transacciones de las que caben en el siguiente bloque, se acumulan en el mempool. Los productores de bloques seleccionan primero las transacciones con comisiones más altas, dejando en espera a las que tienen comisiones más bajas. Durante una congestión grave, el mempool puede contener cientos de miles de transacciones pendientes, con tiempos de confirmación que pueden oscilar entre segundos y horas.
La congestión es, por naturaleza, intermitente. La mayor parte del tiempo, las blockchains más populares funcionan muy por debajo de sus límites de capacidad, y las transacciones se confirman rápidamente a bajo coste. Sin embargo, hay eventos concretos que provocan picos de demanda que desbordan la red. Las acuñaciones de NFT, los lanzamientos de tokens, las reclamaciones de airdrops, las caídas del mercado y el comercio viral de tokens meme generan oleadas de transacciones que superan con creces los niveles normales. Durante la emisión de «Otherside» de Yuga Labs en mayo de 2022, los precios del gas en Ethereum superaron los 8.000 gwei, cientos de veces por encima del nivel habitual.
La idea clave es que la congestión ralentiza la confirmación de las transacciones individuales, pero no reduce el rendimiento de la red. La cadena sigue generando bloques a su ritmo habitual (cada 12 segundos en Ethereum, cada 400 ms en Solana). Lo que cambia es el tiempo de espera hasta que una transacción se incluye en un bloque. La red procesa el mismo número de transacciones por segundo; lo que crece es la cola de transacciones en espera.
Exceso de gasto público
La sobrecarga del estado es una forma más lenta y insidiosa de degradación de la cadena de bloques. Cada implementación de un contrato inteligente, cada nueva cuenta y cada entrada de saldo de un token se suma al estado de la cadena de bloques, es decir, al conjunto de todos los saldos actuales de las cuentas y los valores almacenados en los contratos que los nodos deben mantener en memoria o en disco para validar nuevas transacciones. A medida que el estado crece, aumenta el coste computacional de leer y escribir el estado durante la ejecución de las transacciones.
En Ethereum, el árbol trie de estado ha pasado de ser prácticamente inexistente en el momento del lanzamiento a alcanzar cientos de gigabytes. Cada transacción que lee o escribe el estado debe atravesar esta estructura de datos y, cuanto más grande se vuelve, mayor es la E/S de disco que requiere cada operación. Esto afecta por igual a todos los nodos, incluidos los gestionados por proveedores de RPC. La sobrecarga del estado no provoca ralentizaciones drásticas y repentinas como lo hace la congestión. En cambio, aumenta gradualmente el coste básico del procesamiento de cada bloque, lo que puede traducirse en tiempos de procesamiento de bloques ligeramente más largos, mayores costes mínimos de gas para las operaciones de acceso al estado y mayores requisitos de hardware para ejecutar los nodos.
Varias cadenas han implementado o propuesto soluciones para la gestión del estado. La propuesta EIP-4444 de Ethereum propone la caducidad del historial (eliminar los datos de bloques antiguos de los nodos completos). Las propuestas de «alquiler del estado» cobrarían a los contratos por el almacenamiento que consumen, lo que incentivaría la limpieza. El sistema de «alquiler de cuentas» de Solana ya exige unos saldos mínimos para que las cuentas permanezcan activas. Estos enfoques intentan gestionar el crecimiento del estado, pero persiste la tensión fundamental entre «las cadenas de bloques lo recuerdan todo» y «el almacenamiento no es gratuito».
Gastos generales de consenso
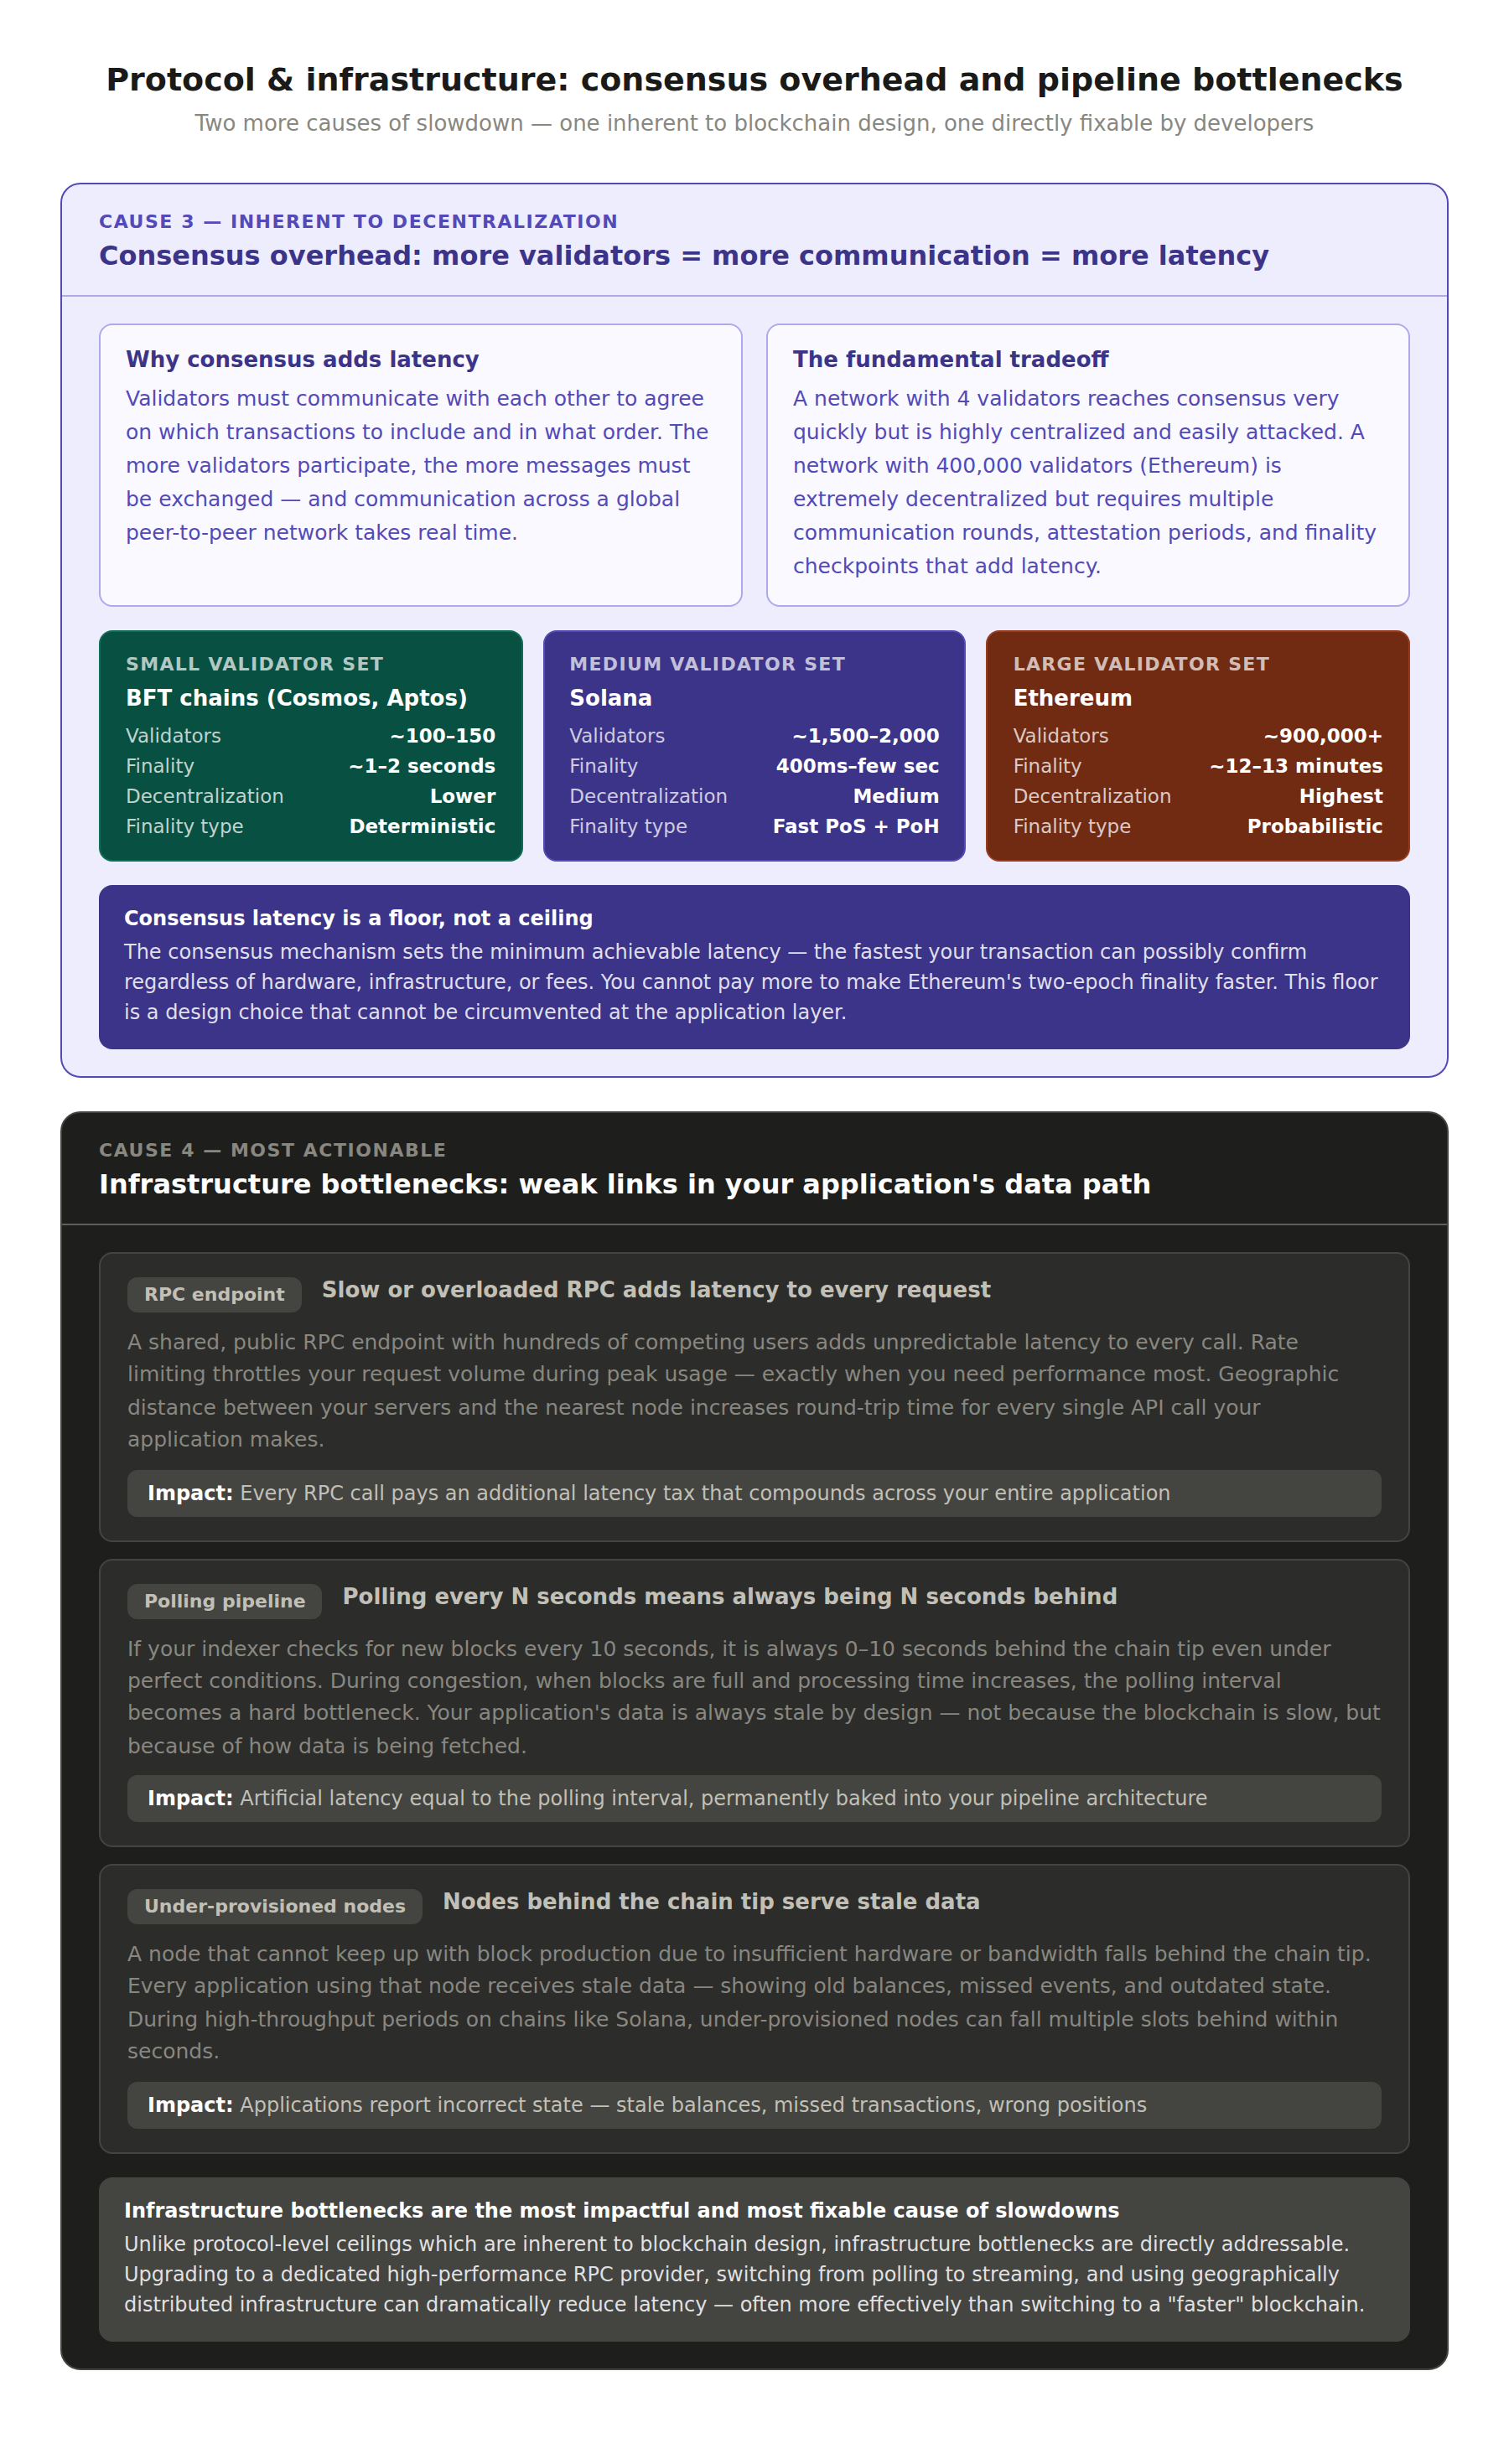
El mecanismo de consenso es el proceso mediante el cual los validadores acuerdan qué transacciones se incluirán en el siguiente bloque y en qué orden. Este proceso añade latencia de forma inherente, ya que los validadores deben comunicarse entre sí y la comunicación lleva tiempo. Cuantos más validadores participen en el consenso, más mensajes deberán intercambiarse y más tiempo tardará en alcanzarse el consenso.
Esta es una de las dimensiones del trilema de la cadena de bloques. Una red con 4 validadores puede alcanzar el consenso muy rápidamente (baja latencia), pero está muy centralizada. Una red con 400 000 validadores (como Ethereum) presenta un alto grado de descentralización, pero requiere un protocolo de consenso sofisticado con múltiples rondas de comunicación, períodos de certificación y puntos de control de finalidad que añaden varios minutos de latencia entre la inclusión del bloque y su finalidad.
Algunas cadenas utilizan un consenso basado en un líder, en el que un único validador propone un bloque y los demás lo validan, lo que reduce la sobrecarga de comunicación pero introduce un único punto de latencia (el líder). Otras utilizan un consenso basado en comités, en el que un subconjunto de validadores seleccionado al azar se encarga del consenso para cada intervalo, equilibrando la descentralización con la velocidad. La elección del mecanismo de consenso determina directamente el umbral mínimo de latencia de la red, es decir, el tiempo mínimo entre el envío de una transacción y su finalización, que no puede reducirse independientemente de la velocidad del hardware subyacente.
Cuellos de botella en las infraestructuras
Para la mayoría de los desarrolladores, las ralentizaciones que experimentan en su día a día no se producen en absoluto a nivel de protocolo, sino a nivel de infraestructura. La velocidad percibida de la cadena de bloques de tu aplicación viene determinada por el eslabón más débil de su ruta de datos: el RPC endpoint al que se conecta, el canal de datos que alimenta su base de datos y la lógica de procesamiento que transforma los datos brutos de la cadena de bloques en el estado de la aplicación.
Un RPC endpoint público y compartido, en el que cientos de usuarios compiten por la capacidad, añade una latencia impredecible a cada solicitud. La limitación de tasa restringe el volumen de solicitudes durante los picos de uso, precisamente cuando más lo necesitas. La distancia geográfica entre los servidores de tu aplicación y el nodo más cercano aumenta el tiempo de ida y vuelta de cada llamada. Un nodo con recursos insuficientes que se queda rezagado respecto a la punta de la cadena sirve datos obsoletos, lo que hace que el estado de tu aplicación vaya por detrás de la realidad.
Los flujos de datos basados en sondeos introducen una latencia artificial equivalente al intervalo de sondeo. Si tu indexador comprueba si hay nuevos bloques cada 10 segundos, siempre irá con un retraso de entre 0 y 10 segundos respecto a la punta de la cadena, incluso en condiciones ideales. Durante los picos de tráfico, cuando los bloques están llenos y el tiempo de procesamiento aumenta, el intervalo de sondeo se convierte en el cuello de botella que impide que tu aplicación se mantenga al día.
Estos cuellos de botella en la infraestructura son la causa más fácil de resolver de las ralentizaciones de la cadena de bloques, ya que son los únicos que los desarrolladores pueden abordar directamente. Actualizar a un proveedor de RPC dedicado y de alto rendimiento reduce la latencia de « endpoint ». Pasar del sondeo al streaming elimina los retrasos artificiales en el canal. El uso de una infraestructura distribuida geográficamente reduce los tiempos de ida y vuelta. Dedicar recursos de nodos aislados elimina los efectos de «vecinos ruidosos».
Cómo aborda « Quicknode » las ralentizaciones de la cadena de bloques
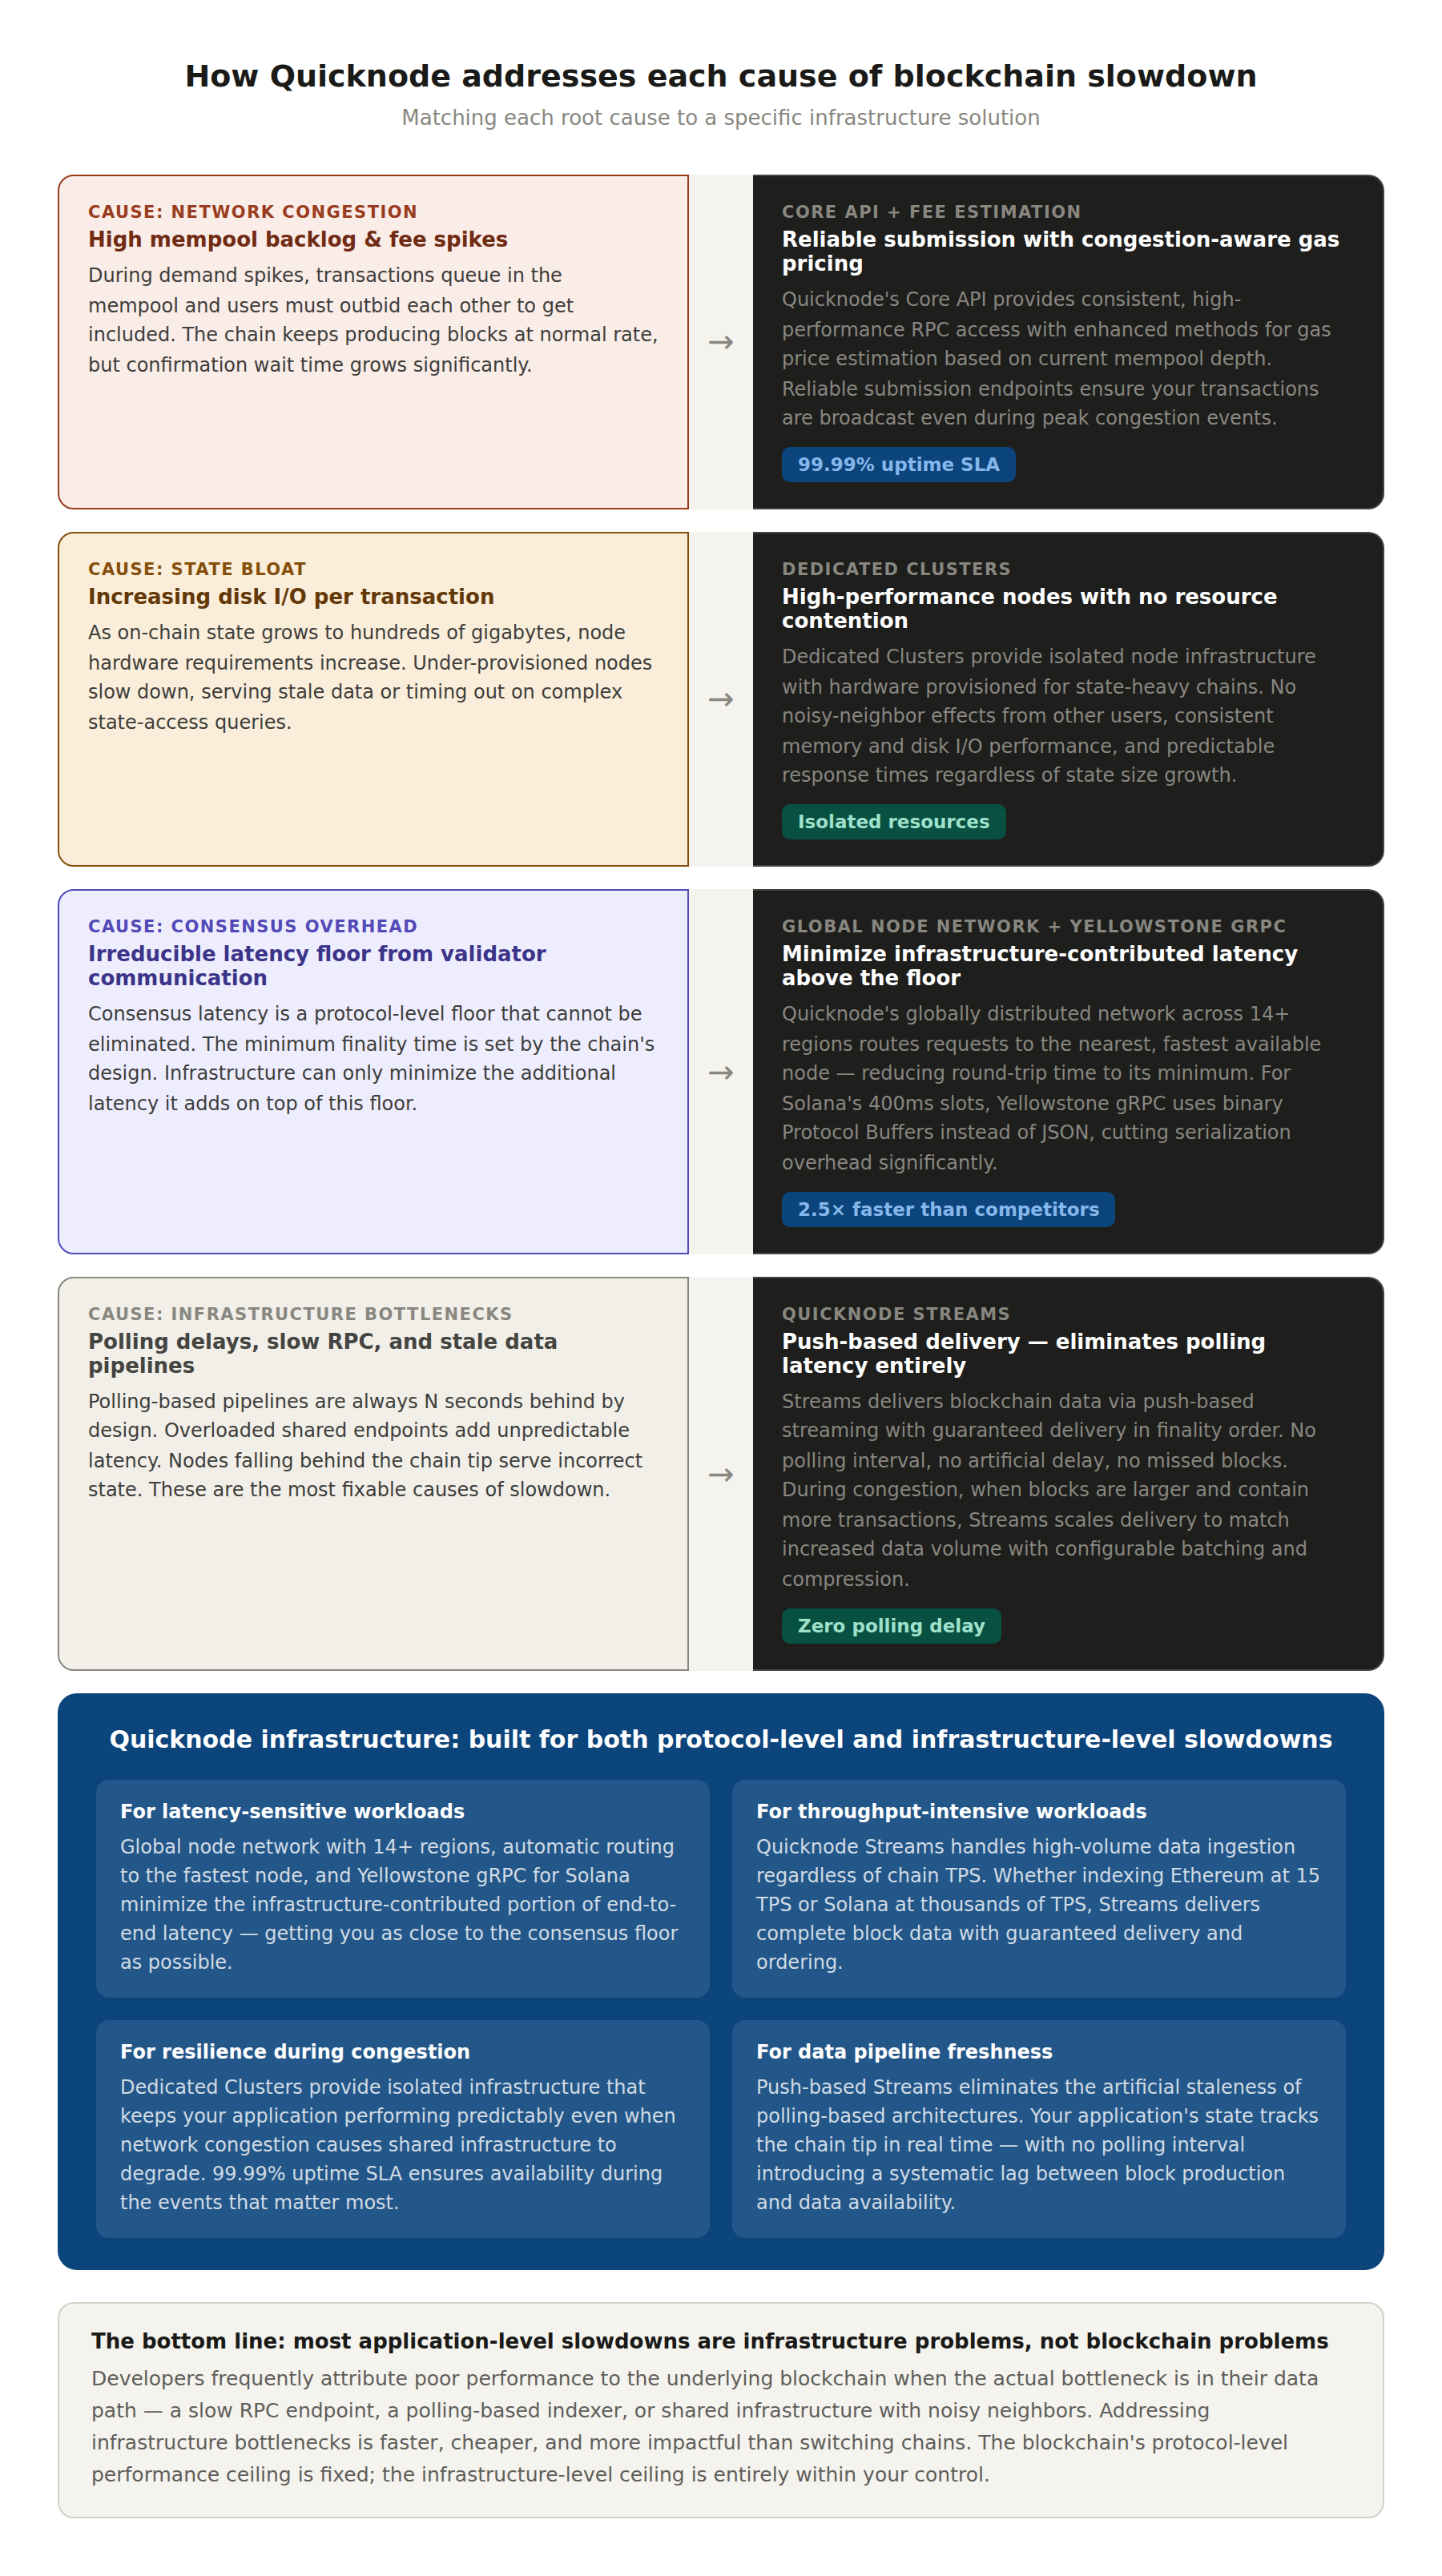
QuicknodeLa infraestructura de está diseñada para minimizar o eliminar los cuellos de botella a nivel de infraestructura que provocan ralentizaciones en las aplicaciones de blockchain. La API Core se ejecuta en una red distribuida a nivel mundial que abarca más de 14 regiones y más de 5 proveedores de nube, y redirige automáticamente las solicitudes al nodo disponible más cercano y más rápido. Los tiempos de respuesta son, de media, 2,5 veces más rápidos que los de la competencia, con acuerdos de nivel de servicio (SLA) que garantizan un tiempo de actividad del 99,99 %, lo que asegura una disponibilidad constante incluso durante episodios de congestión de la red. Proporciona Clústeres proporcionan una infraestructura aislada que elimina los efectos de «vecinos ruidosos», lo que ofrece a las aplicaciones sensibles a la latencia un rendimiento predecible, independientemente de lo que estén haciendo otros usuarios.
Quicknode Streams Elimina por completo el cuello de botella de las consultas al entregar los datos de la cadena de bloques mediante una transmisión basada en notificaciones push con entrega garantizada en orden de finalidad. No hay intervalos de consulta, ni retrasos artificiales, ni riesgo de perder bloques. Durante los picos de congestión, cuando los bloques son más grandes y contienen más transacciones, Streams adapta su capacidad de entrega para ajustarse al mayor volumen de datos. El procesamiento por lotes y la compresión configurables optimizan el rendimiento para la recuperación de datos históricos y cadenas de gran volumen. Para Solana, QuicknodeYellowstone gRPC ofrece el acceso a datos con la menor latencia disponible, utilizando Protocol Buffers binarios en lugar de JSON para minimizar la sobrecarga de serialización en una cadena en la que cada milisegundo cuenta.
¿Cuál es la diferencia entre una cadena de bloques lenta y una dapp lenta?
Para el usuario, ambas situaciones se perciben igual, pero tienen causas diferentes. Una cadena de bloques lenta es un problema de protocolo: la congestión, el tiempo de consenso o el tamaño del estado limitan la velocidad a la que la red confirma las transacciones. Una dapp lenta suele ser un problema de infraestructura: la cadena funciona bien, pero un endpoint lejano o sobrecargado añade un retraso adicional. Comparar el rendimiento con la latencia es la forma más clara de determinar a cuál de los dos casos te enfrentas realmente.
Aspecto | Nivel de protocolo | Nivel de infraestructura |
|---|---|---|
Fuente | Consenso, límites de bloque, tamaño del estado | RPC endpoint, canalización de datos, ubicación de los nodos |
¿Quién lo controla? | Los desarrolladores de red y del núcleo | Tú, el desarrollador |
¿Hasta qué punto se puede solucionar? | Es complicado, hay que actualizar los protocolos | Es fácil: cambia de proveedor o de plan. |
¿Qué provoca los picos repentinos de congestión en la cadena de bloques?
La congestión es intermitente, más que constante. Los lanzamientos de tokens, las acuñaciones de NFT, las reclamaciones de airdrops, las caídas del mercado y las operaciones virales inundan la red de transacciones en un breve periodo de tiempo, y las comisiones se disparan a medida que los usuarios pujan por un espacio limitado en los bloques. Comprender qué provoca la congestión de la cadena de bloques te ayuda a prepararte para estos eventos en lugar de que te pillen por sorpresa.
¿Cómo reducen las redes de capa 2 y el escalado las ralentizaciones?
Las redes de capa 2 trasladan la mayoría de las transacciones fuera de la cadena base y las liquidan por lotes, lo que aumenta considerablemente el rendimiento y reduce las comisiones de las operaciones cotidianas. Ejecutar tu aplicación en una cadena de bloques de capa 2 es una de las formas más eficaces de evitar la congestión de la capa base, al tiempo que se mantiene la seguridad de la red subyacente.
¿Qué problemas de lentitud pueden solucionar realmente los desarrolladores?
Los límites a nivel de protocolo escapan en su mayor parte a tu control, pero las ralentizaciones de la infraestructura no. Puedes cambiar a un proveedor más rápido, situar los nodos más cerca de tus usuarios y sustituir el sondeo por una entrega basada en notificaciones push. El simple hecho de pasar del sondeo a la transmisión en continuo elimina el retraso artificial inherente a los flujos de trabajo basados en intervalos.
Preguntas frecuentes
¿Significa la congestión que la cadena de bloques está procesando menos transacciones?
No. La cadena sigue generando bloques a su ritmo habitual y procesando el mismo volumen de transacciones. Lo que aumenta durante la congestión es la cola de transacciones pendientes, por lo que las confirmaciones individuales tardan más en completarse y las comisiones suben.
¿La descentralización ralentiza las cadenas de bloques?
Sí, es posible. Un mayor número de validadores implica una mayor comunicación para alcanzar un acuerdo, lo que aumenta la latencia básica. Esta relación entre velocidad y descentralización se analiza en detalle en el apartado «Descentralización frente a rendimiento».
¿Puede un proveedor de RPC más rápido solucionar el problema de una aplicación lenta?
A menudo, sí. Si la cadena funciona correctamente pero tu dapp parece lenta, el cuello de botella suele ser tu endpoint. Reducir la latencia del RPC con un proveedor más cercano y dedicado puede eliminar la mayor parte del retraso que perciben tus usuarios.
¿Es la sobrecarga de estado algo que puedo resolver como desarrollador?
No directamente. La sobrecarga del estado es un problema a nivel de protocolo que se gestiona mediante actualizaciones como la caducidad del historial y el alquiler de cuentas. Puedes reducir su impacto almacenando en caché los datos que requieren muchas lecturas y evitando el almacenamiento innecesario en la cadena en tus contratos.
¿Por qué suben las comisiones cuando la cadena de bloques se ralentiza?
El espacio en los bloques es limitado, por lo que, cuando la demanda se dispara, los usuarios ofrecen comisiones más altas para que sus transacciones se incluyan antes. Las comisiones más altas constituyen el mecanismo de equilibrio del mercado que determina qué transacciones se incluyen en el siguiente bloque.
Lecturas recomendadas
QuickLee - Herramienta de evaluación comparativa de la latencia en blockchain
Guía para realizar solicitudes RPC eficientes - Quicknode
Introducción a Streams - Quicknode Documentación
Quicknode Dedicado Clústeres